
熊猫将两个表中的数据转换为第三个表。交叉引用和将唯一行转换为列
熊猫将两个表中的数据转换为第三个表。交叉引用和将唯一行转换为列
提问于 2021-05-06 15:04:29
我有以下表格:
表A
listData = {'id':[1,2,3],'date':['06-05-2021','07-05-2021','17-05-2021']}
pd.DataFrame(listData,columns=['id','date'])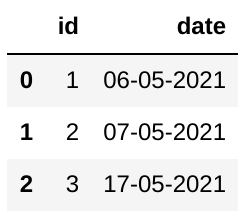
表B
detailData = {'code':['D123','F268','A291','D123','F268','A291'],'id':['1','1','1','2','2','2'],'stock':[5,5,2,10,11,8]}
pd.DataFrame(detailData,columns=['code','id','stock'])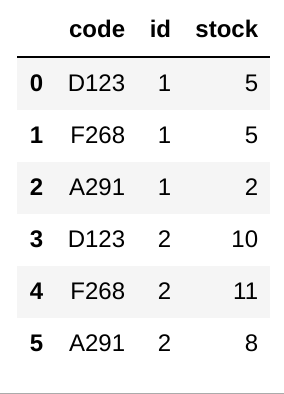
输出表
output = {'code':['D123','F268','A291'],'06-05-2021':[5,5,2],'07-05-2021':[10,11,8]}
pd.DataFrame(output,columns=['code','06-05-2021','07-05-2021'])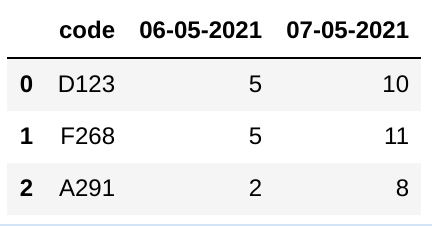
注意:提供的代码是输出的硬编码代码。我需要从表A和表B生成输出表
如果输出表不是不言自明的,那么下面简要说明它是如何生成的。
- id列需要从表A交叉引用到表B,日期应该放在表B、
、
- 中,然后表B中的所有唯一日期都应该变成列,相应的库存值需要移到新创建的日期列中。
我不知道从哪里开始这样做。我对熊猫很陌生,我只用它做简单的数据处理。如果有人能建议我从哪里开始,这将有很大的帮助。
回答 1
Stack Overflow用户
回答已采纳
发布于 2021-05-06 15:53:49
尝试:
tableA['id'] = tableA['id'].astype(str)
tableB.merge(tableA, on='id').pivot('code', 'date', 'stock')
输出:
date  06-05-2021  07-05-2021
code
A291           2           8
D123           5          10
F268           5          11
详细信息:
- First,
mergeon id,这就像执行SQL一样。首先,d类型非常匹配,因此接下来使用astype对str. - 进行数据重组,使用
pivot按日期获取代码。
。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/67420832
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号