
BeautifulSoup网页在点击按钮后获取信息的网页
因此,我正试图为几家餐馆获得Yelp页面中的“便利设施和更多”部分。问题是,我可以从餐厅的yelp页面获得首先显示的便利设施。然而,它有"n更多“按钮,当点击提供更多的便利。在网页url中使用BeautifulSoup和selenium,对请求使用BeautifulSoup,结果是完全相同的,在我的代码中获取它们之前,我一直在考虑如何打开所有的便利设施。下面的两张图片显示了按钮点击前后发生的情况。
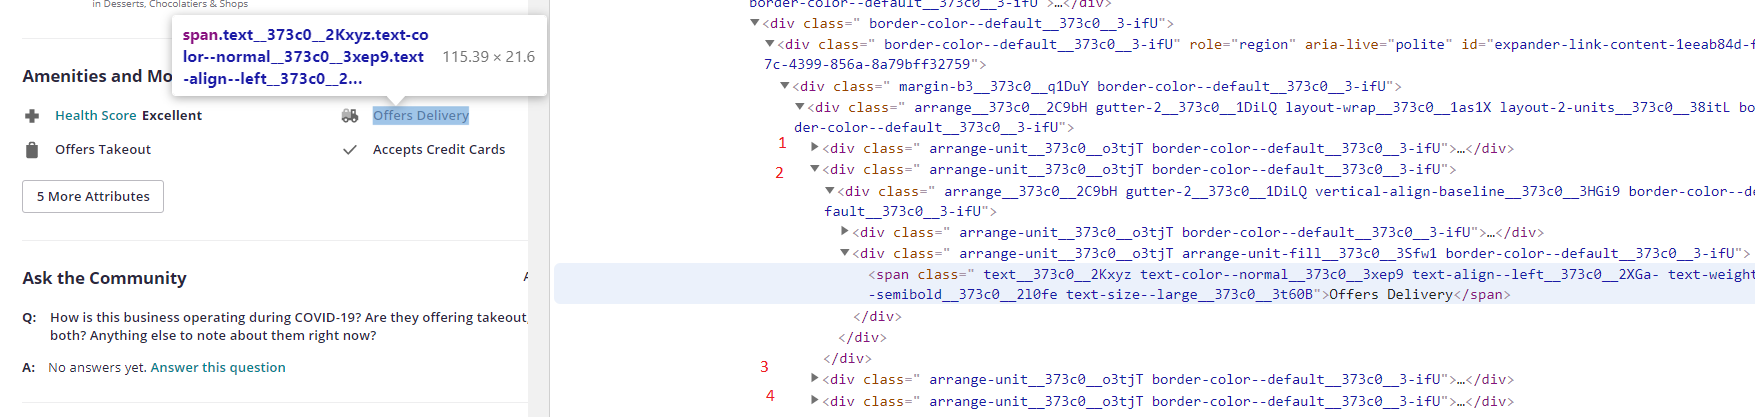
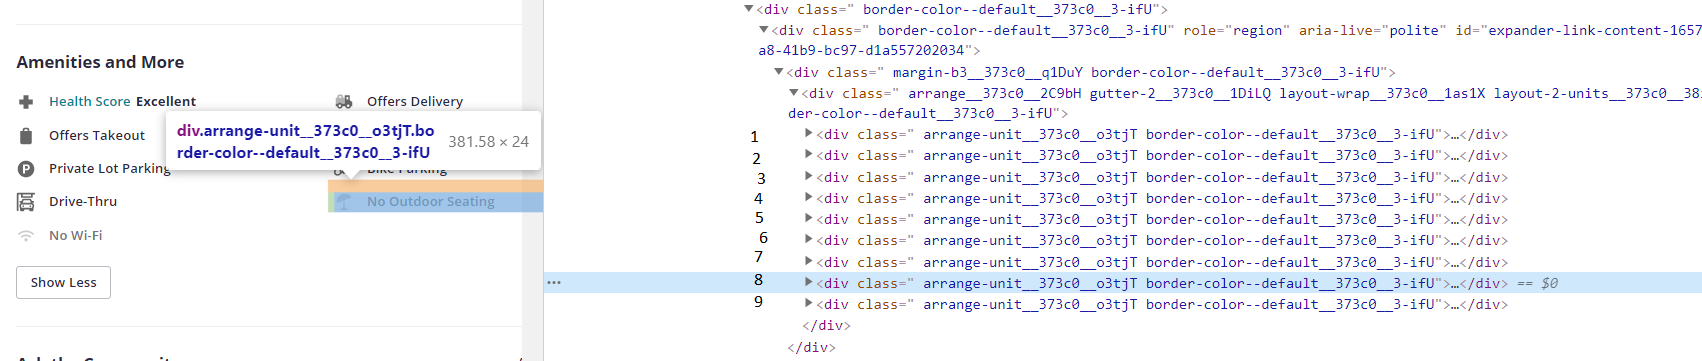
点击'5多个属性‘之前的
- :第一张图片显示了4个"div“,其中有一个是"span”,我可以使用上面的任何一个点击’5个多属性‘:第二个图片显示了9个"div“,其中包含了我想要达到的"span”。
。
下面是使用selenium/美观汤的代码
import selenium
from selenium import webdriver
from bs4 import BeautifulSoup

URL ='https://www.yelp.com/biz/ziggis-coffee-longmont'

driver =
 webdriver.Chrome(r"C:\Users\Fariha\AppData\Local\Programs\chromedriver_win32\chromedriver.exe")
driver.get(URL)
yelp_page_source_page1 = driver.page_source


soup = BeautifulSoup(yelp_page_source_page1,'html.parser')
spans = soup.find_all('span')
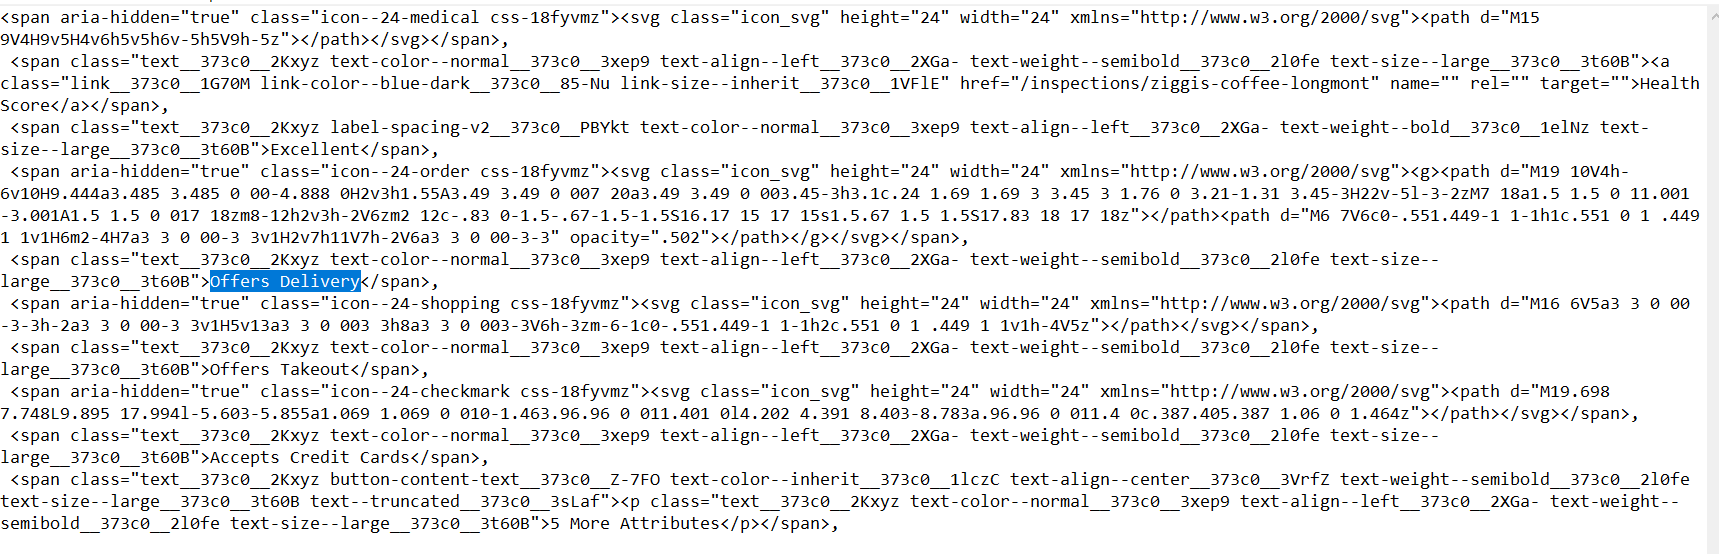
结果:“跨”中有990种元素。我只想说明与我的问题有关的内容:
回答 1
Stack Overflow用户
发布于 2021-01-22 11:19:15
另一种方法是直接从站点上的JSON中提取数据。这可以在没有selenium开销的情况下完成,如下所示:
from bs4 import BeautifulSoup
import requests
import json

session = requests.Session()
r = session.get('https://www.yelp.com/biz/ziggis-coffee-longmont')
#r = session.get('https://www.yelp.com/biz/menchies-frozen-yogurt-lafayette')

soup = BeautifulSoup(r.content, 'lxml')

# Locate the business ID to use (from JSON inside one of the script entries)
for script in soup.find_all('script', attrs={"type" : "application/json"}):
    gaConfig = json.loads(script.text.strip('<!-->'))

    try:
        biz_id = gaConfig['gaConfig']['dimensions']['www']['business_id'][1]
        break
    except KeyError:
        pass

# Build a suitable JSON request for the required information
json_post = [
    {
        "operationName": "GetBusinessAttributes",
        "variables": {
            "BizEncId": biz_id
        },
        "extensions": {
            "documentId": "35e0950cee1029aa00eef5180adb55af33a0217c64f379d778083eb4d1c805e7"
        }
    },
    {
        "operationName": "GetBizPageProperties",
        "variables": {
            "BizEncId": biz_id
        },
        "extensions": {
            "documentId": "f06d155f02e55e7aadb01d6469e34d4bad301f14b6e0eba92a31e635694ebc21"
        }
    },
]

r = session.post('https://www.yelp.com/gql/batch', json=json_post)
j = r.json()

business = j[0]['data']['business']
print(business['name'], '\n')

for property in j[1]['data']['business']['organizedProperties'][0]['properties']:
    print(f'{"Yes" if property["isActive"] else "No":5} {property["displayText"]}')
这将为您提供以下条目:
Ziggi's Coffee

Yes   Offers Delivery
Yes   Offers Takeout
Yes   Accepts Credit Cards
Yes   Private Lot Parking
Yes   Bike Parking
Yes   Drive-Thru
No    No Outdoor Seating
No    No Wi-Fi
这是怎么解决的?
您最好的朋友是您的浏览器的网络开发工具。有了这个功能,您就可以查看获取信息的请求。正常的流程流程是下载初始HTML页面,这将运行javascript并请求更多数据以进一步填充页面。
诀窍是首先定位您想要的数据的位置(通常以JSON的形式返回),然后确定您需要什么来重新创建发出请求所需的参数。
要进一步理解这段代码,请使用print()。打印所有内容,它将向您展示每个部分是如何在下一部分的基础上构建的。剧本就是这样写的,一次只写一次。
使用Selenium的方法允许javascript工作,但大多数情况下这是不需要的,因为它只是提出请求和格式化数据以供显示。
https://stackoverflow.com/questions/65838411
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号