
在azure数据库中查询sql server表
在azure数据库中查询sql server表
提问于 2020-08-04 22:17:16
我使用下面的代码来使用azure查询我的azure server数据库中的sql server表hr.employee。我对激发sql并尝试一步一步地学习细微之处是陌生的。
Azure数据库:
%scala
val jdbcHostname = dbutils.widgets.get("hostName")
val jdbcPort = 1433
val jdbcDatabase = dbutils.widgets.get("database")
val jdbcUrl = s"jdbc:sqlserver://${jdbcHostname}:${jdbcPort};database=${jdbcDatabase}"

import java.util.Properties
val connectionProperties = new Properties()

connectionProperties.put("user", s"${jdbcUsername}")
connectionProperties.put("password", s"${jdbcPassword}")

%scala
val driverClass = "com.microsoft.sqlserver.jdbc.SQLServerDriver"
connectionProperties.setProperty("Driver", driverClass)

%scala
val employee = spark.read.jdbc(jdbcUrl, "hr.Employee", connectionProperties)

%scala
spark.sql("select * from employee")

%sql
select * from employee

employee.select("col1","col2").show()
我得到了以下错误。不知道我做错了什么。也尝试过几种变体,但到目前为止还没有成功。
错误:
';' expected but integer literal found.

command-922779590419509:26: error: not found: value %
%sql

command-922779590419509:27: error: not found: value select
select * from employee

command-922779590419509:27: error: not found: value from
select * from employee

command-922779590419509:16: error: not found: value %
%scala回答 1
Stack Overflow用户
回答已采纳
发布于 2020-08-05 09:16:46
您可以签出以下步骤来使用其JDBC驱动程序查询Server:
注意:在整个教程中,我使用的是"Scala“源代码。
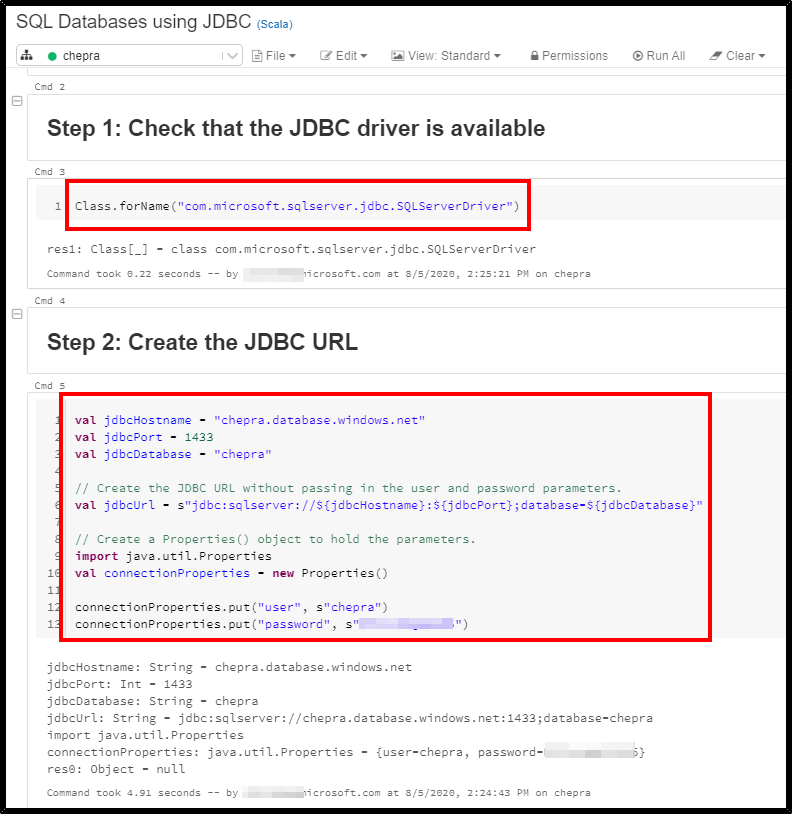
步骤1:检查是否有JDBC驱动程序可用
Class.forName("com.microsoft.sqlserver.jdbc.SQLServerDriver")步骤2:创建JDBC
val jdbcHostname = "<hostname>"
val jdbcPort = 1433
val jdbcDatabase = "<database>"

// Create the JDBC URL without passing in the user and password parameters.
val jdbcUrl = s"jdbc:sqlserver://${jdbcHostname}:${jdbcPort};database=${jdbcDatabase}"

// Create a Properties() object to hold the parameters.
import java.util.Properties
val connectionProperties = new Properties()

connectionProperties.put("user", s"${jdbcUsername}")
connectionProperties.put("password", s"${jdbcPassword}")
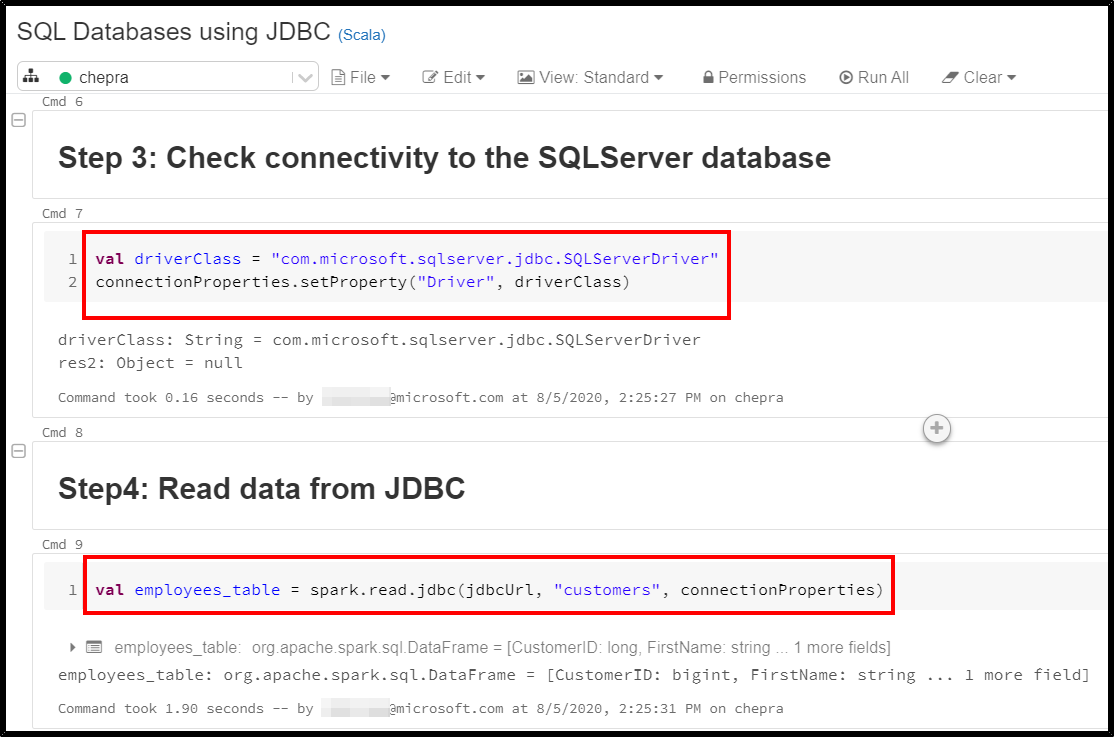
步骤3:检查到SQLServer数据库的连接
val driverClass = "com.microsoft.sqlserver.jdbc.SQLServerDriver"
connectionProperties.setProperty("Driver", driverClass)
Step4:从JDBC读取数据
val employees_table = spark.read.jdbc(jdbcUrl, "employees", connectionProperties)Step5:从数据库表中读取模式
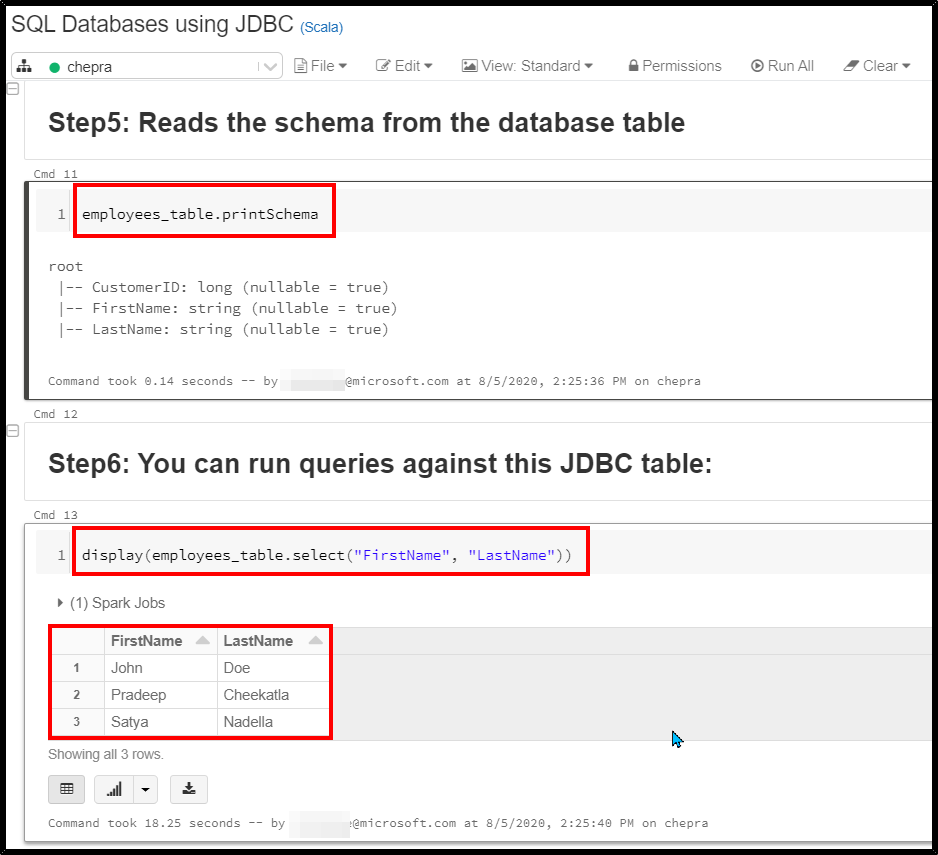
employees_table.printSchemaStep6:您可以对这个JDBC表运行查询:
display(employees_table.select("age", "salary").groupBy("age").avg("salary"))这里是供您参考的屏幕截图:
=======> 最新答案 <===============
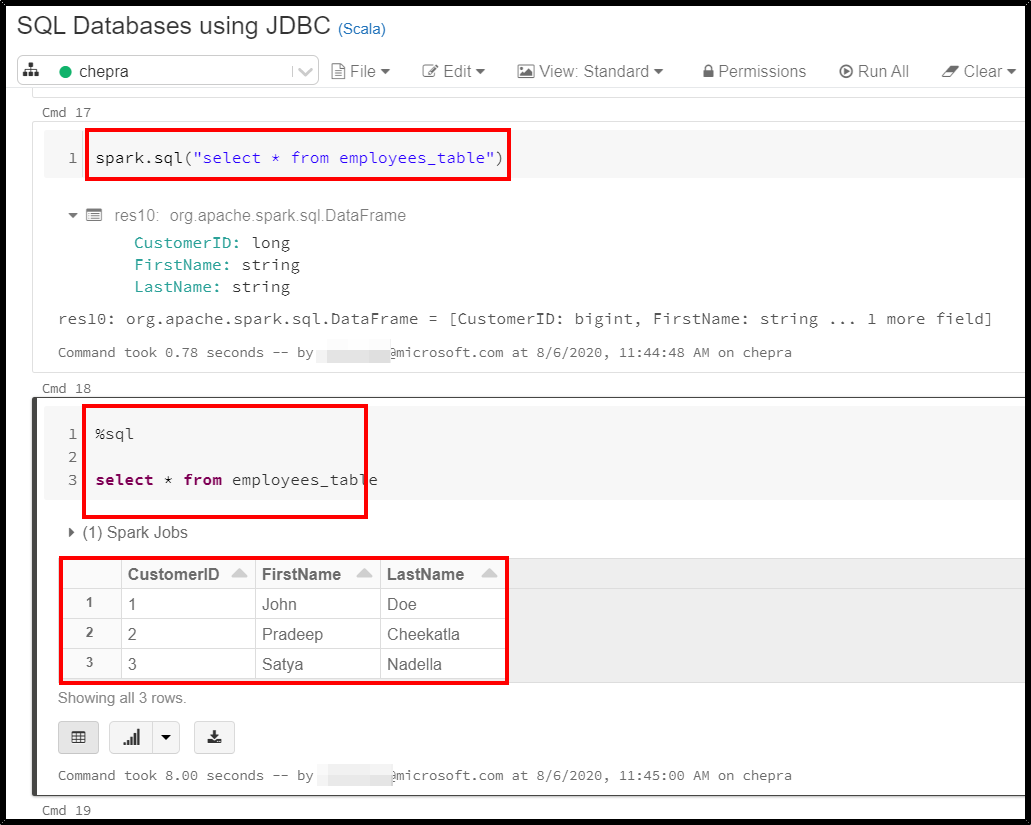
使用SQL查询:
Step1:从Python或Scala中的DataFrame创建全局表的:
dataFrame.write.saveAsTable("<table-name>")
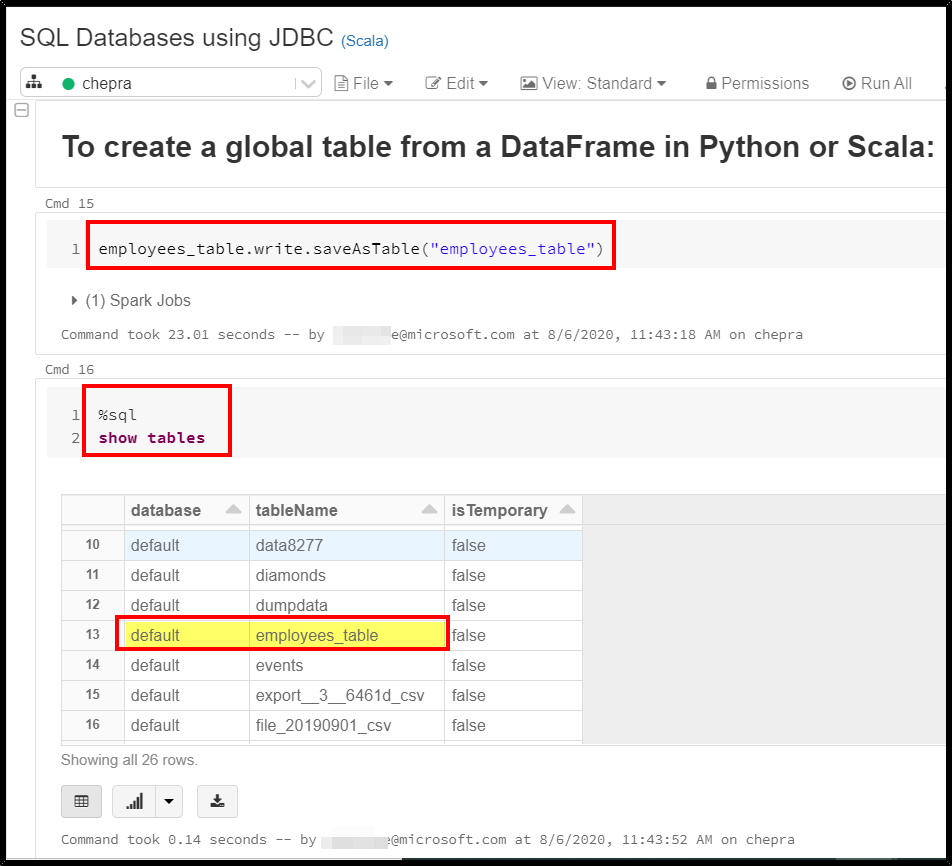
**步骤2:**现在运行SQL查询
spark.sql("select * from employees_table")

%sql

select * from employees_table
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/63255827
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号