
错误标记数据。错误Panda读取xlsx文件
有一些题目和我的题目相似,但都没有回答我的问题。
我正在尝试读取具有以下格式的xlsx文件
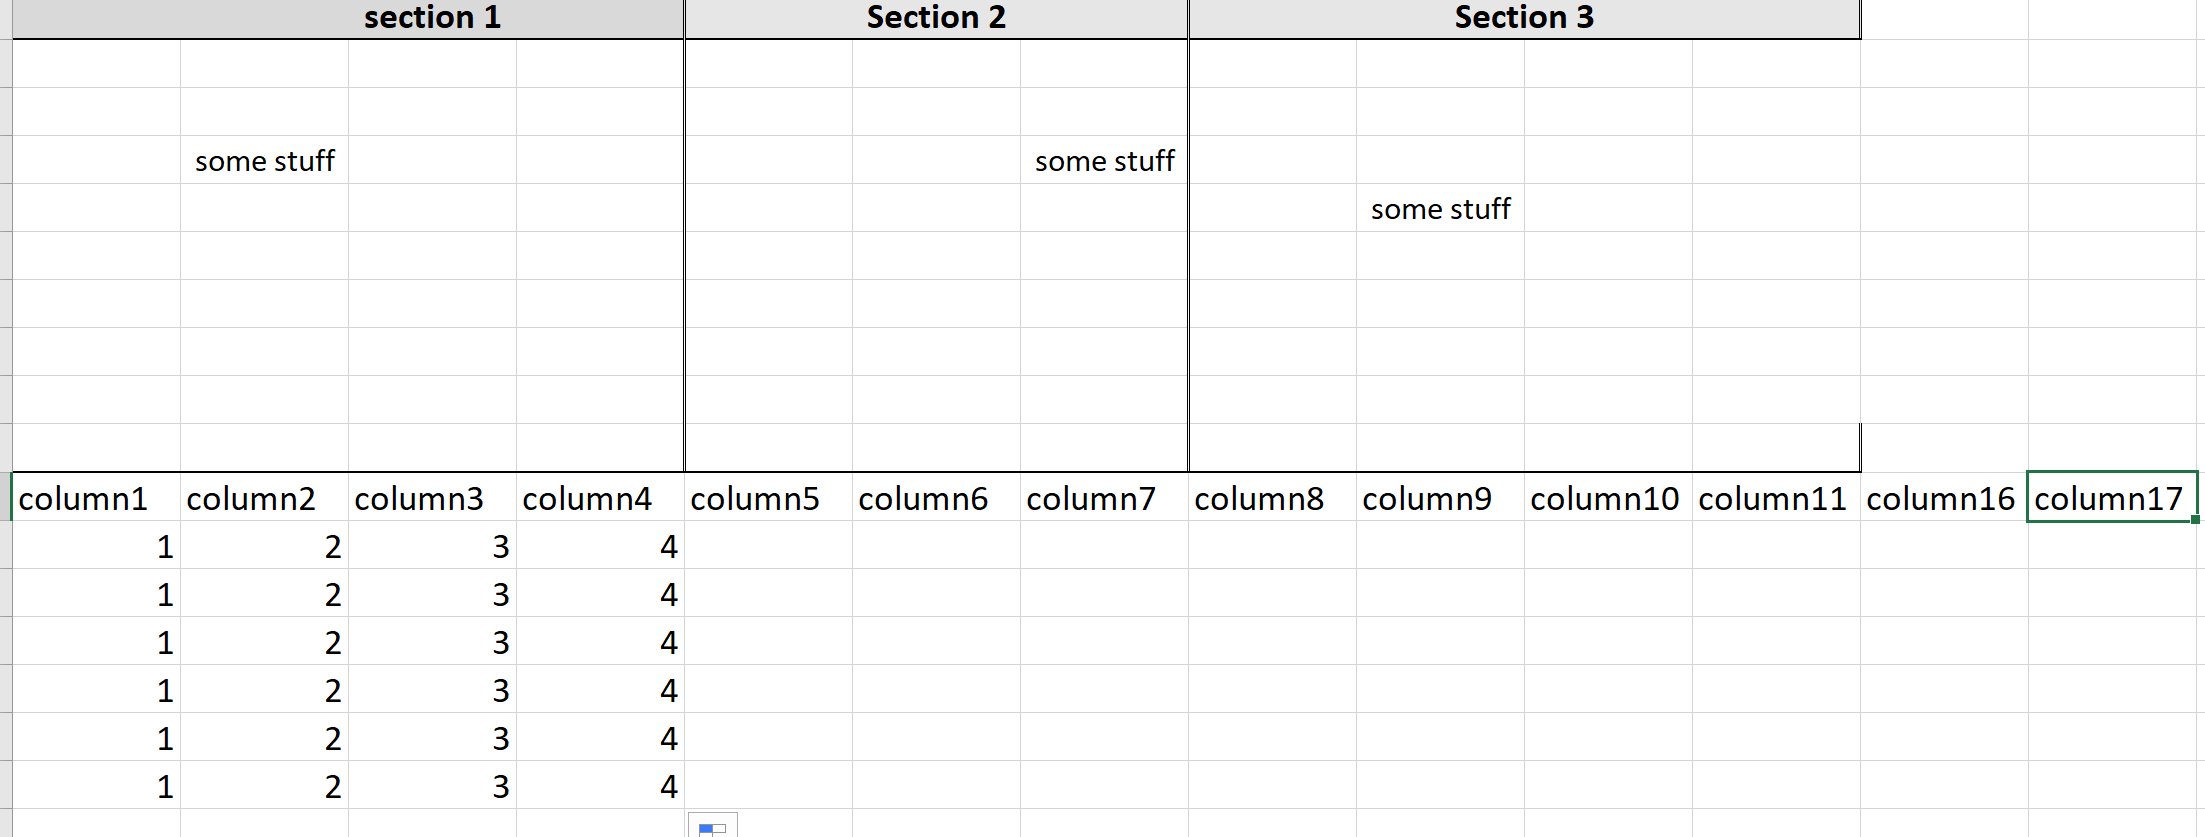
但是,我得到了以下错误:“error标记数据。C错误:第4行中预期的1个字段,saw 3
我对读取数据第1节、第2节或第3节不感兴趣(但是我有许多这样的文件,所以我不能删除它们).I只想读取column1,column2,.column17。(假设删除前40行)下面是我尝试过的:
data=pd.read_csv(Path)我得到错误标记数据。C错误。
当我尝试使用header= None时,我也得到了同样的东西。我试过以下几点:
data=pd.read_csv(Path,error_bad_lines=False)错误标记数据。C错误:捕获缓冲区溢出
我试过以下几点:
data=pd.read_csv(Path,names=[column1,column2,....column17])我犯了这个错误
'utf-8‘编解码器无法在位置上解码字节0xf2。
我不知道使用什么编码,也不认为这是问题所在。我也想跳过xlsx文件的前40行,而且我似乎不能将引擎更改为python,而且它只能在默认情况下工作。正常读取数据。有人能帮我加载和读取这些数据吗?
更新:删除section1、section2、.我还得到了标记错误。然而,删除上面的部分会使一些文件被损坏到列中,也许是这样。
‘更新:文件可以使用pd.read_excel (路径)读取,原因是为什么我不能使用pd.read_csv读取它,因为它提供了更多的pd.read_excel选项?
回答 2
Stack Overflow用户
发布于 2019-10-06 08:02:54
您可以通过df=Pd.read_excel(path,skiprows=40)实现从read_csv读取excel文件的目的,这就是为什么会产生错误。您可以使用这个,它不会出现错误
Stack Overflow用户
发布于 2019-10-06 06:46:09
试着用,
data = pd.read_csv(path, skiprows=40)这将跳过读取.csv文件中的前40行。
https://stackoverflow.com/questions/58254315
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号