
如何按两列分组并创建子图的循环?
如何按两列分组并创建子图的循环?
提问于 2019-10-17 21:51:22
我在这个结构中有一个大数据帧(df):
    year        person      purchase

    2016        Peter       0
    2016        Peter       223820
    2016        Peter       0
    2017        Peter       261740
    2017        Peter       339987
    2018        Peter       200000
    2016        Carol       256400
    2017        Carol       33083820
    2017        Carol       154711
    2018        Carol       3401000
    2016        Frank       824043
    2017        Frank       300000
    2018        Frank       214416259
    2018        Frank       4268825
    2018        Frank       463080
    2016        Rita        0
为了看看每个人每年花了多少钱,我每年和每个人一起做,这给了我我想要的。
代码:
df1 = df.groupby(['person','year']).sum().reset_index()我如何创建一个循环,为每个人创建子图,其中包含他/她每年用于购买的内容?
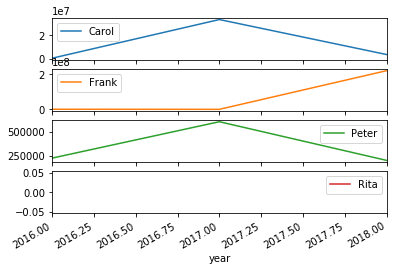
因此是每个人的一个子图,其中x=年份,y=购买.。
我试过很多不同的东西,这里解释,但似乎没有工作。
谢谢!
回答 1
Stack Overflow用户
回答已采纳
发布于 2019-10-17 22:36:23
您可以执行pivot_table或groupby().sum().unstack('person'),然后执行plot。
(df.pivot_table(index='year',
                columns='person',
                values='purchase',
                aggfunc='sum')
    .plot(subplots=True)
);
或
(df.groupby(['person','year'])['purchase']
   .sum()
   .unstack('person')
   .plot(subplots=True)
);
输出:
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/58441173
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号