
我可以在TCPDF中使用“老式”(非衬里)数字吗?
Unicode不区分列数字(它与大写字母的比例相同,在表中很有用,但在运行文本时很有用)和非衬数字,它们看起来更像小写字母,有上升和下降,因为它认为它们是彼此的变体。然而,许多字体都有两组数字,并提供了一种在它们之间进行选择的方法。有没有办法在TCPDF中实现这一点?
理想情况下,我希望编号列表使用列数字,在运行文本中使用数字使用非衬线,而邮政编码(英国和爱尔兰邮政编码是字母数字)使用非对列数字和小大写字母。这可以在LaTeX和\oldstylenums{1234567890}中实现。
我能找到的唯一类似的问题是关于tweaking font metrics in TCPDF to make non-lining figures look lining的。理想情况下,我希望在同一字体和同一文档中同时使用这两种字体。TCPDF允许访问OpenType字符变化吗?(公平的警告:我在这里有点过火了。)
回答 1
Stack Overflow用户
发布于 2019-10-23 20:57:34
不幸的是,据我所知,TCPDF不支持OpenType变体。例如,查看freesans的字体声明文件时,字符宽度数组中甚至没有包含pnum变体符号。
但是,您可以做的是使用字体伪造将变体字形复制到Unicode区域,并在要使用它们的上下文中映射字符。例如,如果您没有使用下标数字符号,它们是很好的选择,因为搜索似乎仍然在我测试过的几个PDF阅读器中找到它们。
为了测试一些东西,我运行了一个类似的场景:使用Free,但希望在一些具有相同字体文件的地方使用比例数字。我用FontForge打开了Free字体,查看了字形信息,查看了零个字形的可用变体,使用它找到了一组pnum字形,然后将它们复制到下标数字上。(u2080 - u2089)范围是任意的,因此,如果您使用这些符号,例如,有私有的使用范围,尽管这会破坏搜索性,而不需要额外的步骤。
然后在TCPDF中,只需在我想要影响的字母数字字符串上运行一个字符串替换。
$pdf->writeHTMLCell(0, 0, '', '', '<span style="font-family: freesansmod">H90173A8301X5</span>', 0, 1, 0, true, '', true);

//I feel like there's a shorter way to write this...
$special_numbers = str_replace(['0','1','2','3','4','5','6','7','8','9'],
    ["\u{2080}", "\u{2081}", "\u{2082}", "\u{2083}",
         "\u{2084}", "\u{2085}", "\u{2086}", "\u{2087}",
         "\u{2088}", "\u{2089}"], 'H90173A8301X5');

$pdf->writeHTMLCell(0, 0, '', '', '<span style="font-family: freesansmod">'.$special_numbers.'</span>', 0, 1, 0, true, '', true);
结果仍然是可搜索的,尽管复制和粘贴有点奇怪。注意:这个是关闭的,因为我想看看是否可以调整字形的位置。
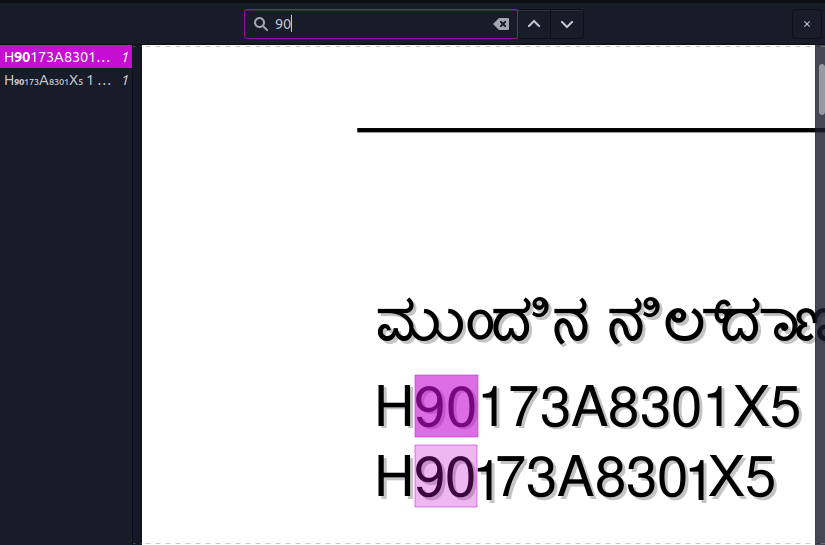
回到您的具体情况,如果您愿意放松“相同字体”的要求,另一种选择是创建一个单独的派生字体,使用覆盖标准数字的变体字形,并在您想要的情况下切换到它。我还没有搜索,但可能有预先存在的工具,可以自动为您这样做。内容将完全保留其语义意义,代码可能会更清晰一些,而代价是有效地嵌入两个相同字体的副本。
https://stackoverflow.com/questions/58505628
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号