
使用自动标度,HPA无法读取CPU或内存指标。
我在GKE集群上安装了stable/nginx-ingress的最新版本(1.24.5)和autoscaling: true。
完成部署后,HPA说unable to read all metrics。
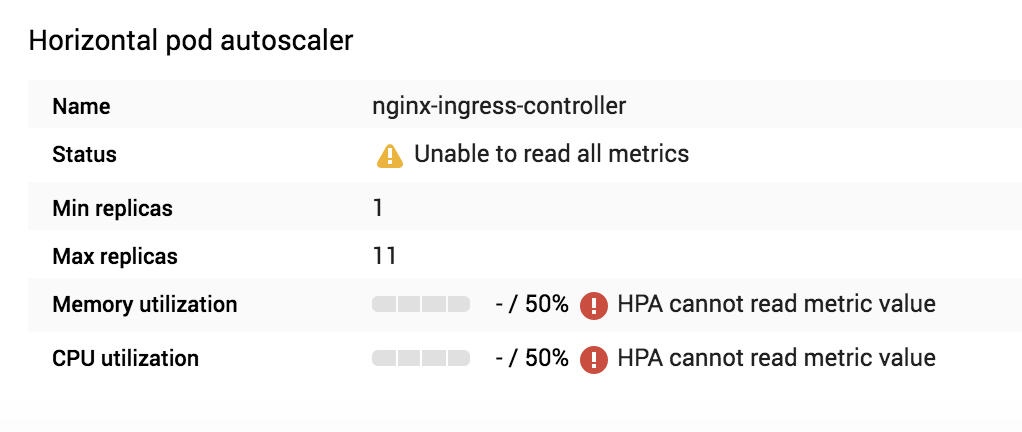
你能帮我调试和修复吗?如果您需要更多的详细信息/日志,请询问,我会提供它!
谢谢
更新:
- 我可以很好的运行其他的HPA
kubectl get hpa返回 未知/100米CPU 未知/100英里用于RAM
回答 3
Stack Overflow用户
发布于 2020-03-05 17:54:58
看来,由于HPA是通过在入口控制器上启用自动分频器而创建的,因此它将在标签app=nginx-ingress上应用HPA。nginx入口default-backend也有相同的标签,因此也需要我们定义CPU/内存资源请求/限制。
您可以在此GitHub问题中找到更多信息。
Stack Overflow用户
发布于 2019-11-21 17:58:27
我想可能是因为一些吊舱的容器没有设置相关的资源要求。因此,对于Kubernetes HPA 文档,当这种情况发生时,不能定义对pod的使用(自动分频器将不会对该度量采取任何行动)。
您可以通过运行kubectl get hpa来快速检查当前自动分频器。或者您可以通过kubectl describe hpa获得更详细的描述。如果您看到一些被列出为<unknown>的目标,那么很可能资源请求没有正确设置。
如果您已经为所有的荚设置了资源请求,并且仍然可以看到这条消息,那么如果您能够分享更多关于如何定义请求和/或限制的详细信息,也许会有所帮助。
库伯奈特文件中的这些文章可能是有用的:
致以问候!
Stack Overflow用户
发布于 2020-04-18 08:06:29
我还不能发表评论。正如marandall在上面链接的GitHub问题中所说的那样,可以通过定义资源限制并将--set controller.useComponentLabel=true --set defaultBackend.useComponentLabel=true添加到helm命令来解决这个问题。
https://stackoverflow.com/questions/58688106
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号