
数据工厂V2复制数据活动和数据流
我的问题关于数据工厂V2复制数据活动我有5个问题。
问题1
我应该使用拼板文件还是SQL server与500个DTU一起使用,我想要将数据快速传输到暂存表或暂存拼板文件。
问题2
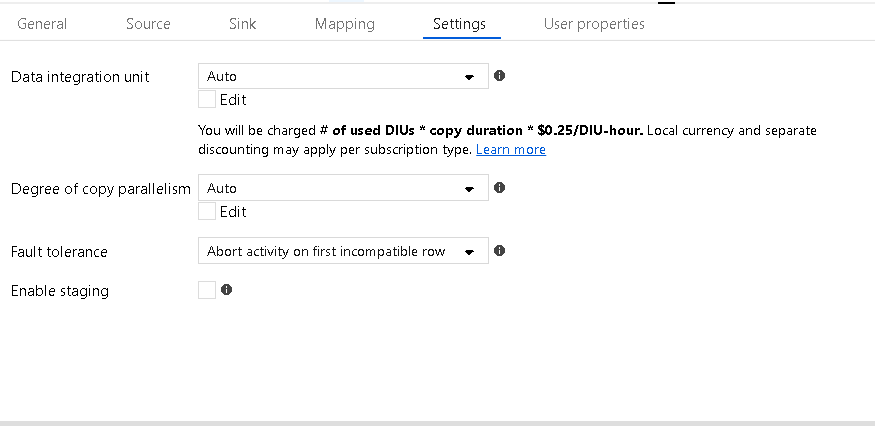
复制数据活动数据集成单元我应该使用auto还是使用32数据集成单元
问题3
使用程度的复制并行性的好处是,我应该使用汽车还是再次使用32 ,我想尽可能快地传输所有的东西,我每天大约有5000万行。
问题4
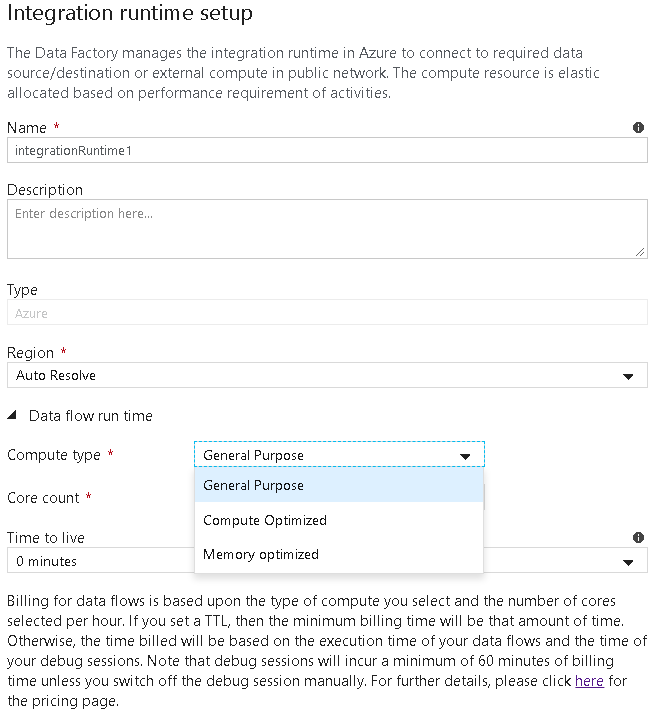
数据流集成运行时--所以我应该使用通用、计算优化或内存优化--就像我提到的那样--我们每天都有5,000万行,所以我们希望尽可能快地处理数据,如果我们能在数据流中做到这一点的话,也会很便宜。
问题5
批量插入更适用于数据工厂和数据流库
回答 1
Stack Overflow用户
发布于 2019-11-15 18:15:13
我认为你对太多的话题有太多的疑问,这些问题的答案将完全取决于你期望的最终结果。即使如此,我还是会尽量简短地谈谈你的情况。
如果您处理的是大容量和/或频率,数据流(ADFDF)可能比复制活动更好。ADFDF通过数据块在Spark上运行,并从底层构建,以运行并行工作负载。拼花也是用来支持并行工作负荷的。如果您的SQL是Azure Synapse (SQLDW)实例,那么ADFDF将使用Polybase来管理上传,这非常快速,因为它也是为并行工作负载构建的。我不知道这对于Azure SQL有什么不同,也无法告诉您哪个DTU级别最适合您的任务。
如果将Parquet作为您的最终结果是可以接受的,那么这可能是最简单和最便宜的配置,因为它只是blob存储。ADFDF在Parquet中工作得很好,无论是源还是水槽。对于ETL工作负载,Compute是最有可能的IR配置。好消息是它是这三种产品中最便宜的。坏消息是,我没有办法知道核心数应该是什么,你只需要通过尝试和错误来找出答案。5000万行听起来可能很大,但实际上取决于行大小(字节计数和列计数)和频率。如果进程每天运行多次,那么您可以在IR配置中包含一个“生存时间”值。这将使集群在等待另一个作业时保持温暖,从而可能减少启动时间(但会导致更多的运行时间成本)。
https://stackoverflow.com/questions/58867230
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号