
ImportError:无法从“azure.storage.blob”导入名称“BlockBlobService”
我试图将Azure blob容器中的文本文件从ANSI转换为UTF-8编码,而不使用python在本地下载文件。当我试图在我的BlockBlobService代码中导入来处理时,我得到了以下错误。我相信我已经安装了正确的python模块,但是可能还缺少一些我不知道的模块,也可能是“没有正确的python模块版本”。"pip“命令在我的VM上显示了以下内容。在这方面任何帮助都会很好。
pip列表包版本
azure-common         1.1.25
azure-core           1.4.0
azure-nspkg          3.0.2
azure-storage        0.36.0
azure-storage-blob   12.3.0
azure-storage-common 2.1.0
azure-storage-nspkg  3.1.0
bcrypt               3.1.7
certifi              2020.4.5.1
cffi                 1.14.0
chardet              3.0.4
cryptography         2.9
idna                 2.9
isodate              0.6.0
msrest               0.6.13
oauthlib             3.1.0
paramiko             2.7.1
pip                  20.0.2
pycparser            2.20
PyNaCl               1.3.0
python-dateutil      2.8.1
requests             2.23.0
requests-oauthlib    1.3.0
setuptools           41.2.0
six                  1.14.0
urllib3              1.25.8
wheel 0.34.2回答 2
Stack Overflow用户
发布于 2020-04-21 05:52:19
如果blob编码不是UTF-8,它就无法更改它。你说你想用create_blob_from_text来做这件事,所以我想你的文本文件不是UTF-8,你想把它改成UTF-8来上传它。
首先你应该知道,如果你的文本文件是UTF-8,你不需要修改任何东西,只要上传它,它仍然是UTF-8。但是,如果您的文件不是UTF-8,它将不会将其转换为UTF-8,它将被用原始编码编码为UTF-8。如果您能够理解这一点,那么您将知道如何使用UTF-8编码将您的文件上传到azure blob。
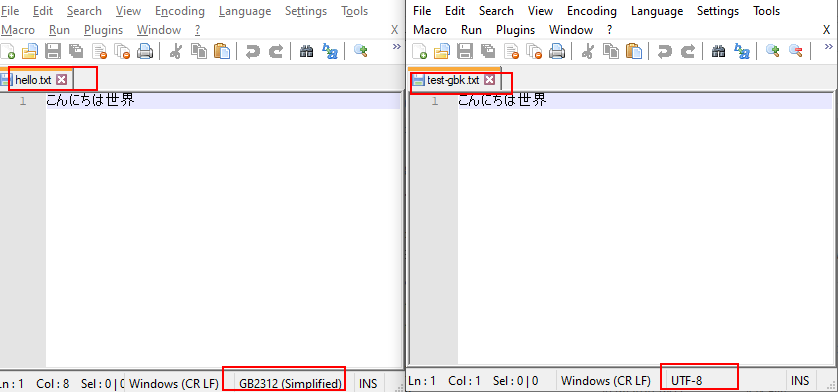
和下面一样,我上传了一个带有编码GBK的文本文件。
txt= open('D:/hello.txt').readline() # GBK Tex

charset = 'UTF-8'
block_blob_service.create_blob_from_text(container_name='test',blob_name='test-gbk.txt',text=txt.encode('ISO-8859-1').decode('GBK'),encoding=charset)下面是图片,左边是使用GBK编码的原始文件,右边是从蓝色blob下载的文件,它是用'UTF-8‘编码的。
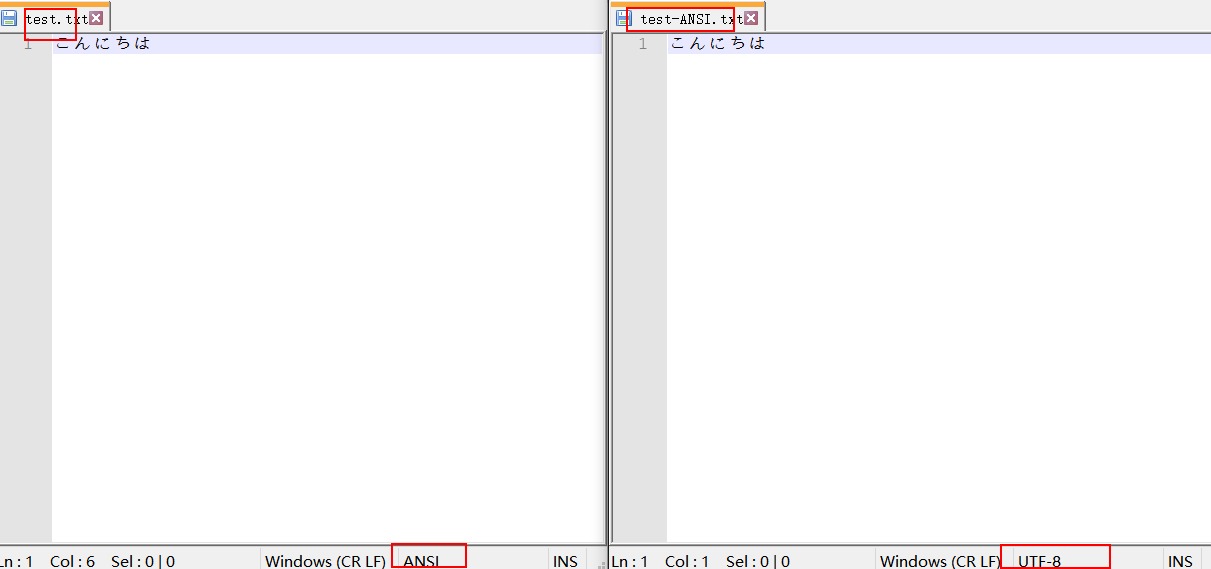
更新:我打开文本文件到BytesIO,然后用下面的代码上传它。你可以忽略latin-1。
text=open('E:/test.txt',encoding='latin-1').readline()
charset = 'UTF-8'
buf=BytesIO(text.encode('ISO-8859-1').decode('ANSI').encode('UTF-8'))
block_blob_service.create_blob_from_stream(container_name='test',blob_name='test.txt',stream=buf)
Stack Overflow用户
发布于 2020-06-24 18:39:09
Azure-storage-blob,version: 12.3.0是包含BlobServiceClient而不是BlockBlobService的最新版本,因此如果您想使用BlockBlobService,则必须将azure-storage-blob版本指定为2.1.0。就这么做
pip install azure-storage-blob==2.1.0这会解决你的问题。
https://stackoverflow.com/questions/61317453
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号