
尝试通过雅典娜查询位于S3中的VPC流日志
尝试通过雅典娜查询位于S3中的VPC流日志
提问于 2020-06-25 19:43:18
- 我已经创建了一个S3,指向VPC流日志到S3。
- 创建雅典娜,添加数据库和表-选择数据格式作为拼花。
- 流日志正在生成,并存储在S3中。
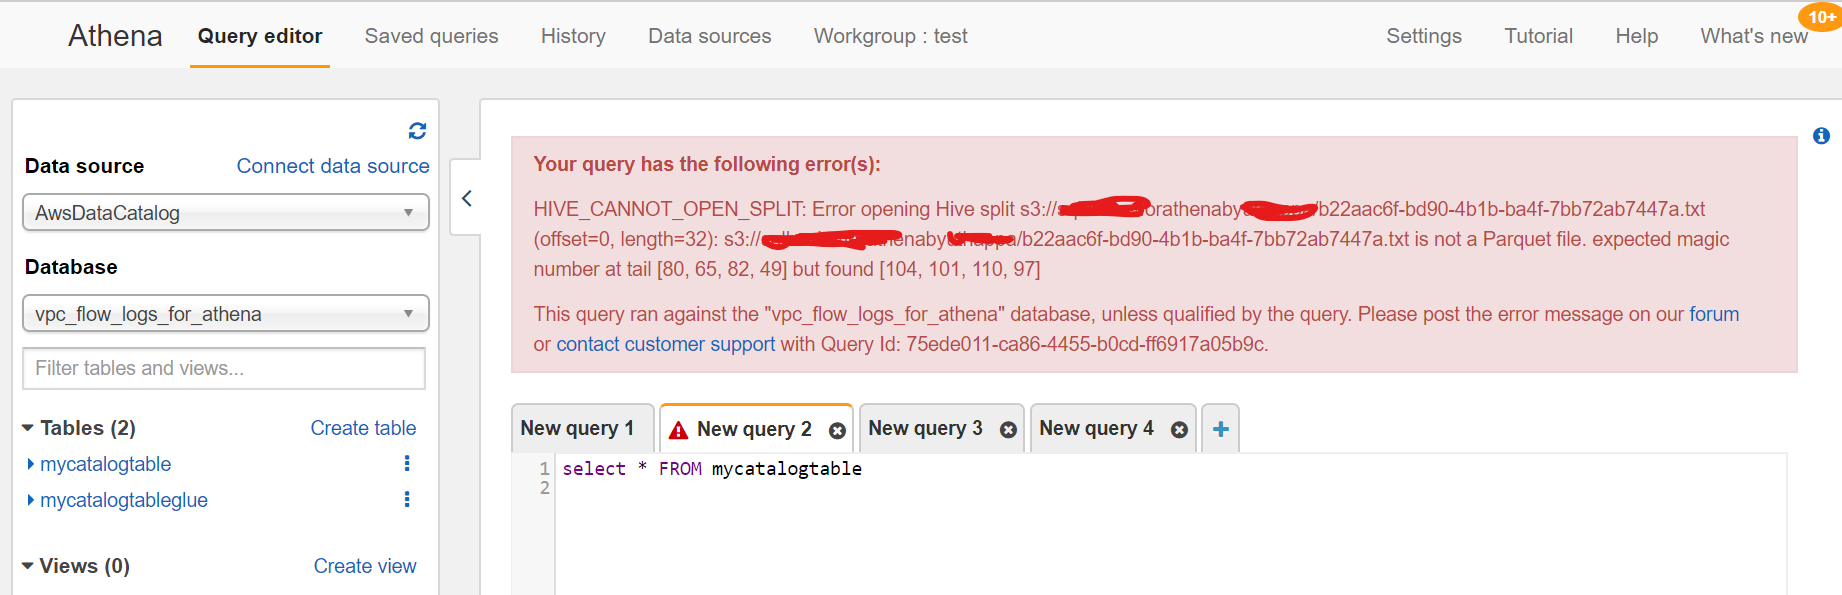
我启动了一个简单的SQL查询,并得到了以下结果。
您的查询有以下错误: s3://.../b22aac6f-bd90-4b1b-ba4f-7bb72ab7447a.txt : HIVE_CANNOT_OPEN_SPLIT:打开Hive拆分的错误(offset=0,length=32):s3://.../b22aac6f-bd90-4b1b-ba4f-7bb72ab7447a.txt不是Parquet文件。预期的魔术号在尾部80,65,82,49,但发现104,101,110,97这个查询运行在"vpc_flow_logs_for_athena“数据库,除非被查询限定。请在我们的论坛上张贴错误信息,或与客户支持联系查询Id: 75ede011-ca86-4455-b0cd-ff6917a05b9c。-
有人能帮我搞定雅典娜吗?
回答 2
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/62583152
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号