
用火花放电跟踪和查找数据中的最新值
用火花放电跟踪和查找数据中的最新值
提问于 2021-05-28 12:36:15
我是新来的,我得到了下面的情况下,我需要解决它。有人能帮我解决一下吗?我检查并试图在google和堆栈溢出中找到类似的问题。但不幸的是我没明白。
问题:
我有dataframe,其中包含两个列,一个过时了,另一个替换。
DataFrame:
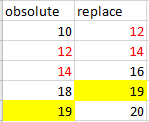
在上述数据帧中,替换列中的绝对值被更新。例:在这里10变成12,在下一行12变成14,第3行又变成14,第14行又变成16。
所以前三个值成为一个组,因为有链式值被更新。用红色突出显示,所以对于那些不确定的值,最后的值在替换中,这是16的最新值。对于其他两行,19是连接值,并以黄色高亮显示,因此这两行的最新值为20是最新值。
预期输出
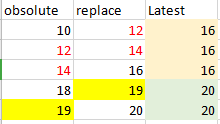
我试着用地图和预言在火星雨中,但没有得到欲望的结果。有些人请帮我解决这个问题。
回答 1
Stack Overflow用户
回答已采纳
发布于 2021-05-28 13:39:49
首先,您必须发现所有的链,并为它们创建一个组。分组后,可以应用f.last()函数返回所需的值。
from pyspark.sql import Row
from pyspark.sql.window import Window
import pyspark.sql.functions as f


df = spark.createDataFrame([
  (10, 12),
  (12, 14),
  (14, 16),
  (18, 19),
  (19, 20),
  (22, 24),
  (24, 25),
  (25, 27),
  (29, 30)
], ('obsolute', 'replace'))

w = Window.orderBy('obsolute')
df = (df
      .withColumn('chain', f.coalesce(f.lag('replace').over(w) == f.col('obsolute'), f.lit(True)))
      .withColumn('group', f.sum((f.col('chain') == f.lit(False)).cast('Int')).over(w)))
# +--------+-------+-----+-----+
# |obsolute|replace|chain|group|
# +--------+-------+-----+-----+
# |10      |12     |true |0    |
# |12      |14     |true |0    |
# |14      |16     |true |0    |
# |18      |19     |false|1    |
# |19      |20     |true |1    |
# |22      |24     |false|2    |
# |24      |25     |true |2    |
# |25      |27     |true |2    |
# |29      |30     |false|3    |
# +--------+-------+-----+-----+


w = Window.partitionBy('group')
df = df.select('obsolute', 'replace', f.last('replace').over(w).alias('latest'))

df.show(truncate=False)
输出
+--------+-------+------+
|obsolute|replace|latest|
+--------+-------+------+
|10      |12     |16    |
|12      |14     |16    |
|14      |16     |16    |
|18      |19     |20    |
|19      |20     |20    |
|22      |24     |27    |
|24      |25     |27    |
|25      |27     |27    |
|29      |30     |30    |
+--------+-------+------+页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/67738965
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号