
MySql删除查询太慢,并且永远运行。
我有一个有40万条记录的MySQL表(TABLE1)
CREATE TABLE `TABLE1` (
  `ID` bigint(20) NOT NULL AUTO_INCREMENT,
  `NAME` varchar(255) NOT NULL,
  `VALUE` varchar(255) NOT NULL,
  `UID` varchar(255) NOT NULL,
  `USER_ID` varchar(255) DEFAULT NULL,
  PRIMARY KEY (`ID`),
  UNIQUE KEY `ukey1` (`VALUE`,`NAME`,`UID`),
  UNIQUE KEY `ukey2` (`UID`,`NAME`,`VALUE`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

CREATE TABLE `TABLE2` (
  `ID` bigint(20) NOT NULL AUTO_INCREMENT,
  `UID` varchar(255) DEFAULT NULL,
  `TABLE3ID` bigint(20) NOT NULL
  PRIMARY KEY (`ID`),
  KEY `FKEY` (`TABLE3ID`),
  CONSTRAINT `FKEY` FOREIGN KEY (`TABLE3ID`) REFERENCES `TABLE3` (`ID`),
) ENGINE=InnoDB  DEFAULT CHARSET=utf8;

CREATE TABLE `TABLE3` (
  `ID` bigint(20) NOT NULL AUTO_INCREMENT,
  `TYPEID` bigint(20) NOT NULL,
  PRIMARY KEY (`ID`)
) ENGINE=InnoDB  DEFAULT CHARSET=utf8
下面的查询非常慢,需要几个小时,最后失败
delete from TABLE1 t1
inner join TABLE2 t2 on t1.UID=t2.UID
inner join TABLE3 t3 on t2.TABLE3ID=t3.ID
where t3.TYPEID in (234,3434) t1.USER_ID is not null and t1.USER_ID <> '12345';
可视化解释显示了以下内容,并在UID上添加了索引,但没有帮助。如何优化此查询的性能?
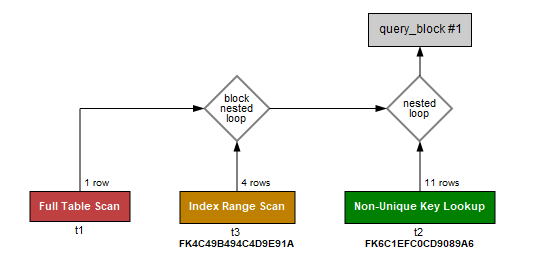
我尝试将TABLE1.UID
- Converting上的索引添加到子查询
- 中像
SELECT * FROM TABLE3 where UID="SOMEUID"这样的简单查询需要800+ ms来获取数据
回答 3
Stack Overflow用户
发布于 2021-10-08 21:00:15
将其更改为联接。
DELETE t1
FROM TABLE1 AS t1
JOIN (SELECT uid FROM ...) AS t2 ON t1.uid = t2.uid
WHERE USER_ID is not null and USER_ID <> '12345';我发现MySQL有时实现WHERE uid IN (subquery)非常糟糕。它不是获取子查询的所有结果并在表的索引中查找它们,而是扫描表并对每一行执行子查询,然后检查uid是否在该结果中。
Stack Overflow用户
发布于 2021-10-08 21:31:57
首先,对该表进行备份,这是执行删除查询的第一条规则,否则您可以破坏它,并采取之前所考虑的所有预防措施。
( uid1、uid2、...uid45000)
括号之间的这些值的含义是什么?您需要在列表中比较所有的UID值还是其中的一些值?
因为您可以避免手动放置所有UIDS。
从TABLE1中删除UID (从TABLE1中选择T.UID作为T,其中T.UID不是NULL,USER_ID <> '12345');
在执行此操作之前,请检查括号之间需要什么,然后在测试环境中首先使用虚拟值运行命令。
考虑到您在UIDS字段中的表varchars类型,这就是为什么这个操作比使用整数值花费更多时间的原因。
另一种方法是,您需要创建一个新表,并将旧表存储的数据放入旧表,然后截断原始表,并再次将新表的相同值插入旧表。
请在运行解决方案之前,与您的团队检查所有限制,并使用虚拟值进行测试。
Stack Overflow用户
发布于 2021-10-08 21:08:03
我会将您的uid筛选器列表拆分为块(按块或其他块进行,需要测试),并在其上迭代或多线程。
https://stackoverflow.com/questions/69501573
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号