
使用特殊字体的HTML混淆
使用特殊字体的HTML混淆
提问于 2021-10-26 10:33:27
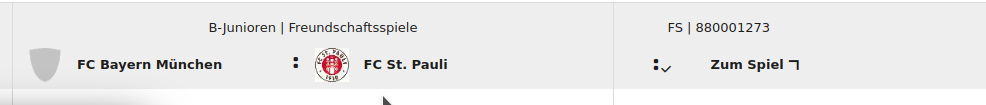
当我浏览一个德国网站时,我注意到在最初的页面加载过程中,页面上显示了一些不可打印的字符(比如)。因此,当页面仍在获取所有资源,特别是字体时,无法看到匹配的分数。我通过禁用特定的CSS规则来模拟这种行为。
该页面向每个显示分数的元素添加一个数据混淆属性和一个类。
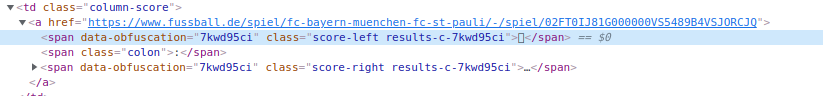
CSS规则I禁用以模拟页面加载,在目标元素上设置字体系列。字体的名称似乎与数据混淆属性的值相同,该属性似乎是为所有受影响元素共享的。当我重新加载页面时,该值也会发生变化。
.results-c-7kwd95ci {
    font-family: font-7kwd95ci !important;
}
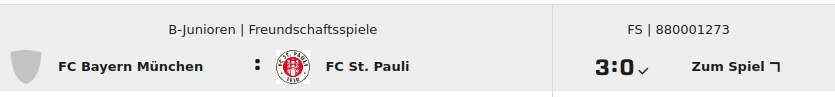
如果启用此规则,则可以正常查看得分。
这是CSS文件
@font-face {
    font-family: font-7kwd95ci;
    src:
        url('//www.fussball.de/export.fontface/-/format/woff/id/7kwd95ci/type/font') format('woff'),
        url('//www.fussball.de/export.fontface/-/format/ttf/id/7kwd95ci/type/font') format('truetype');
}

.results-c-7kwd95ci {
    font-family: font-7kwd95ci !important;
}
似乎网站是故意发送格式错误的unicode数据,这些数据只能由加载的字体呈现。由于将分数复制到剪贴板上,所以也只复制格式错误的数据。
有这种混淆的名称吗?它是如何工作的?在没有浏览器自动化的情况下,在抓取数据时是否可以避免这种情况?从技术上讲,浏览器自动化并不适用于抓取,因为数据仍然是错误的。
回答 1
Stack Overflow用户
发布于 2022-04-27 10:50:29
我发现这个刮风 npm包似乎具有与字体混淆相同的逻辑。
当我需要将页面上的位置或日期复制到邮件中时,我也会感到烦恼:)
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/69721584
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号