
如何删除重复行?
我需要从相当大的Server表(即300,000+行)中删除重复行。
当然,由于RowID标识字段的存在,行将不是完美的重复。
MyTable
RowID int not null identity(1,1) primary key,
Col1 varchar(20) not null,
Col2 varchar(2048) not null,
Col3 tinyint not null
我该怎么做?
回答 43
Stack Overflow用户
发布于 2008-08-20 22:00:00
假设没有空,您可以GROUP BY唯一的列,并将SELECT MIN (or MAX) RowId作为要保留的行。然后,只需删除没有行id的所有内容:
DELETE FROM MyTable
LEFT OUTER JOIN (
   SELECT MIN(RowId) as RowId, Col1, Col2, Col3
   FROM MyTable
   GROUP BY Col1, Col2, Col3
) as KeepRows ON
   MyTable.RowId = KeepRows.RowId
WHERE
   KeepRows.RowId IS NULL
如果您有GUID而不是整数,则可以替换
MIN(RowId)使用
CONVERT(uniqueidentifier, MIN(CONVERT(char(36), MyGuidColumn)))Stack Overflow用户
发布于 2010-09-29 14:52:32
另一种可能的方法是
;

--Ensure that any immediately preceding statement is terminated with a semicolon above
WITH cte
     AS (SELECT ROW_NUMBER() OVER (PARTITION BY Col1, Col2, Col3
                                       ORDER BY ( SELECT 0)) RN
         FROM   #MyTable)
DELETE FROM cte
WHERE RN > 1;我使用的是上面的ORDER BY (SELECT 0),因为在领带的情况下,保留哪一行是任意的。
例如,要按RowID顺序保留最新的一个,可以使用ORDER BY RowID DESC
执行计划
这方面的执行计划通常比已接受的答案中的执行计划更简单和更有效,因为它不需要自联接。
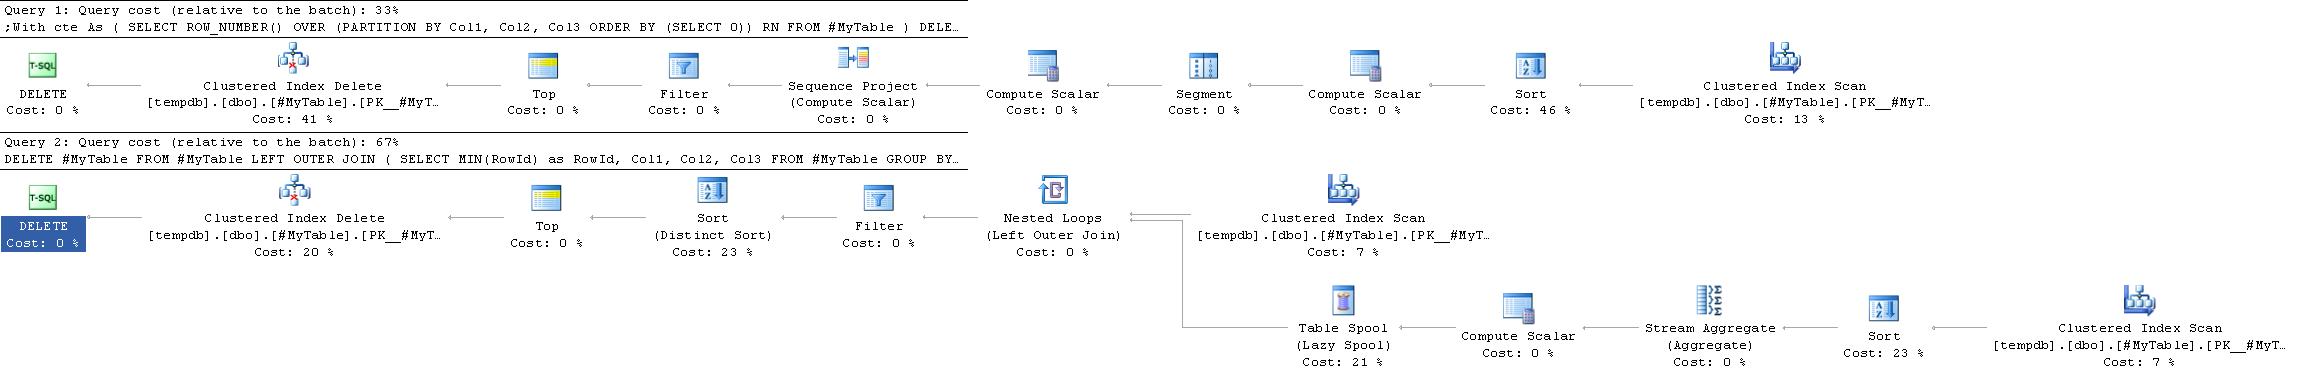
然而,情况并不总是如此。可能首选GROUP BY解决方案的一个地方是优先选择散列聚合而不是流聚合的情况。
ROW_NUMBER解决方案总是给出几乎相同的方案,而GROUP BY策略则更灵活。
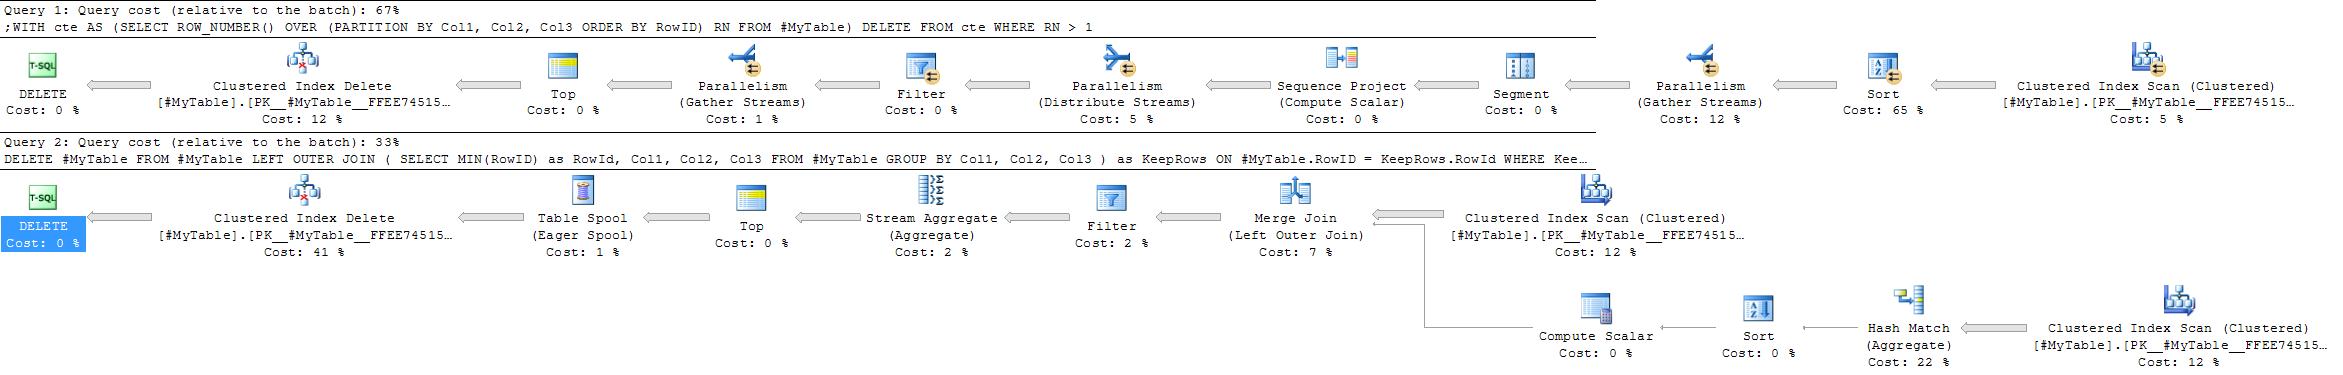
可能有利于哈希聚合方法的因素如下
- 分区列上没有有用的索引
- 每组中重复次数相对较多的组相对较少
在第二种情况的极端版本中(如果每个组中有很多重复的组),还可以考虑简单地插入行以保存到新表中,然后将原始行TRUNCATE-ing复制回来,以减少日志记录,而不是删除很高比例的行。
Stack Overflow用户
发布于 2008-08-20 21:53:14
微软支持网站上有一篇关于移除重复的好文章。这是相当保守的-他们让你在不同的步骤做所有的事情-但它应该能很好地对付大表。
在过去,我曾经使用过自联接来完成这个任务,尽管它可能会用词性子句来修饰:
DELETE dupes
FROM MyTable dupes, MyTable fullTable
WHERE dupes.dupField = fullTable.dupField
AND dupes.secondDupField = fullTable.secondDupField
AND dupes.uniqueField > fullTable.uniqueFieldhttps://stackoverflow.com/questions/18932
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号