
MySQL如何根据"in“的数量确定是否使用索引?
例如,如果有一个名为纸张的表,则使用来自纸张的选择paper.user_id、paper.name、paper.score执行user_id (201,205,209……)。
我注意到,在执行此语句时,只有在"in“的数目小于某一数字时才会使用索引。一定的数字是动态的。例如,当表中的行总数为4000,基数为3939时," in“的数目必须小于790,MySQL将执行索引查询。(查看MySQL解释。如果<790,type=range;If >790,type=all)当表中的行总数为1300000,基数为1199166时," in“的数目必须小于8500,MySQL将执行索引查询。
这个实验的结果对我来说很奇怪。
我设想如果实现这个" in“查询,我首先会找到in (max)和in (min),然后找到in (max)和in (min)所在的页面,然后排除in (min)之前的页面和in (max)后面的页面。这肯定比执行完整的表扫描要快。
然后,我的测试数据可以概括为:表1到表1300000中的900000到920000中的数据。
我的问题是,在一个包含1300000行数据的表中,为什么MySQL认为当" in“的数目超过8500时,它就不需要执行索引查询?
mysql版本5.7.20
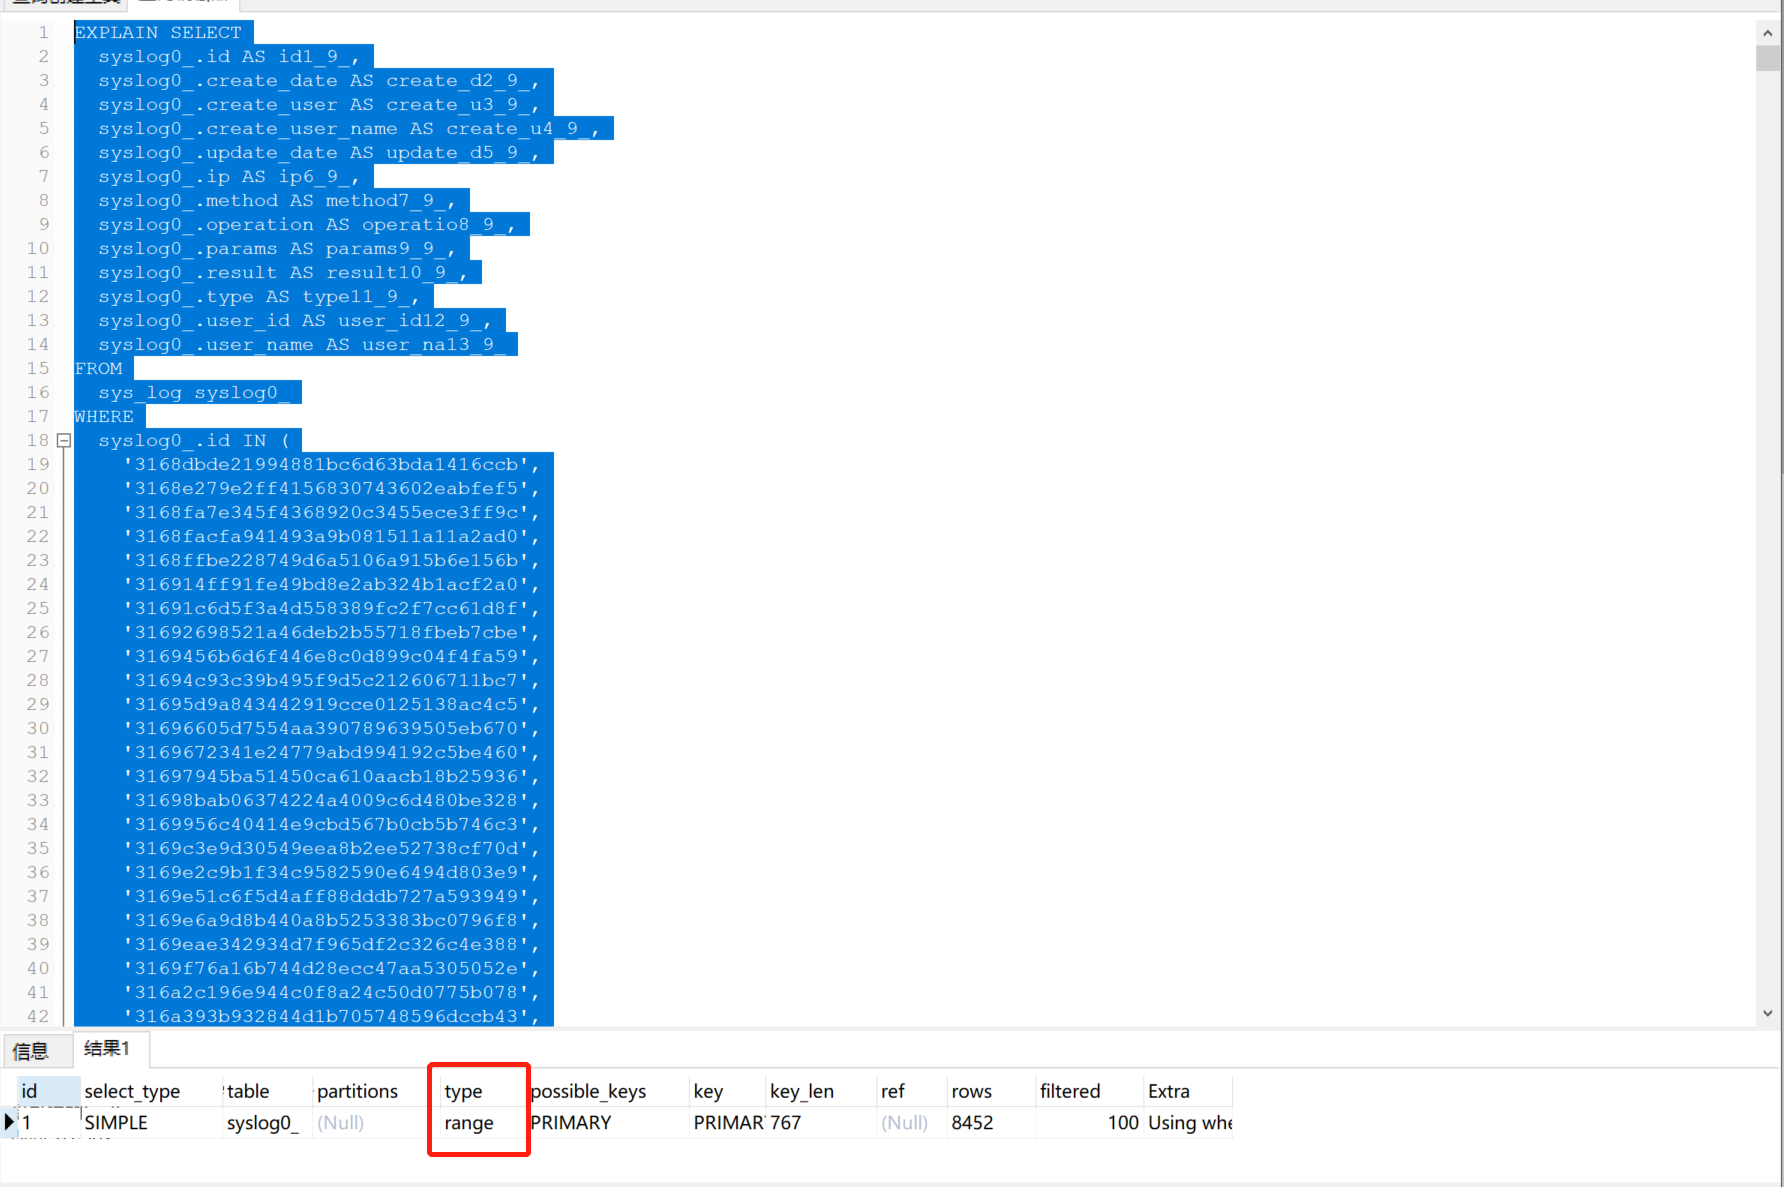
事实上,这个神奇的数字是8452。当我的表中的行总数为600000行时,为8452行。当行总数为1300000时,仍为8452。以下是我的测试截图
当in的数目为8452时,此查询只需使用0.099 s。
然后查看执行计划。范围查询
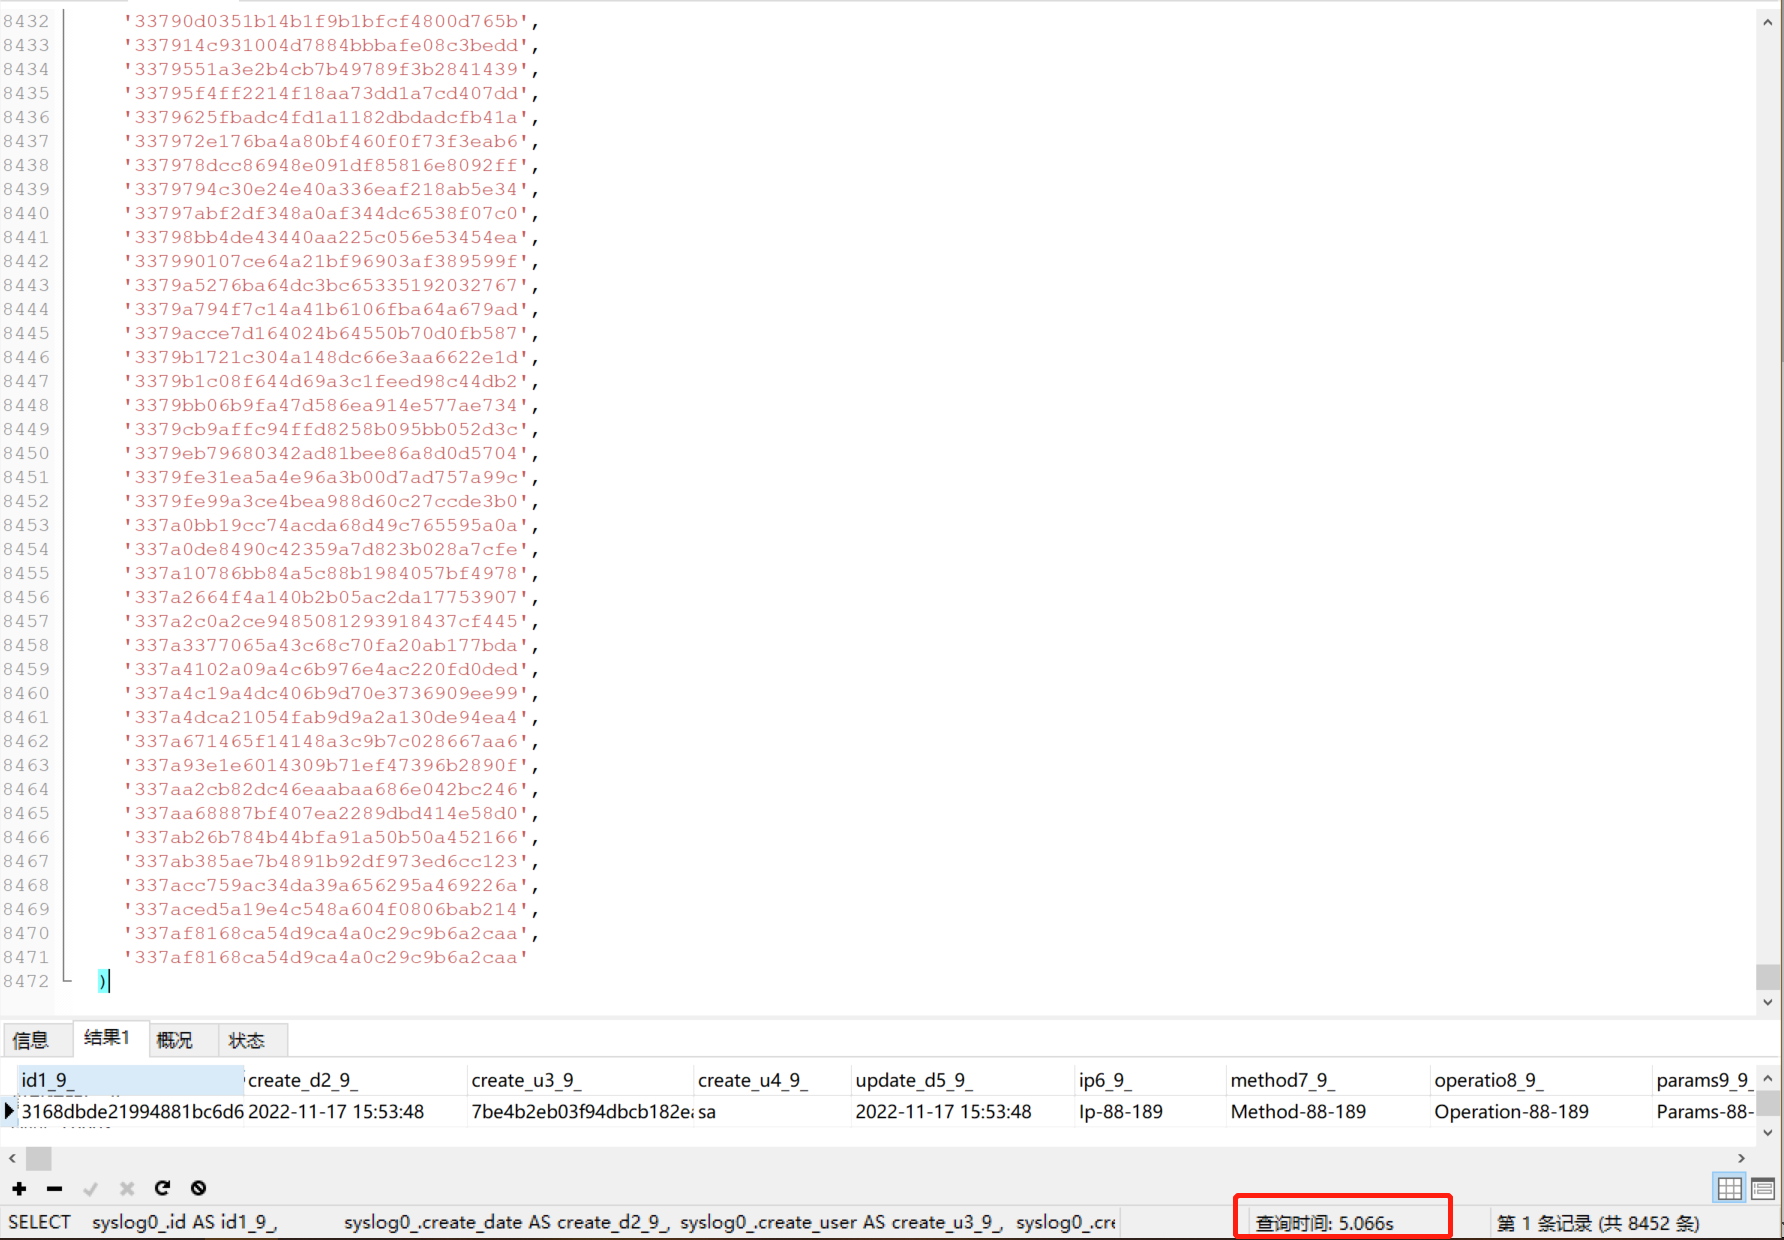
如果我将in的数目从8452增加到8453,这个查询将使用5.066s,即使我只添加了一个重复元素。
然后查看执行计划。全部输入。
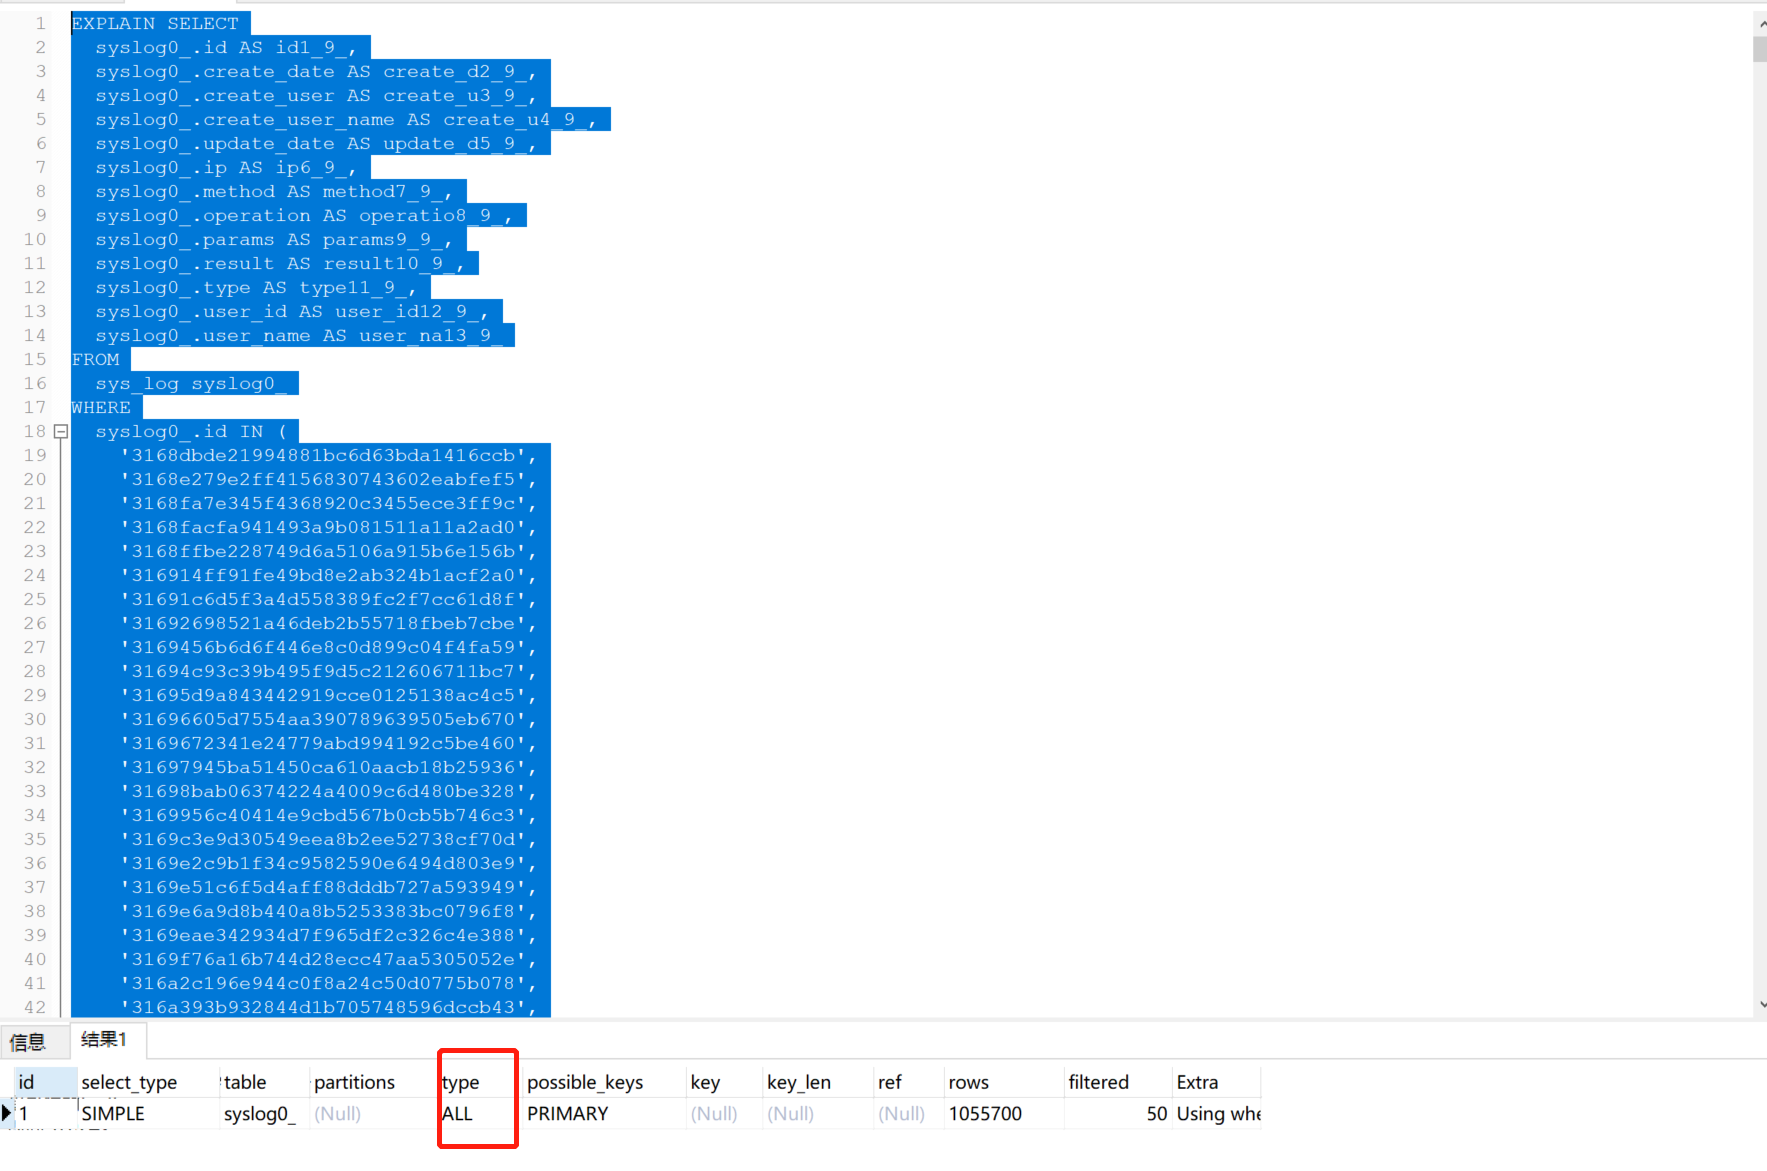
这真的很奇怪。这意味着,如果我首先以"8452 in“执行查询,然后执行其余的查询,则总时间要比直接执行"8453 in”查询的时间快得多。
谁可以调试MySQL源代码来查看在这个过程中发生了什么?
非常感谢。
回答 2
Stack Overflow用户
发布于 2022-11-17 07:37:05
很好的问题和不错的发现!
查询规划器/优化器必须决定它是要查找需要读取的页面,还是要开始读取更多的页面,并扫描所需的页面。搜索策略需要更多的内存,尤其是cpu密集型,而扫描在I/O方面可能要花费很多。
一张桌子越大,寻找策略的吸引力就越小。对于一个大的表,用于查找的非聚集索引的更大一部分需要来自磁盘,内存压力上升,连续读取的潜力缩小,查找所需的时间越长。因此,查找的行/结果比率的阈值随着表大小的增加而降低。
如果这是一个问题,有一些事情你可以尝试调整。但是,当这是生产中的一个问题时,可能是考虑服务器升级、优化所涉及的查询和软件或简单地调整期望的正确时机。
optimized)
- Optimize
- ‘Harden’或(Re)强制执行查询计划--您希望
- 调整引擎(当这是影响大多数表、服务器/数据库设置的问题时,可能是indexes
- Provide非聚集查询提示、
- 、更改表和数据类型
。
Stack Overflow用户
发布于 2022-11-17 18:04:36
通常情况下,分两个步骤执行查询是愚蠢的。该框架似乎是在一个步骤中获取ids,然后在第二个步骤中获取真正的ids。
如果将这两个查询组合成一个on (带有一个JOIN),那么优化器主要是被迫进行随机查找。
"Range“可能总是IN查找的”类型“。别把任何东西都读进去。IN是否着眼于min和max以尽量减少磁盘点击率--我认为这是最近的优化。(我在Changelogs没有。)
那些带有破折号的UUID被移除了吗?它们不能很好地扩展到大桌子上。
“基数”只是一个估计。ANALYZE TABLE强制对这些统计数据进行重新计算。看看这是否改变了边界等。
https://stackoverflow.com/questions/74470431
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号