
基于Hadoop的大数据批和流数据管道
基于Hadoop的大数据批和流数据管道
提问于 2022-11-14 07:25:10
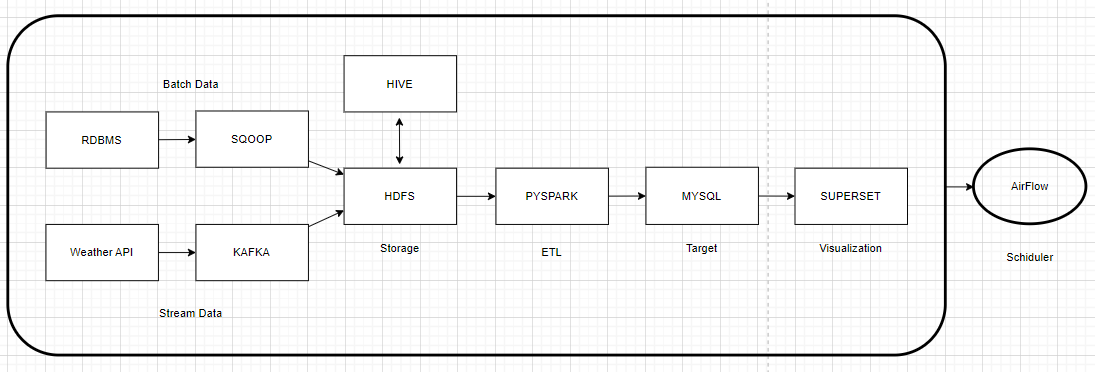
我正在设计下面的流程,并想知道我是否以正确的方式。我想跳过任何不必要的步骤,如果添加。我在火花引擎上运行了Hadoop。
下面的
- 需要批量的和流式的数据。
- flow需要使用mysql来提取数据并存储在
- 组中,以便运行metedata查询
- ,然后需要使用please
h 19执行复杂的
- 操作,然后在rdbms
H 210H 111H 111数据中使用ApacheH 212H 113/code>来报告数据,整个流应该由调度程序来运行,因为使用气流可以检查和建议是否遗漏了一些东西,以便使这种流的鲁棒性<>H 214/code>。
回答 1
Stack Overflow用户
发布于 2022-11-14 21:49:16
使用Debezium从RDBMS中提取。因此,所有的写作都以卡夫卡结尾,你根本就没有“批次”。(Sqoop是一个退休的Apache项目)
使用阿帕奇皮诺或德鲁伊直接摄入卡夫卡。那么你就不需要HDFS了。
您可以使用SQL查询Pinot / Druid。或者您可以使用Presto代替Hive/SparkSQL,您应该能够将SuperSet链接到Presto,而不是中间的RDMBS。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/74428163
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号