
如何计算一个阈值之前的累积和,并在达到阈值后重新设置它,考虑到大熊猫的数据群在蟒蛇中的数据?
如何计算一个阈值之前的累积和,并在达到阈值后重新设置它,考虑到大熊猫的数据群在蟒蛇中的数据?
提问于 2022-10-17 23:15:35
我有这样的数据:
import pandas as pd
import numpy as np

data={'trip':[1,1,1,1,1,1,1,1,1,1,1,1,2,2,2,2,2,2,2,2,2,2,3,3,3,3],
      'timestamps':[1235471761, 1235471763, 1235471765, 1235471767, 1235471770, 1235471772, 1235471776, 1235471779, 1235471780, 1235471789,1235471792,1235471793,1235471829,1235471833,1235471835,1235471838,1235471844,1235471847,1235471848,1235471852,1235471855,1235471859,1235471900,1235471904,1235471911,1235471913]}

df = pd.DataFrame(data)
df['TimeDistance'] = df.groupby('trip')['timestamps'].diff(1)
df
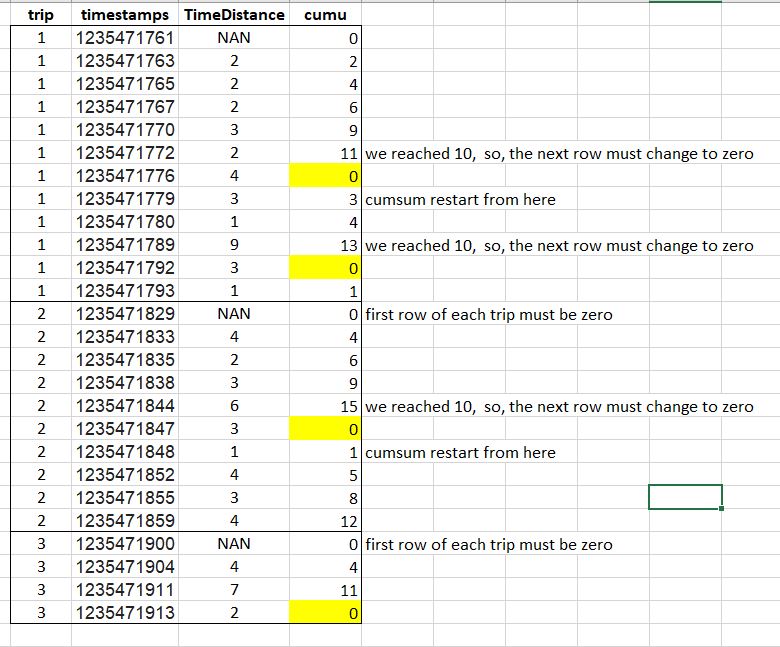
我要寻找的是从"TimeDistance“列中的第一行开始(将其视为原点),并对其值进行累计和,每当该总和达到10时,重新启动累计和,并继续此过程直到行程结束(如您在此数据文件中所看到的,我们在" trip”列中有3次旅行)。我希望所有的累积和在一个新的列,让我们说,“累积”列。另一个重要问题是,在达到阈值之后,"cumu“列中的下一行阈值必须为零,并且从这个新起点重新启动求和。
回答 2
Stack Overflow用户
回答已采纳
发布于 2022-10-17 23:35:11
我希望我已经正确理解了你的问题。您可以在.send()中使用生成器
def my_accumulate(maxval):
    val = 0
    yield
    while True:
        if val < maxval:
            val += yield val
        else:
            yield val
            val = 0


def fn(x):
    a = my_accumulate(10)
    next(a)
    x["cumu"] = [a.send(v) for v in x["TimeDistance"]]
    return x


df = df.groupby("trip").apply(fn)
print(df)
指纹:
    trip  timestamps  TimeDistance  cumu
0      1  1235471761           NaN   0.0
1      1  1235471763           2.0   2.0
2      1  1235471765           2.0   4.0
3      1  1235471767           2.0   6.0
4      1  1235471770           3.0   9.0
5      1  1235471772           2.0  11.0
6      1  1235471776           4.0   0.0
7      1  1235471779           3.0   3.0
8      1  1235471780           1.0   4.0
9      1  1235471789           9.0  13.0
10     1  1235471792           3.0   0.0
11     1  1235471793           1.0   1.0
12     2  1235471829           NaN   0.0
13     2  1235471833           4.0   4.0
14     2  1235471835           2.0   6.0
15     2  1235471838           3.0   9.0
16     2  1235471844           6.0  15.0
17     2  1235471847           3.0   0.0
18     2  1235471848           1.0   1.0
19     2  1235471852           4.0   5.0
20     2  1235471855           3.0   8.0
21     2  1235471859           4.0  12.0
22     3  1235471900           NaN   0.0
23     3  1235471904           4.0   4.0
24     3  1235471911           7.0  11.0
25     3  1235471913           2.0   0.0
另一种解决办法是:
df = df.groupby("trip").apply(
    lambda x: x.assign(
        cumu=(
            val := 0,
            *(
                val := val + v if val < 10 else (val := 0)
                for v in x["TimeDistance"][1:]
            ),
        )
    ),
)
print(df)Stack Overflow用户
发布于 2022-10-17 23:52:56
Andrej的答案更好一些,因为我的答案可能没有那么有效,这取决于由trip命令的df和作为每次旅行的第一个值的TimeDistance是nan。
cummulative_sum = 0
df['cumu'] = 0

for i in range(len(df)):
    if np.isnan(df.loc[i,'TimeDistance']) or cummulative_sum >= 10:
        cummulative_sum = 0
        df.loc[i, 'cumu'] = 0
    else:
        cummulative_sum += df.loc[i,'TimeDistance']
df.loc[i, 'cumu'] = cummulative_sumprint(df)输出:
    trip  timestamps  TimeDistance  cumu
0      1  1235471761           NaN     0
1      1  1235471763           2.0     2
2      1  1235471765           2.0     4
3      1  1235471767           2.0     6
4      1  1235471770           3.0     9
5      1  1235471772           2.0    11
6      1  1235471776           4.0     0
7      1  1235471779           3.0     3
8      1  1235471780           1.0     4
9      1  1235471789           9.0    13
10     1  1235471792           3.0     0
11     1  1235471793           1.0     1
12     2  1235471829           NaN     0
13     2  1235471833           4.0     4
14     2  1235471835           2.0     6
15     2  1235471838           3.0     9
16     2  1235471844           6.0    15
17     2  1235471847           3.0     0
18     2  1235471848           1.0     1
19     2  1235471852           4.0     5
20     2  1235471855           3.0     8
21     2  1235471859           4.0    12
22     3  1235471900           NaN     0
23     3  1235471904           4.0     4
24     3  1235471911           7.0    11
25 3 1235471913 2.0 0页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/74104136
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号