
根据应用于数据子集的不同条件从DataFrame中删除行
根据应用于数据子集的不同条件从DataFrame中删除行
提问于 2022-09-22 05:54:53
下面是我正在与之合作的Dataframe:
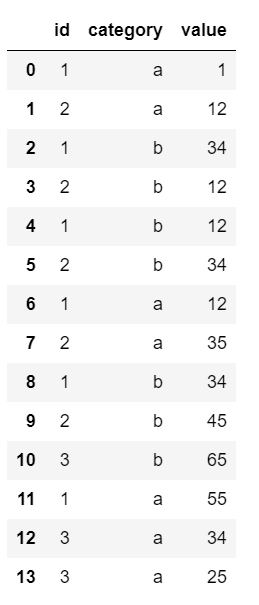
您可以使用代码片段创建它:
my_dict = {'id': [1,2,1,2,1,2,1,2,1,2,3,1,3, 3],
           'category':['a', 'a',  'b', 'b', 'b', 'b',  'a', 'a',  'b', 'b', 'b', 'a', 'a', 'a'],
           'value' : [1, 12, 34, 12, 12 ,34, 12, 35, 34, 45, 65, 55, 34, 25]
          }
x = pd.DataFrame(my_dict)
x
我想根据条件筛选id :对于类别a,值的计数应该是2,对于类别b,值的计数应该是3。因此,我将从类别a中删除id 1,从原始数据集x中删除类别b中的id 3。
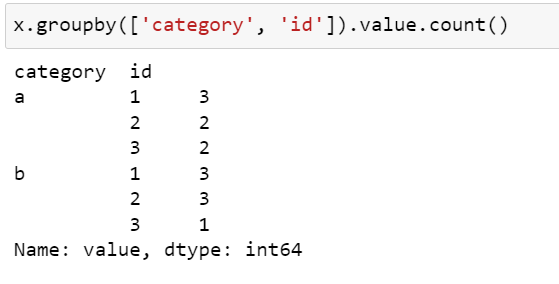
我可以为各个类别编写代码,并通过使用以下代码开始手动删除id:
x.query('category == "a"').groupby('id').value.count().loc[lambda x: x != 2]
x.query('category == "b"').groupby('id').value.count().loc[lambda x: x != 3]
但是,我不想手动做,因为有多个类别。是否有更好的方法同时考虑所有类别,并根据列表/字典中列出的条件删除id?
回答 1
Stack Overflow用户
回答已采纳
发布于 2022-09-22 06:01:08
如果需要,可以通过字典过滤MultiIndex Series - s,使用Index.get_level_values和Series.map,并在boolean indexing中获得每个组的等量值。
s = x.groupby(['category','id']).value.count()

d = {'a': 2, 'b': 3}
print (s[s.eq(s.index.get_level_values(0).map(d))])
category  id
a         2     2
          3     2
b         1     3
          2     3
Name: value, dtype: int64
如果需要过滤原始DataFrame:
s = x.groupby(['category','id'])['value'].transform('count')
print (s)
0     3
1     2
2     3
3     3
4     3
5     3
6     3
7     2
8     3
9     3
10    1
11    3
12    2
13    2
Name: value, dtype: int64

d = {'a': 2, 'b': 3}
print (x[s.eq(x['category'].map(d))])
    id category  value
1    2        a     12
2    1        b     34
3    2        b     12
4    1        b     12
5    2        b     34
7    2        a     35
8    1        b     34
9    2        b     45
12   3        a     34
13 3 a 25页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/73809904
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号