
快速傅立叶变换得到两幅图像的相似性
我的目标是能够得到百分比的相似性之间的2个图像。
问题是,在这种情况下,我对相似性的定义是很特殊的。
下面是一些我想要达到的目标的例子:
图像A
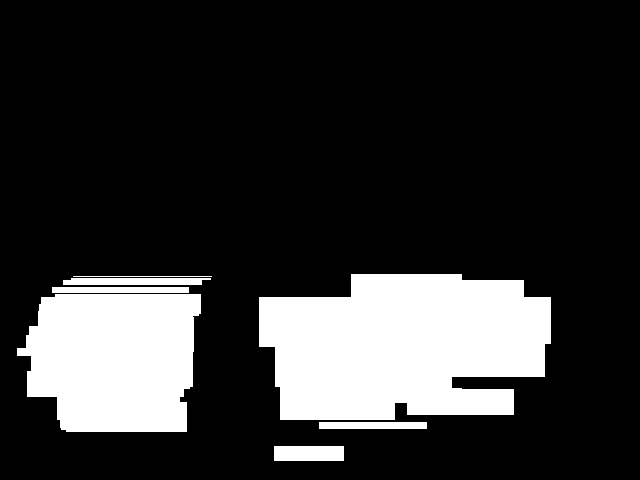
类似于
图像A双
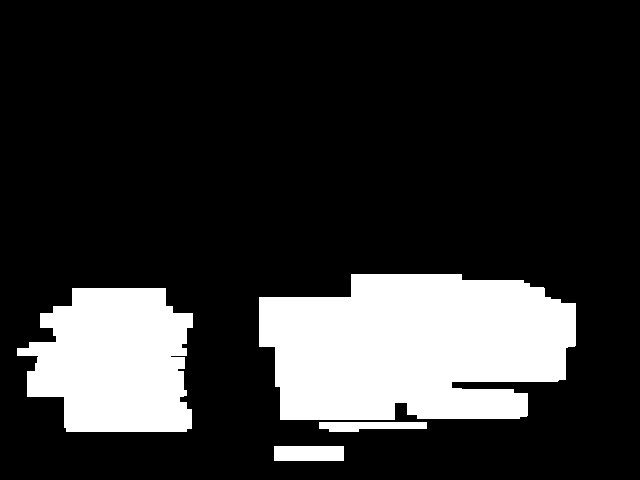
然而,
图像B
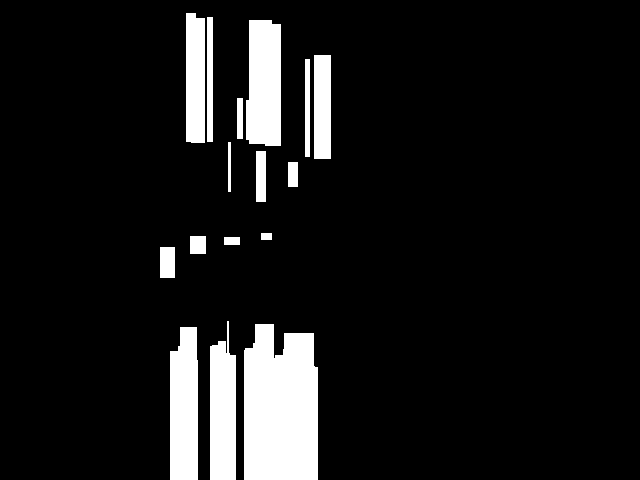
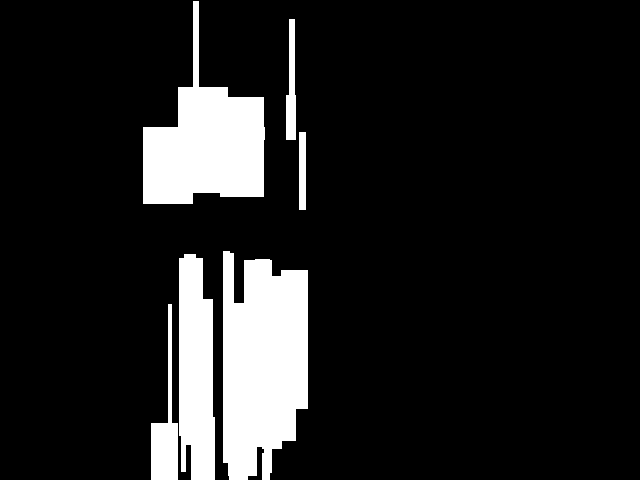
不类似于图像A(或A之二),而是类似于
图像B双
我已经试过遵循这里描述的方法:用OpenCV检查图像的相似性,但在我的情况下,它不起作用.事实上,与图像A之二相比,黑色背景更接近图像A。
PS :我也尝试了颜色,但结果是一样的:
图像--彩色
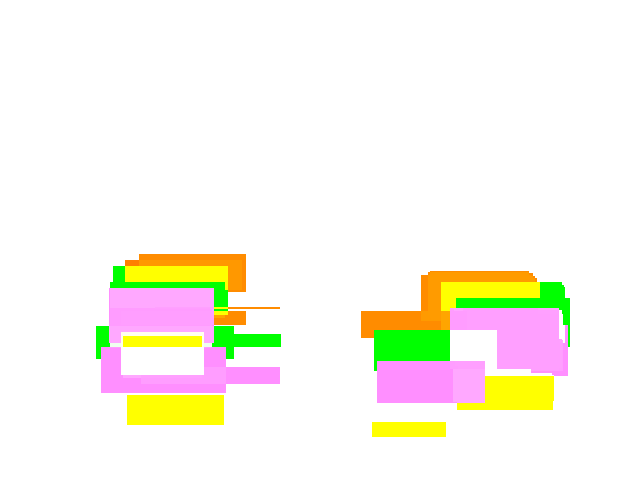
图像双色
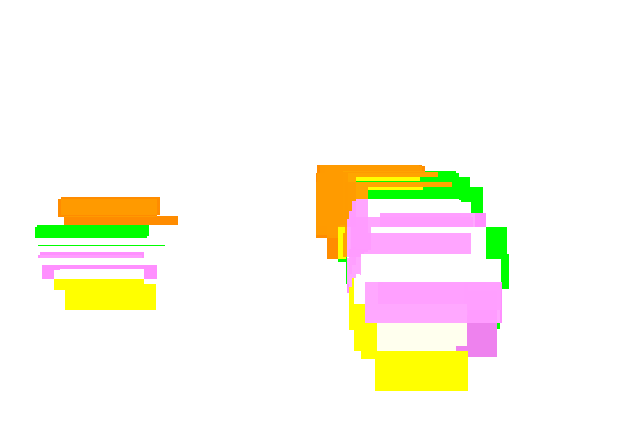
图像B色
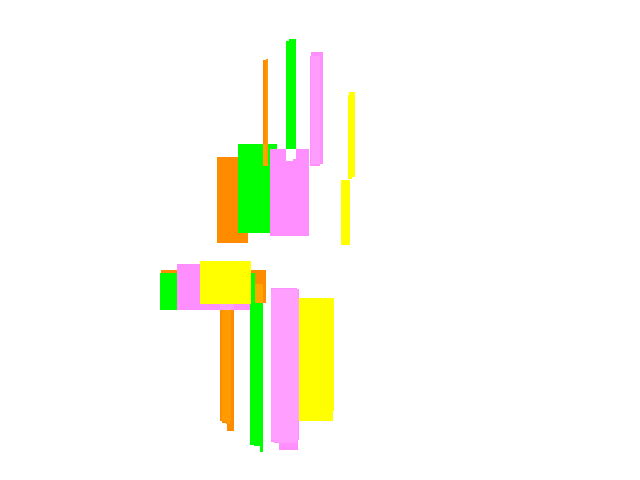
我做了更多的研究,有人告诉我,使用快速傅立叶变换( FFT )和openCV (这就是我使用的),我可以实现我想要的东西。
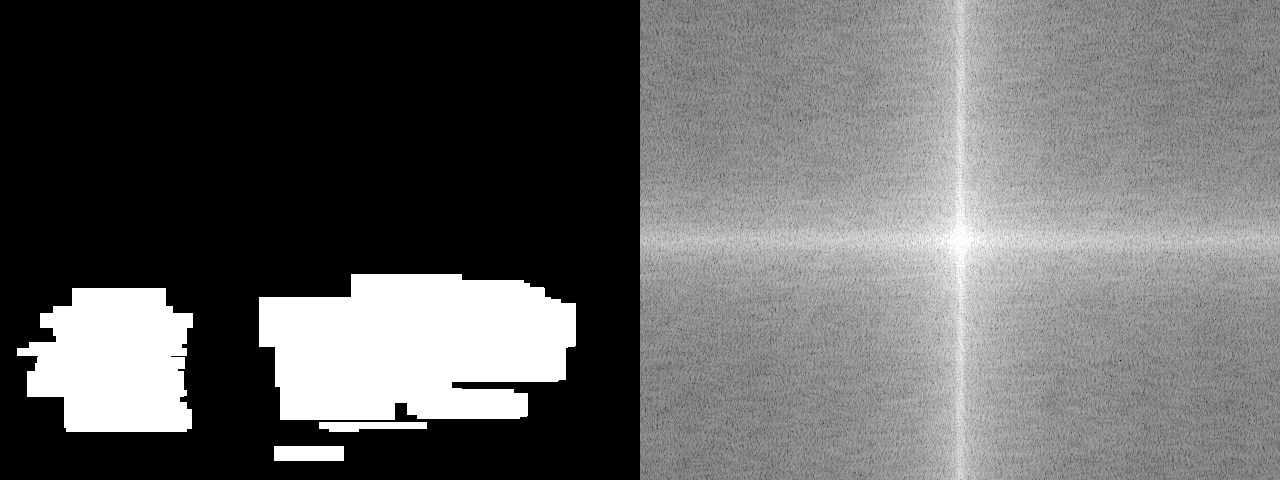
在应用FFT时,我得到的是:
图像快速傅里叶变换
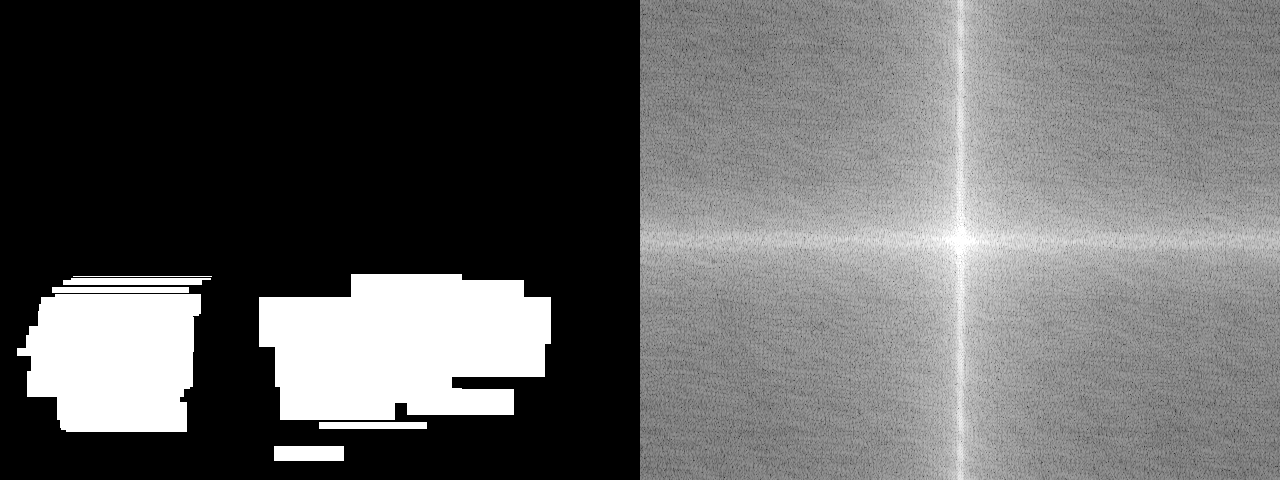
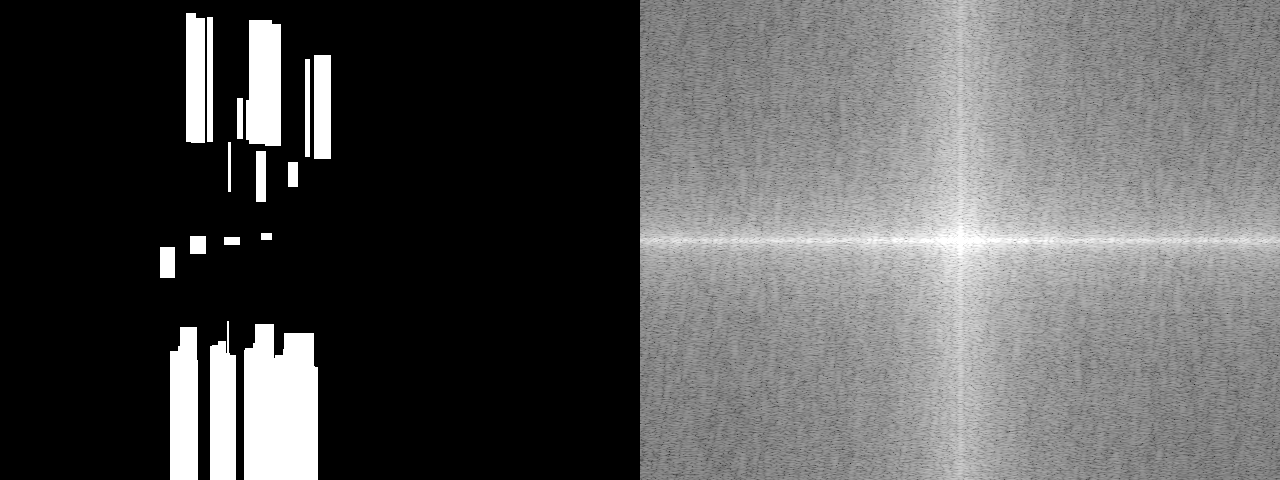
图像双FFT
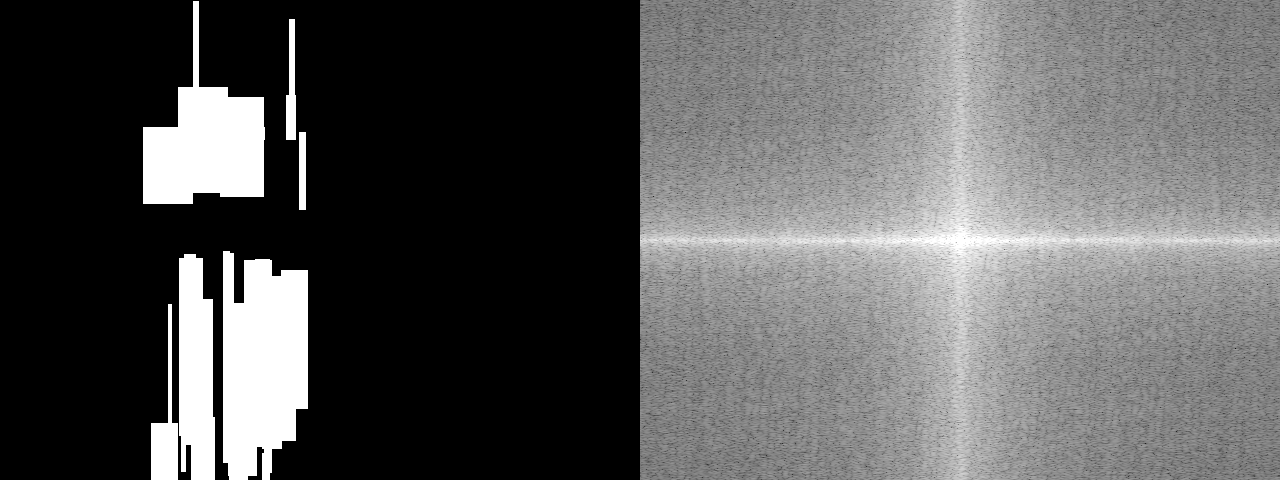
图像B FFT
图像B双FFT
这就引出了以下问题: FFT真的是要走的路吗?如果是的话,我能用我的震级谱做些什么?如果没有,还有别的办法可以解决我的问题吗?
PS :我宁愿不使用ML或可能的深度学习id。
谢谢!(对图像的数量表示遗憾)
编辑1:
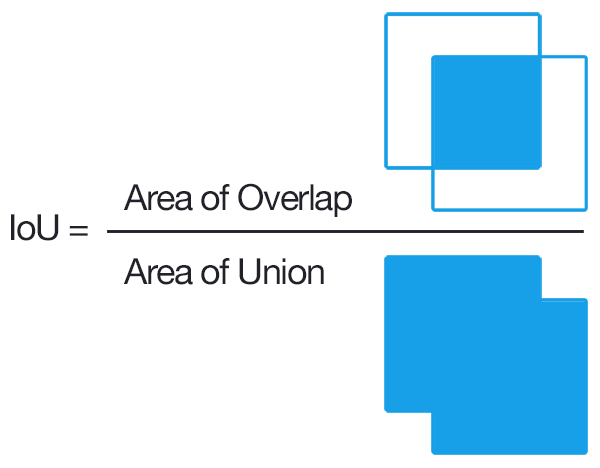
您的度量可以是与逻辑和两幅图像相除的重叠像素数。
为什么到目前为止我还没有这样做:因为有时候,您在示例中看到的表单可能在图像的顶部,因为我的示例中的表单位于图像的底部。此外,一种形式可能比示例中的小得多,尽管它们仍然是一样的。
编辑2:
我在寻找当地的相似之处。事实上,只要表单本身与示例形状相同,大小就不重要了。可能更大,更小,在顶部,底部。这都是关于形状的问题。然而,对于形式必须是在相同的方向和旋转。
例如,这里有两个必须归类为图像A的图像:
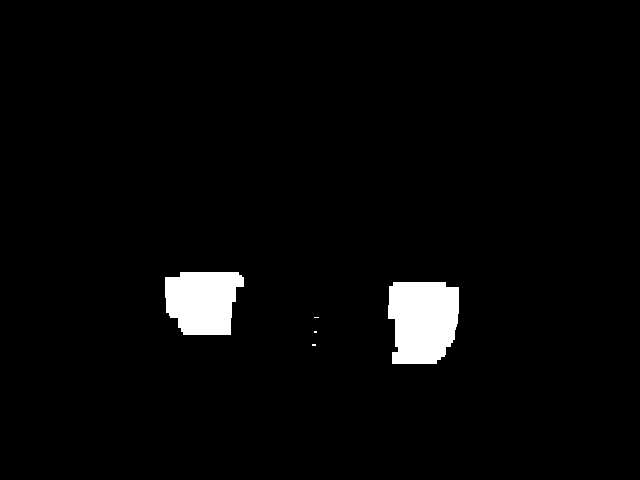
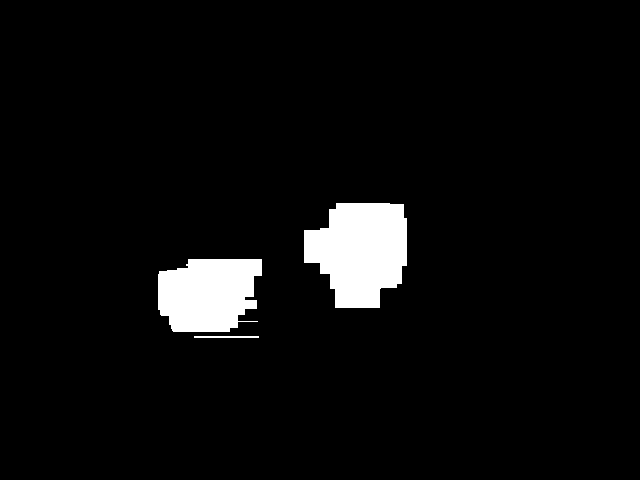
编辑3:
你看到的图片是一个手运动的30个叠帧。这就是为什么在图片A*你看到两个小块->从左到右滑动,而AI没有检测到中间的手。因为滑动不是完美的,这就是为什么“斑点”不是在同一高度的每一次。此外,如果手靠近相机,你会得到图像A,如果是更远,你将得到图像A之二的编辑2部分。
编辑4:
当我尝试使用@Christoph答案时,IoU的问题是,它在images和images更小的情况下不起作用(参见编辑2图像)。
回答 1
Stack Overflow用户
发布于 2022-07-15 16:34:24
files = [ "A svk5g.png", "A bis aWBFd.png", "B x8214.png", "B bis b3Bdw.png" ]
ims = [cv.imread(f, cv.IMREAD_GRAYSCALE).astype(bool) for f in files]

def iou(a, b):
    return np.sum(a & b) / np.sum(a | b)

scores = np.array([[iou(a,b) for b in ims] for a in ims])array([[1. , 0.88364, 0.07373, 0.08069],
[0.88364, 1. , 0.06857, 0.06803],
[0.07373, 0.06857, 1. , 0.30637],
[0.08069, 0.06803, 0.30637, 1. ]])所以你看,88%的匹配之间"A“和"A之二”,只有30%的匹配"B“和"B之二”,7-8%之间的A*和B*。
https://stackoverflow.com/questions/72996111
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号