
如何避免read_sql输出中的行号
如何避免read_sql输出中的行号
提问于 2022-06-15 05:33:54
当我使用熊猫read_sql从mysql读取时,它返回行号为第一列的行,如下所示。这样可以避免行号吗?
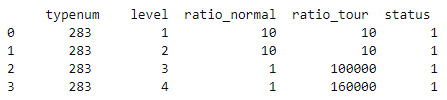
回答 2
Stack Overflow用户
回答已采纳
发布于 2022-06-15 05:52:31
您可以使用False作为第二个参数来排除索引。
示例
df.to_csv('filename.csv', index = False, encoding='utf-8')
print(df)
或
df.toPandas().to_csv('filename.csv', index=False, encoding='utf-8')
print(df)
使用此功能指导您
DataFrame.to_csv(self, path_or_buf=None, sep=', ', na_rep='', float_format=None, columns=None, header=True, index=True, index_label=None, mode='w', encoding=None, compression='infer', quoting=None, quotechar='"', line_terminator=None, chunksize=None, date_format=None, doublequote=True, escapechar=None, decimal='.')您可以在这里阅读更多关于-> csv()函数的内容。
Stack Overflow用户
发布于 2022-06-15 05:45:59
谢谢大家。我需要将行导出到CSV到可视化程序。所以行号是不需要的。在熊猫的csv函数中,我设置了index=False以避免显示指数。这起作用了。谢谢你们的帮助。干杯
df.toPandas().to_csv('output.csv', index=False)页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/72626332
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号