
R (id)中的转位
我发现在转置后,原来的列变量现在变成了R本身的数据集中的id。如何更改R的id,我希望id是(1,2,3按数字顺序,而不是我原来的列变量的名称)。
这是我的原始数据集
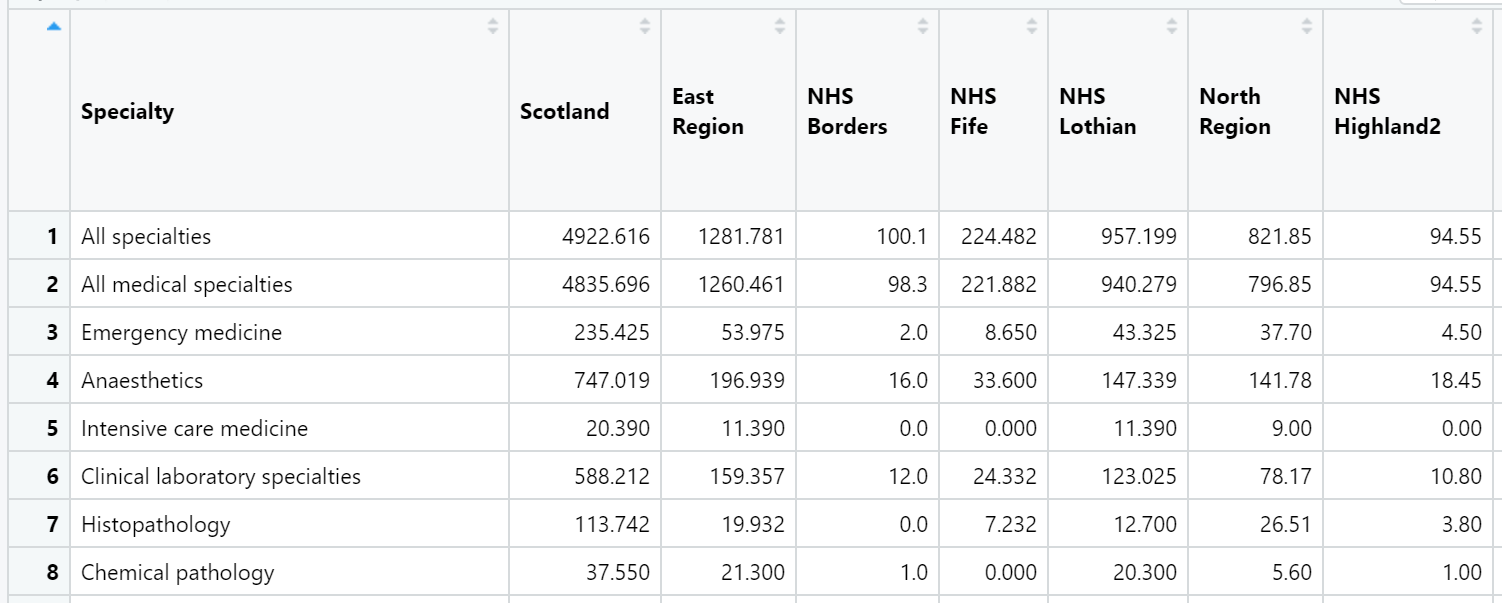
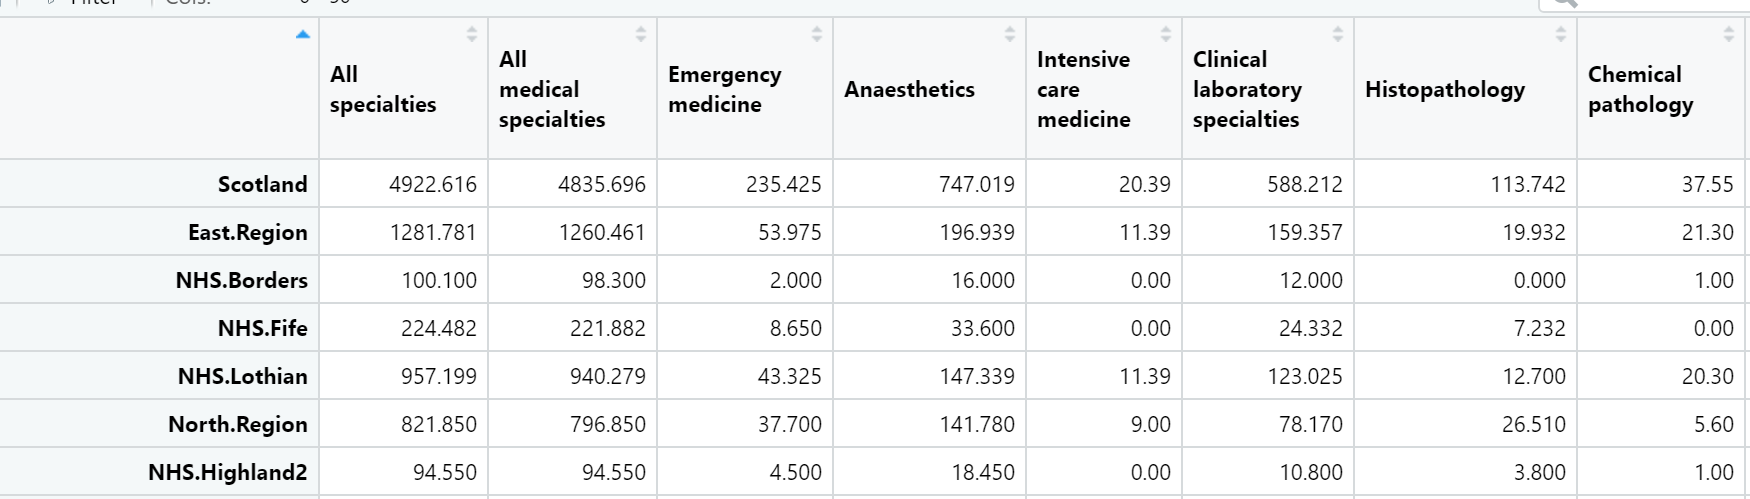
当我做转置时,我得到了这个数据集
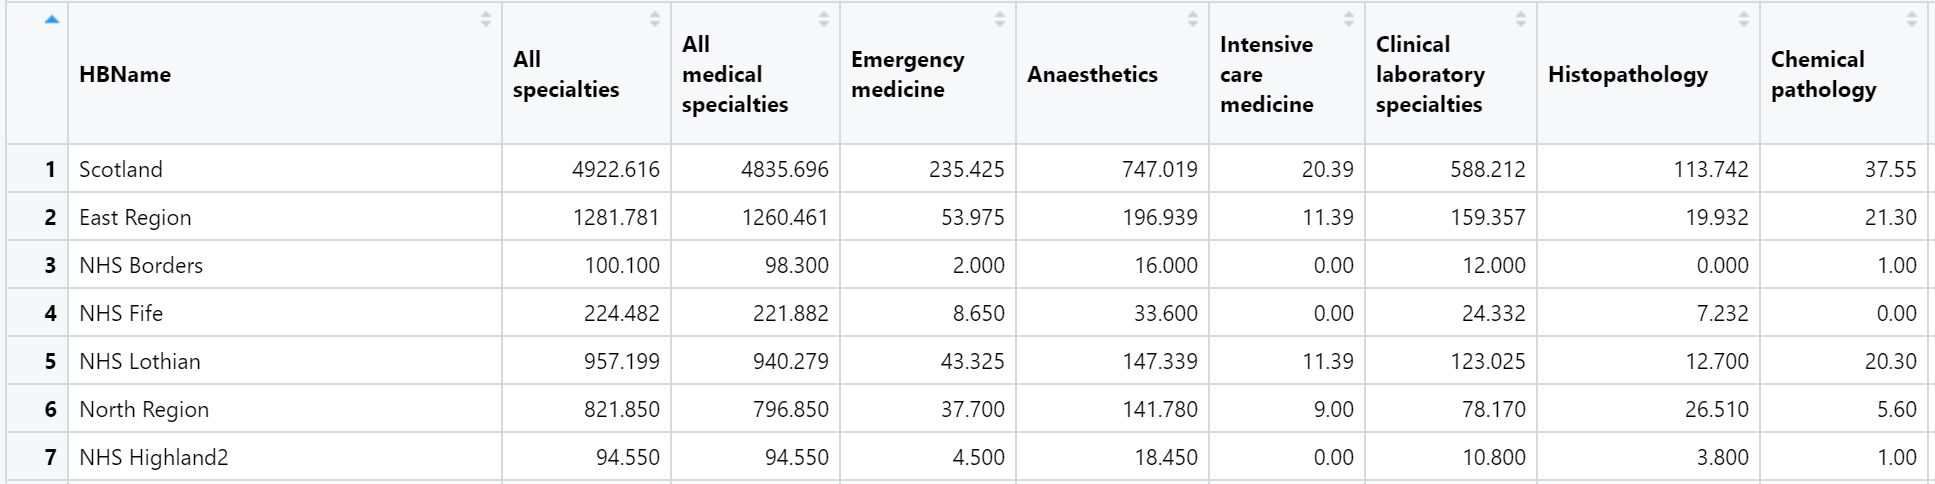
我希望我的转置数据集的id看起来像这样。
这是我的硬代码con <- read_csv("")
t1 <- t(data.frame(con,row.names=1))
t2 <- as.data.frame(t1,row.names=F)
HBName <- c(“苏格兰”、“东部地区”、“国民保健服务边界”、“国民保健服务框架”、“国民保健服务Lothian”、“北部地区”、"NHS Highland2")
t3 <- as.data.frame(HBName,t2)
我如何做到这一点,有什么简单的方法来做它,即使我已经硬编码它来做我想要的。
回答 1
Stack Overflow用户
发布于 2022-06-04 11:39:31
您的问题不清楚,您只为您的数据集提供了一个。所以假设你的原始数据看起来像下面给出的,
> df
                 Scotland East Region
All specialities 4922.616    1281.781
所以当你把上面给定的数据转换成行名时,
> df <- t(df)
> df
                    All specialities
Scotland            4922.616
East Region 1281.781若要将speciality名称保留为列,可以将行名保存为speciality列,如下所示,
> df$speciality <- rownames(df)
> df
                All.specialities  speciality
  Scotland            4922.616    Scotland
  East Region         1281.781 East Region
然后,为了将行名更改为1,2,3,您可以将dataframe的行名指定为NULL,
 > rownames(df) <- NULL
 > df
           All.specialities  speciality
 1         4922.616          Scotland
 2         1281.781          East Region
最好的
https://stackoverflow.com/questions/72499071
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号