
Python循环来填充缺少的列值。
Python循环来填充缺少的列值。
提问于 2022-03-23 20:45:57
我有一个数据框架df,列"TotalVolume“、”小“、”大“、"AllSizes”和"TotalBags“是相关的。在这里,TotalVolume是其他四列的总和。
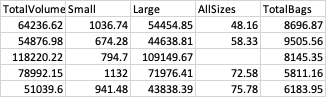
如何循环数据帧列以查看哪些条目为空,然后用从其他列派生的值填充缺失的值?例如,如果"AllSizes“列中缺少一个值,那么代码将遍历第一列、第二列、第三列和第四列,看到它缺少一个值,并使用第四个命令来填充缺失的值。
预期产出:
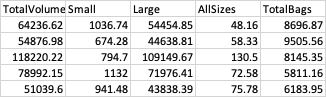
第一、第二、第三、第四、第五命令:
df['TotalVolume'] = df['Small'] + df['Large'] + df['AllSizes'] + df['TotalBags']
df['Small'] = df['TotalVolume'] - df['Large'] - df['AllSizes'] - df['TotalBags']
df['Large'] = df['TotalVolume'] - df['Small'] - df['AllSizes'] - df['TotalBags']
df['AllSizes'] = df['TotalVolume'] - df['Small'] - df['Large'] - df['TotalBags']
df['TotalBags'] = df['TotalVolume'] - df['Small'] - df['Large'] - df['AllSizes']回答 1
Stack Overflow用户
发布于 2022-03-23 21:07:06
首先,循环遍历数据(例如,使用迭代或迭代行)应该始终作为最后手段使用,因为它效率低、速度慢(这里将详细介绍:https://stackoverflow.com/a/24871316/18480015)。
假设您只有5列,您可以使用lambda函数复制您编写的代码:
df['AllSizes'] = df.apply(
lambda row: row['TotalVolume']-row['Small']-row['Large']-row['TotalBags']
if np.isnan(row['AllSizes']) else row['AllSizes'], axis=1)
其他栏目的情况如下:
df['TotalBags'] = df.apply(
lambda row: row['TotalVolume']-row['Small']-row['Large']-row['AllSizes']
if np.isnan(row['AllSizes']) else row['AllSizes'], axis=1)
等等。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/71593834
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号