
从列中的元素创建新行
从列中的元素创建新行
提问于 2022-02-18 22:30:17
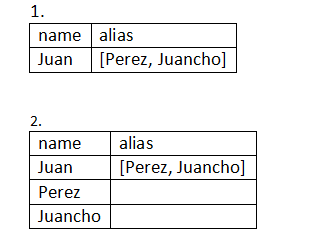
我有一个dataframe,它有两个字段,名称和别名。如果出现一个或多个别名,则必须为每个别名创建一个新行,并将name字段替换为别名字段。我有一个类似于第一个表的东西,它看起来应该像第二个表,使用熊猫在python中。提前感谢
回答 1
Stack Overflow用户
发布于 2022-02-19 00:53:23
IIUC,您希望添加行以获取所有可能的名称和别名作为行。
您可以获得所有唯一的名称,如set和reindex
out = (
 df.set_index('name')
   .reindex(set(df['name']).union(*df['alias']))
   .reset_index()
 )
输出:
      name             alias
0     Juan  [Perez, Juancho]
1    Perez               NaN
2 Juancho NaN或将“别名”转换为重命名的DataFrame和concat。
out = (
 pd.concat([df,
            df['alias'].explode().rename('name').to_frame()
          ])
   .sort_index(kind='stable')
)
输出:
      name             alias
0     Juan  [Perez, Juancho]
0    Perez               NaN
0  Juancho               NaN
已使用的投入:
df = pd.DataFrame({'name': ['Juan'],
'alias': [['Perez', 'Juancho']]})页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/71180588
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号