
列在名单上吗?
列在名单上吗?
提问于 2022-02-09 17:40:41
我试图做一个正则表达式来匹配字符按字母顺序排列的字符串,例如"ab",而不是"ba“。以下是我的尝试:(.)[\1-z]。它捕获第一个字符并将其用于列表中范围的开头。但是,在[]中,\1的意思是U+0001,因此它匹配任意两个字符:
>>> re.search("(.)[\1-z]", "ab")
<re.Match object; span=(0, 2), match='ab'>
>>> re.search("(.)[\1-z]", "ba")
<re.Match object; span=(0, 2), match='ba'>
如何在字符列表中备份捕获的字符?
回答 2
Stack Overflow用户
发布于 2022-02-09 17:48:33
你得把它完全拼出来,即a*b*c*d*.....。
以下是你如何做到这一点:
regex = "(?=.)" + "*".join(map(chr, range(97, 123))) + "*"
s = "afkdiolsieyrnbsgdysoepkzavfz"
print(re.findall(regex, s))Stack Overflow用户
发布于 2022-02-09 18:54:18
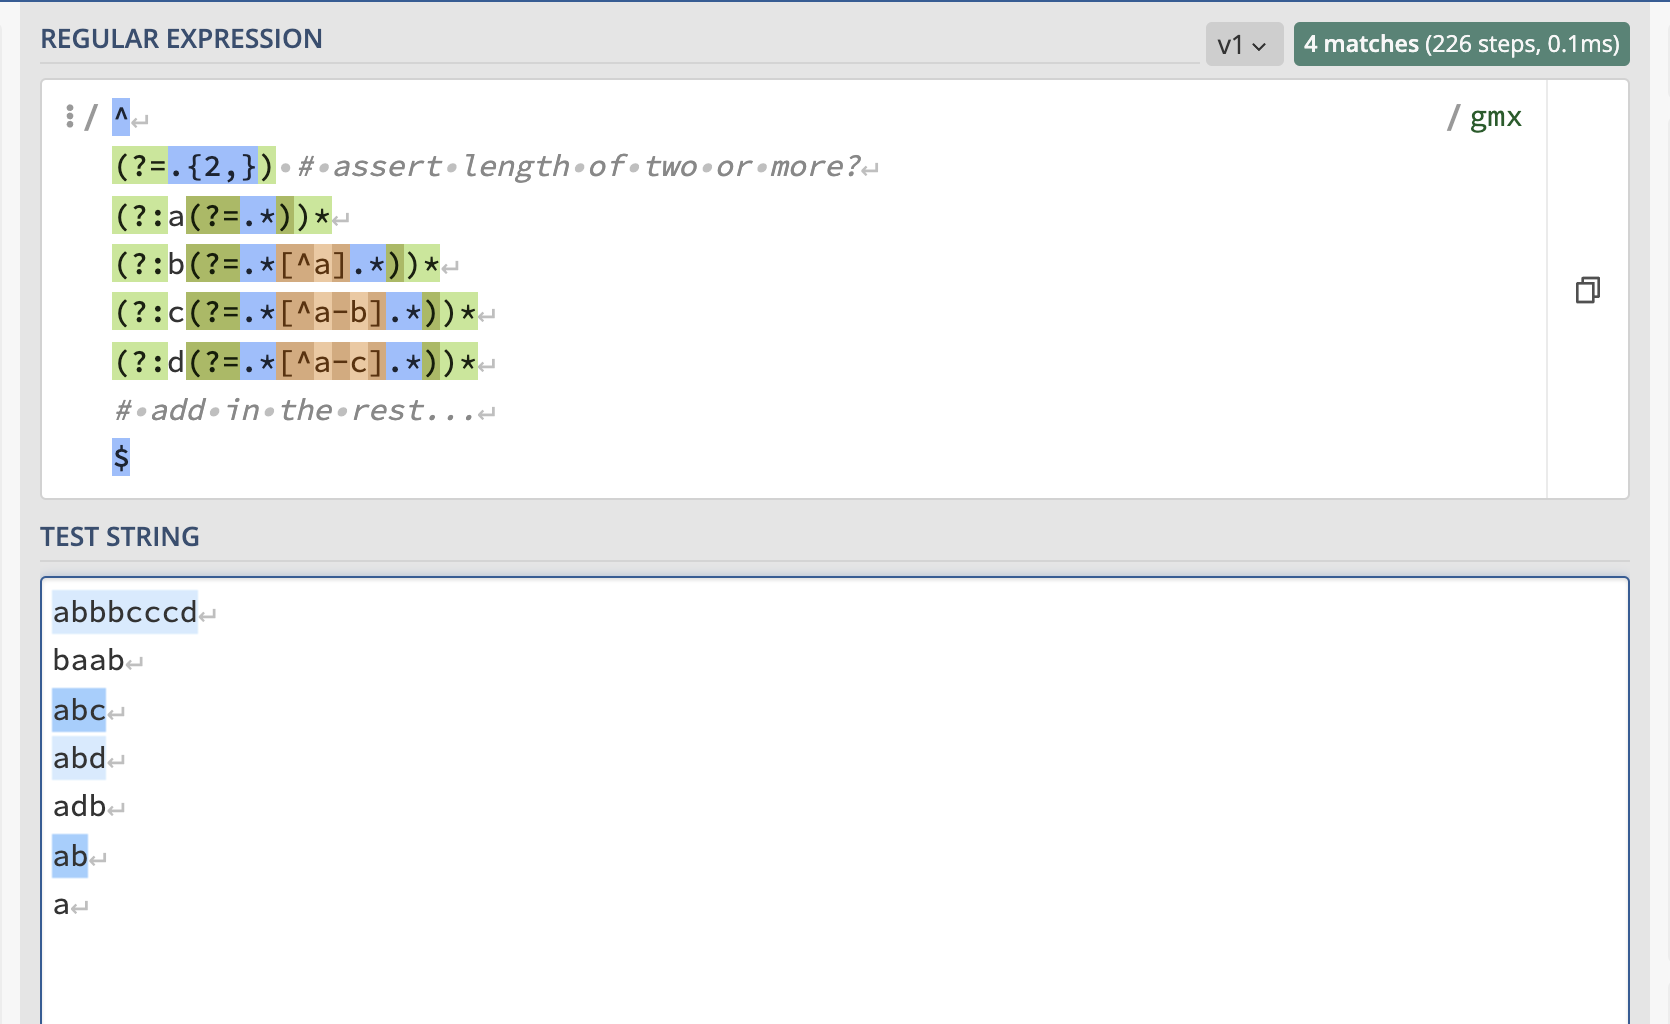
我想你可以创建一个长的正则表达式,它只检查每个字母,以确保它不会被一个较低字典级别的字母所取代。例如:
^
  (?=.{2,}) # assert length of two or more?
  (?:a(?=.*))*
  (?:b(?=.*[^a].*))*
  (?:c(?=.*[^a-b].*))*
  (?:d(?=.*[^a-c].*))*
  # add in the rest...
$下面是一个工作示例的链接:
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/71054251
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号