
如何在不加索引的情况下改进MySQL中的“选择最小(My_col)”查询
下面的查询大约需要一分钟才能在我的MySQL实例上运行(运行在具有64G内存、2T磁盘、2.30GHzCPU 8核和16个逻辑的相当强大的机器上,并且查询运行在本地主机上)。在我可以访问的Server数据库上,这个查询在不到一秒钟的时间内运行。不幸的是,我无法访问Server主机或DBA等。
select min(visit_start_date)
from visit_occurrence;表已设置为ENGINE=MyISAM,default-storage-engine=INNODB和innodb_buffer_pool_size=16G设置为my.ini。
是否有什么配置可能会导致这个查询在MySQL上运行得如此缓慢?我怎么才能修好它?
我有大量需要支持的表和查询,所以我非常希望能够在全局范围内解决这个问题,而不是在查询速度慢的地方创建索引。
SQL Server数据库似乎没有查询列的索引,如下所示。
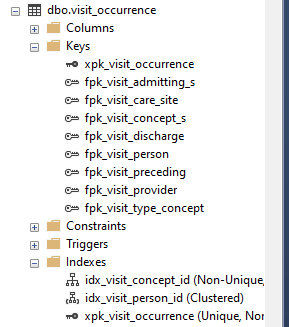
编辑:
- 取消了MySql的标记,我希望我们的MySql同事能够帮助我了解Server有某种方式来构造数据和/或查询,从而使这种类型的查询在该平台上运行得更快,比如MySql
- 删除代码的图像,使其更符合社区标准
- 如果你不问的话,你永远不知道是否有一个神奇的快速按钮(ENGINE=MyISAM有时有点像MySql中的一些查询的魔术快速按钮)。我在这里寻找一种潜在的硬件或集群解决方案。Apache是一个潜在的解决方案吗?
再次感谢社会各界的支持和帮助。我希望这能解决为这一职位提出的大部分问题。
第二个编辑:下面的链接中描述的分区/切分是一个潜在的解决方案吗?
https://user3141592.medium.com/how-to-scale-mysql-42ebd2841fa6
https://dev.mysql.com/doc/refman/8.0/en/partitioning-overview.html
第三版:关于社区标准的说明。
我们的社区标准的一部分是明确表示欢迎、包容和友好。
这里使用标记作为我比较的系统之一,即。我们处理的信息非常有限。我有两个系统:我的MySql系统(在我运行它的过程中是可知的)和MySql在别人的系统中运行的数据库,而我几乎没有关于它的信息(我所拥有的只是一个只读的Sql提示符)。我在比较苹果和桔子:相同的查询在橙色( MySql )上运行良好,在苹果(我的MySql实例)上运行不好。我想知道为什么,这样我就可以对如何在合理的时间内运行我的查询做出一个明智的决定。我怎么才能让我的苹果看起来像橘子呢?我切换到吗?我需要在不同的硬件上部署吗?另一个系统是否在它们的数据库实例之上运行某种内存缓存系统?这些可能性中的大多数都需要大量的时间来探索和验证。所以,是的,我想要make专家的帮助,这些专家可能知道是否有缓存选项、事务性v仓库选项等,这些选项可以被设置成不同的世界,这将是神奇的快速按钮。
神奇的快速按钮评论可能有点屈尊。
显示索引的图片是在我试图说明其他系统似乎没有查询列的索引时显示的。我这个案子,一幅画值一千字。
回答 2
Stack Overflow用户
发布于 2022-02-08 21:35:36
如果表上写的是ENGINE=MyISAM,那么这才是最重要的。几乎在所有情况下,这都是一个糟糕的选择。innodb_buffer_pool_size=16G与此无关,只是它从MyISAM中抢夺内存。
只有在创建显式指定default-storage-engine=INNODB的表时,才需要使用ENGINE=。
有些表是MyISAM的,有些是InnoDB的吗?你有多少内存?
大多数性能解决方案必然涉及INDEX。请解释一下为什么你买不起指数。它可以将该查询转换为小于10 of,而不管表中的行数如何。
对不起,但我不接受“而不是在任何地方创建索引,我有缓慢的查询”。
在某些情况下,将表从MyISAM更改为InnoDB将有助于提高性能。建议您在添加索引时更改引擎。
向我们展示更多的查询,我们可以帮助您决定需要哪些索引。select min(visit_start_date) from visit_occurrence;需要INDEX(date);其他查询可能不是那么简单。不要落入“索引每一列”的陷阱。
More
在MySQL..。
- 单个连接只使用一个核心,所以只有当您有更多的连接时,更多的核心才会有所帮助。( MySQL 8.0中存在一些微小的例外。)
- 分区很少对性能有所帮助;使用分区时不要得到建议。(PS:
BY RANGE可能是唯一有用的变体。) - 复制用于读取缩放(以及备份和.)
- 切分是用来写缩放的.它需要一堆额外的体系结构--比如将查询路由到适当的服务器。(MariaDB将Spider和FederatedX作为可能的工具。)在任何情况下,切分都是一项重要的工作.
- 集群是为HA (高可用性,自动故障转移等),同时帮助一些读写缩放.Cf: Galera,InnoDB集群。
- 硬件很少只是性能问题的临时解决方案。
- 缓存可能导致不一致的结果,所以要小心。另外,考虑一下我的咒语“不要把缓存放在缓存前面”。
(我可以就这些问题中的任何一个提出进一步的建议。)
Stack Overflow用户
发布于 2022-02-10 14:56:34
无论是在MyISAM还是InnoDB。甚至SQL Server,您的查询
select min(visit_start_date) from visit_occurrence;这个索引几乎是即时满足的,因为它使用了所谓的松散索引扫描。
CREATE INDEX visit_start_date ON visit_occurrence (visit_start_date);具有MIN()这样的聚合函数的查询始终是按查询分组的。但是,如果组BY子句不在SQL语句中,则服务器按整个表分组。
您提到了在使用MyISAM时可以立即满足的查询。那是SELECT COUNT(*) FROM whatever_table。在幕后,MyISAM保存表元数据,显示表中的行总数,因此查询马上返回。事务存储引擎InnoDB不这样做。它支持如此多的并发性,以至于其设计人员没有在其元数据中包含行总数,因为在许多情况下,这样做是错误的,因此不值得冒险。
索引设计不是一门黑色的艺术。但它是一门艺术,它是由我们从解释(或分析或解释分析)中得到的测量结果所决定的。数据库驱动的应用程序(在数据库服务器的任何形式中)的一个基本事实是,随着应用程序的发展,需要重新检查索引。好消息是:更改、添加或删除索引不会改变数据。
https://stackoverflow.com/questions/71040649
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号