
转换MySQL非unicode字符在C#中
我有一个PHP应用程序,它目前以非常规格式将数据存储在MySQL表中(我假设这是因为它使用的是非unicode mysql连接)。
例如,这是PHP应用程序UI中所示的客户名称之一:
迪洛里奥汽车修理店
注意,它和下面的撇号有区别。
迪洛里奥汽车修理店
后者使用一个标准的拉丁字母撇号作为对照unicode(我猜)风格。
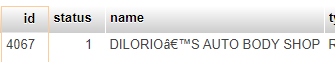
此名称存储在DB表中,如下所示:
迪洛里奥欧式™S汽车车身车间
当从DB中提取数据并在UI中显示时,这一切看起来都是正确的,但是当我开始使用MYSQL.Data C#连接器来提取相同的数据时,问题就出现了。
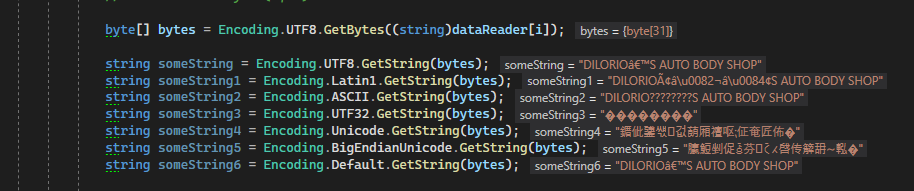
一开始,我认为我应该能够直接转换值字节数组,然后将其转换为latin1 (我假设这是PHP的默认值),但是现有的编码似乎都没有给我带来我想要的结果,这就是我得到的结果:
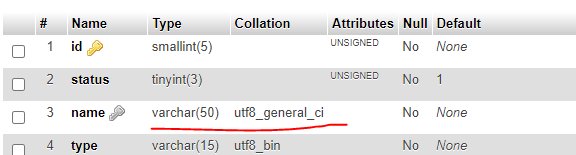
这是mysql中字段的DB排序规则,以及它的外观:
理想情况下,我希望摆脱DB中所有损坏的数据,并修复到unicode的PHP连接。但是在这一点上,最好能像PHP一样阅读已经在里面的内容。
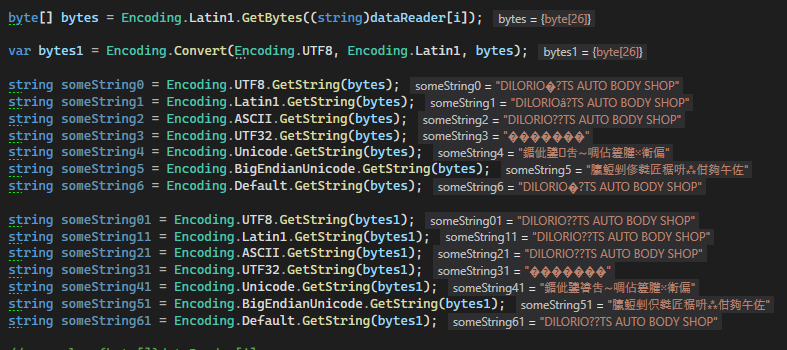
我也尝试过在所有不同的组合中进行编码转换,但在这里也没有运气:
回答 1
Stack Overflow用户
发布于 2022-01-16 16:04:15
文本是用Windows-1252编码的,而不是用Latin1编码的,这就是为什么您在上面对其进行解码的尝试失败的原因。一旦将字符串转换为Windows1252字节,然后使用UTF-8对其进行解码,则应该具有正确的值:
// note: on .NET 6.0, add 'System.Text.Encoding.CodePages' and call this line of code:
// Encoding.RegisterProvider(CodePagesEncodingProvider.Instance);

var windows1252 = Encoding.GetEncoding(1252);
var utf8Bytes = windows1252.GetBytes("DILORIO’S AUTO BODY SHOP");
var correct = Encoding.UTF8.GetString(utf8Bytes);
// correct == "DILORIO’S AUTO BODY SHOP"https://stackoverflow.com/questions/70725498
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号