
如何将包含不同位置的时间序列数据的多个Pandas数据组合到一个X数组中?
我首先从下载的.csv文件开始,该文件的列为'Series Name‘,然后是'Country Name’(每个不同系列重复国家名称行),然后是以下列中数据的年度时间步骤。我将其分割成一系列Pandas数据文件,每个数据都有一个国家名称索引,然后按时间步骤将单个系列名称(变量)的数据保存为Pickle文件。
例如:
¦ Country name ¦ 1960 ¦ 1961 ¦ 1962 ¦ ... ¦ 2021 ¦
___
¦ Albania      ¦ 1000 ¦ 1001 ¦ 1002 ¦ ... ¦ 1061 ¦

¦ Andorra      ¦ 2000 ¦ 2001 ¦ 2001 ¦ ... ¦ 2061 ¦

etc
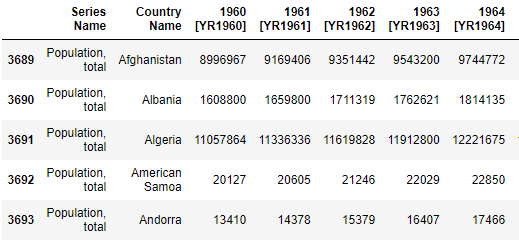
我想用“国家名称”作为一个坐标,用“年份”作为另一个(时间)坐标,然后将每个系列的数据作为不同的变量添加。
国家名称索引列和“年份”列标题在每个数据格式中是相同的,但是,与年份相比,国家名的实例数是不同的。
我被困在我认为应该是第一步,把一个单一的系列潘达数据数据在X阵列。
我已经尝试了下面的代码,这两种方法都使用了刚刚从列表中生成的'times‘坐标,以及来自dataframe中的当前行标题的坐标。但是,代码实际上希望这两个坐标都是相同的长度,因为对于单个点来说,它们不是x,y,但是counttry1,time1有一个值,country2 time2有一个值,country1,time2有一个值,等等。
year = list(range(1960,2020))

data = series1

locs = series1['Country Name']

times = year

array = xr.DataArray(data, coords=[times, locs], dims=["time", "space"])
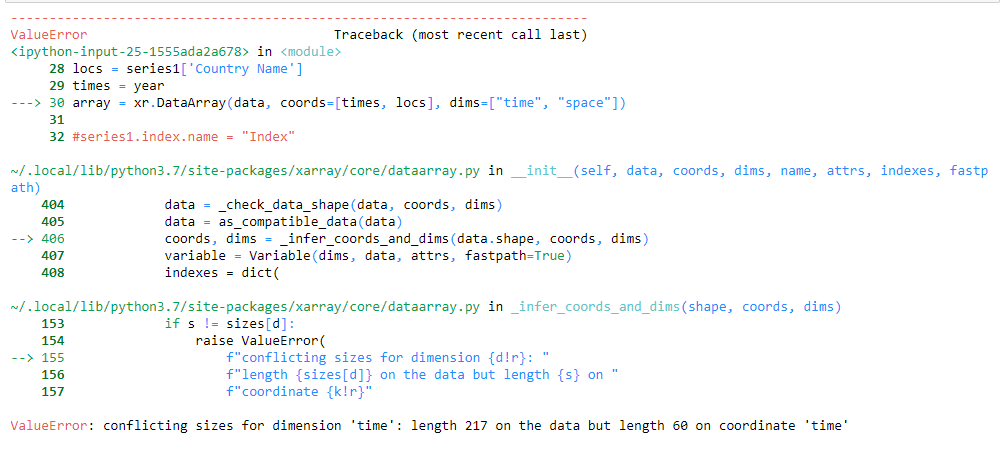
这就产生了错误:
ValueError:维数“时间”的冲突大小:数据的长度为217,坐标为“时间”的长度为60
这样做的最终目的是将这些数据与我导入的CFnet文件中的空间时间序列数据进行组合/比较,因此希望使用X数组。
回答 1
Stack Overflow用户
发布于 2022-01-02 12:43:38
我认为问题在于,在上面的示例中,data是一个一维数组,因为它来自Series对象。基于您提供的DataFrame示例,我认为如下内容将实现您想要的结果(也许可以模块化一些数据清理以将字符串年份标签转换为整数,等等):
melted = df.melt(
    id_vars=["Country Name"],
    value_vars=[f"{year} [YR{year}]" for year in range(1960, 1965)],
    var_name="year",
    value_name="population"
)
ds = melted.set_index(["Country Name", "year"]).to_xarray()df.melt将每年的各个人口列叠加为单个列,创建一个表示年份坐标的新年列,并扩展国家列以适当标记堆叠的column.melted.set_index中的每个人口值,然后在"Country Name"和"year"列之外创建一个MultiIndex。这使得熊猫和xarray能够识别出,当调用DataFrame时,这个to_xarray实际上是一个带有2D数据变量的数据集。
https://stackoverflow.com/questions/70547527
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号