MedCortex:把分析流程拆成看得见的模组,做过的分析下次接着用
原创
MedCortex:把分析流程拆成看得见的模组,做过的分析下次接着用
原创
用户12646921
发布于 2026-11-09 17:34:16
发布于 2026-11-09 17:34:16
MedCortex:把分析流程拆成看得见的模组,做过的分析下次接着用
写 SCI 真正卡住的地方,往往不在跑代码,而在跑之前:这一步到底在做什么、凭什么这么做、下次换个课题还能不能接着用。
分析链如果只剩一串命令,哪一步依赖哪一步就很难看出来;等结果不对要回头找原因,只能从头再理一遍。
MedCortex 换了一种组织方式:把分析拆成「模组」,把模组装成画布上的一条链,再挂上依据、生成工作流。下面这段演示里整条路是真跑通的,我们跟着画面走一遍。
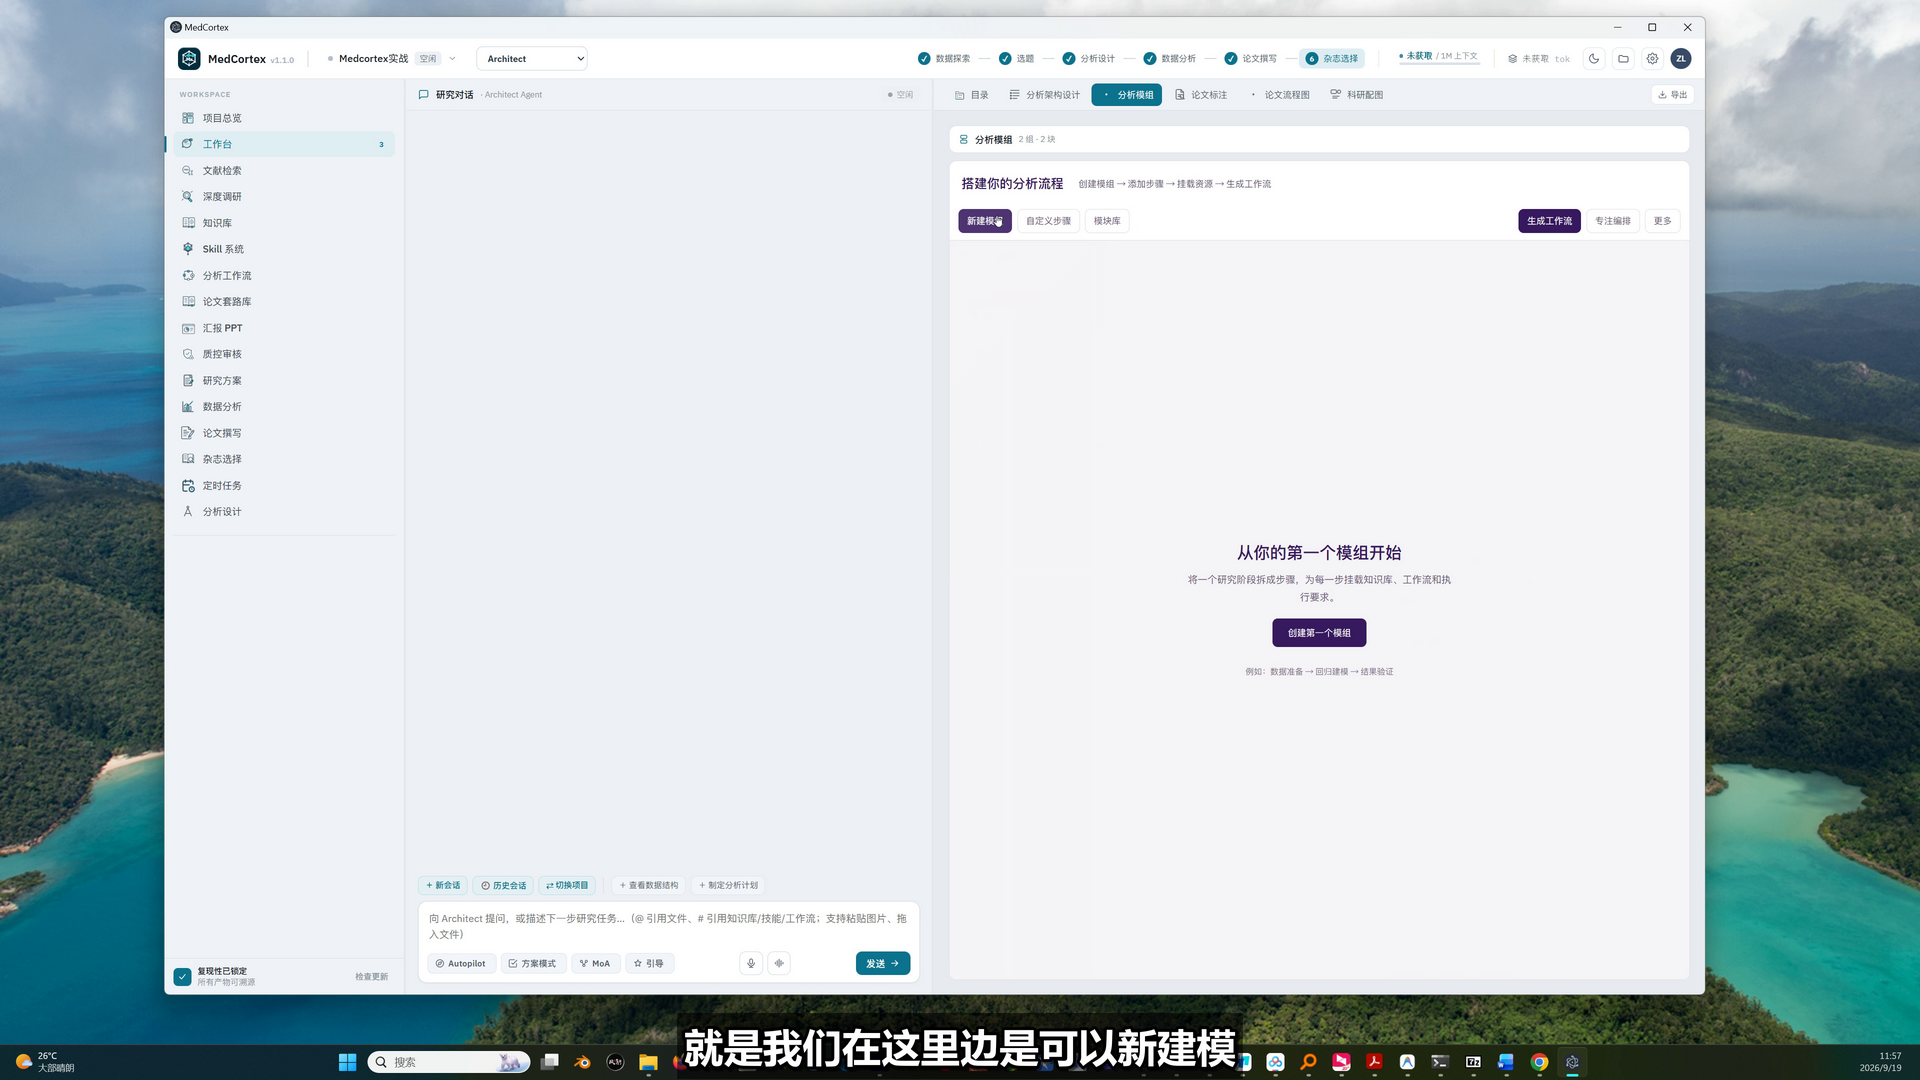
▲ 分析模组页:副标题写着创建模组 → 添加步骤 → 挂载资源 → 生成工作流
先看页面本身。标题是「搭建你的分析流程」,旁边紧跟着一行副标题:创建模组 → 添加步骤 → 挂载资源 → 生成工作流。下面三个标签——新建模组、自定义步骤、模块库;右上角是「生成工作流」「专注编排」「更多」。
注意这一页的性质:分析流程在这里是一件可以存下来、可以再打开接着改的东西,不是聊天框里的一次性输出。面板标题还标着「分析模组 2 组 · 2 块」,空态区那行提示写的是「将一个研究阶段拆成步骤,为每一步挂载知识库、工作流和执行要求」,示例直接给了三步:数据准备 → 回归建模 → 结果验证。
一、流程画布上,节点连成一条看得见的链
先看画布。
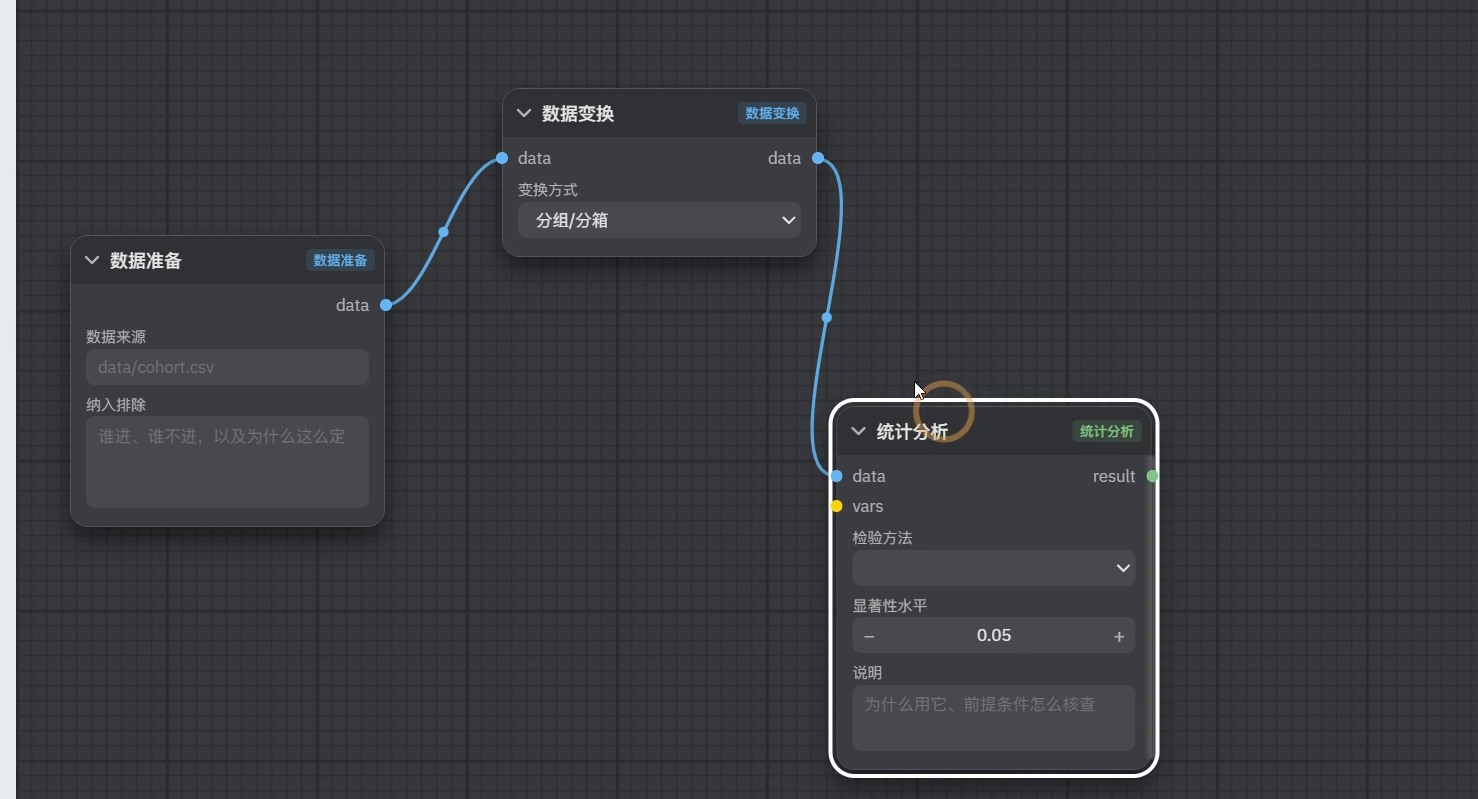
▲ 三个节点连成一条线:从数据准备到数据变换,再到统计分析
这条线上每一格都写着字。「数据准备」节点里是数据来源 data/cohort.csv,还有一栏专门留给纳入排除;「数据变换」节点里选的是分组/分箱;「统计分析」节点里留着检验方法的下拉框、显著性水平 0.05,以及一句"为什么用它、前提条件怎么核查"的说明位。
💡 一句话记住:连线就是依赖关系,节点里写的就是方法学。
对写文章来说这很实在——方法学那节不用再凭印象回忆,画布上节点写的是什么,那节就写什么。
二、一个模组里装着什么
接下来看「模组」本身。
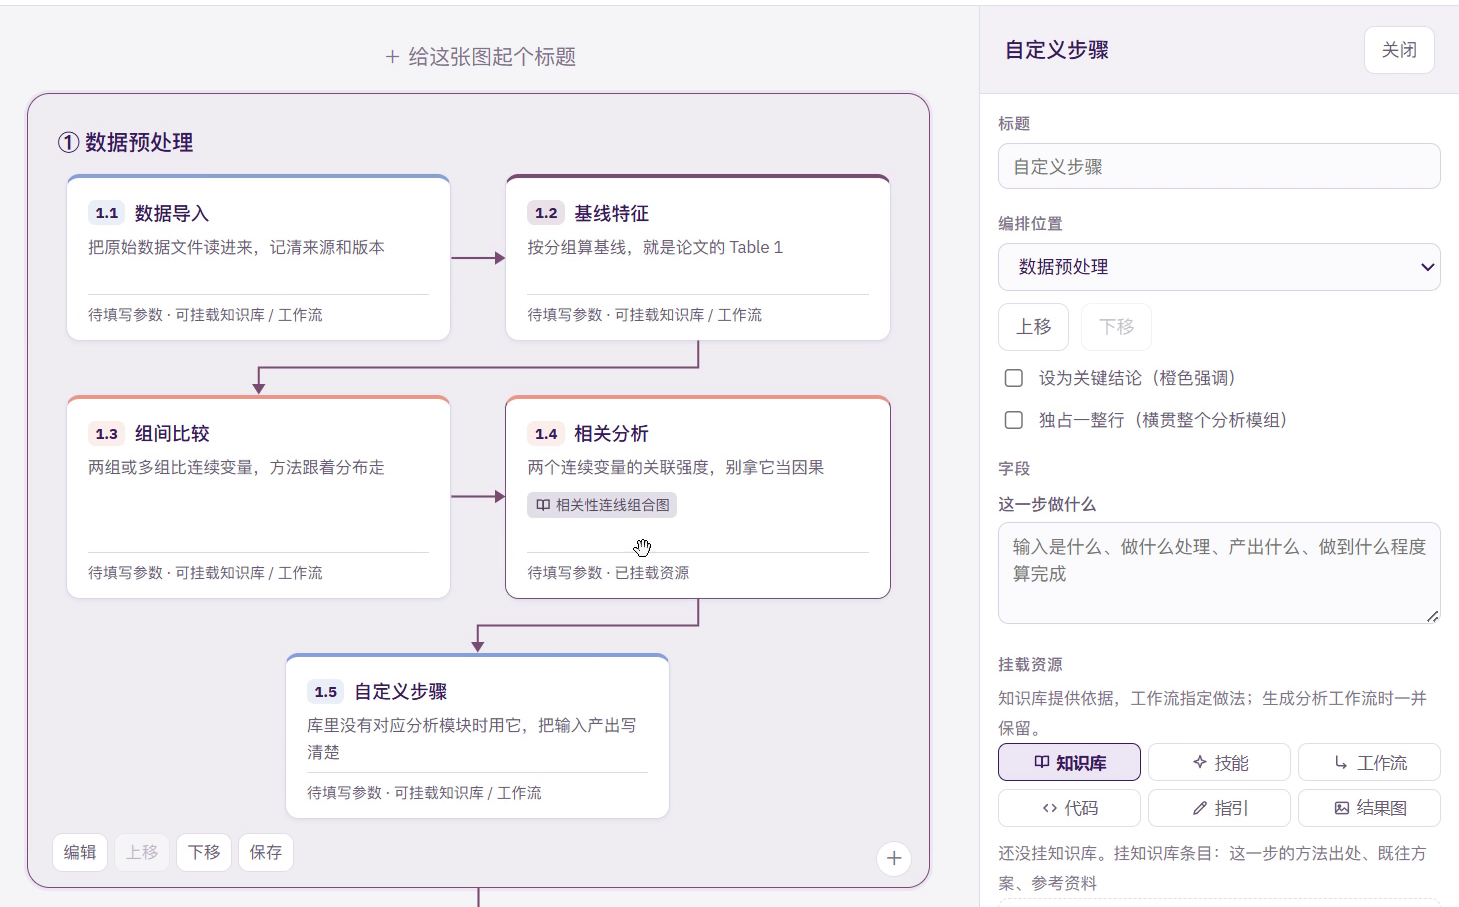
▲ 左边是「①数据预处理」的五张步骤卡,右边是选中步骤后的编辑面板
左边这个「①数据预处理」模组里有五张卡:1.1 数据导入、1.2 基线特征、1.3 组间比较、1.4 相关分析、1.5 自定义步骤,卡与卡之间用连线标着先后。卡片上写的不是代码,是人话:「把原始数据文件读进来,记清来源和版本」「按分组算基线,就是论文的 Table 1」「两组或多组比连续变量,方法跟着分布走」「两个连续变量的关联强度,别拿它当因果」。
右边是选中某一步之后的编辑面板:编排位置(放在哪个模组的第几步)、设为关键结论、独占一整行,还有一个「这一步做什么」的说明框,占位文字是"输入是什么、做什么处理、输出什么、做到什么程度算完成"。
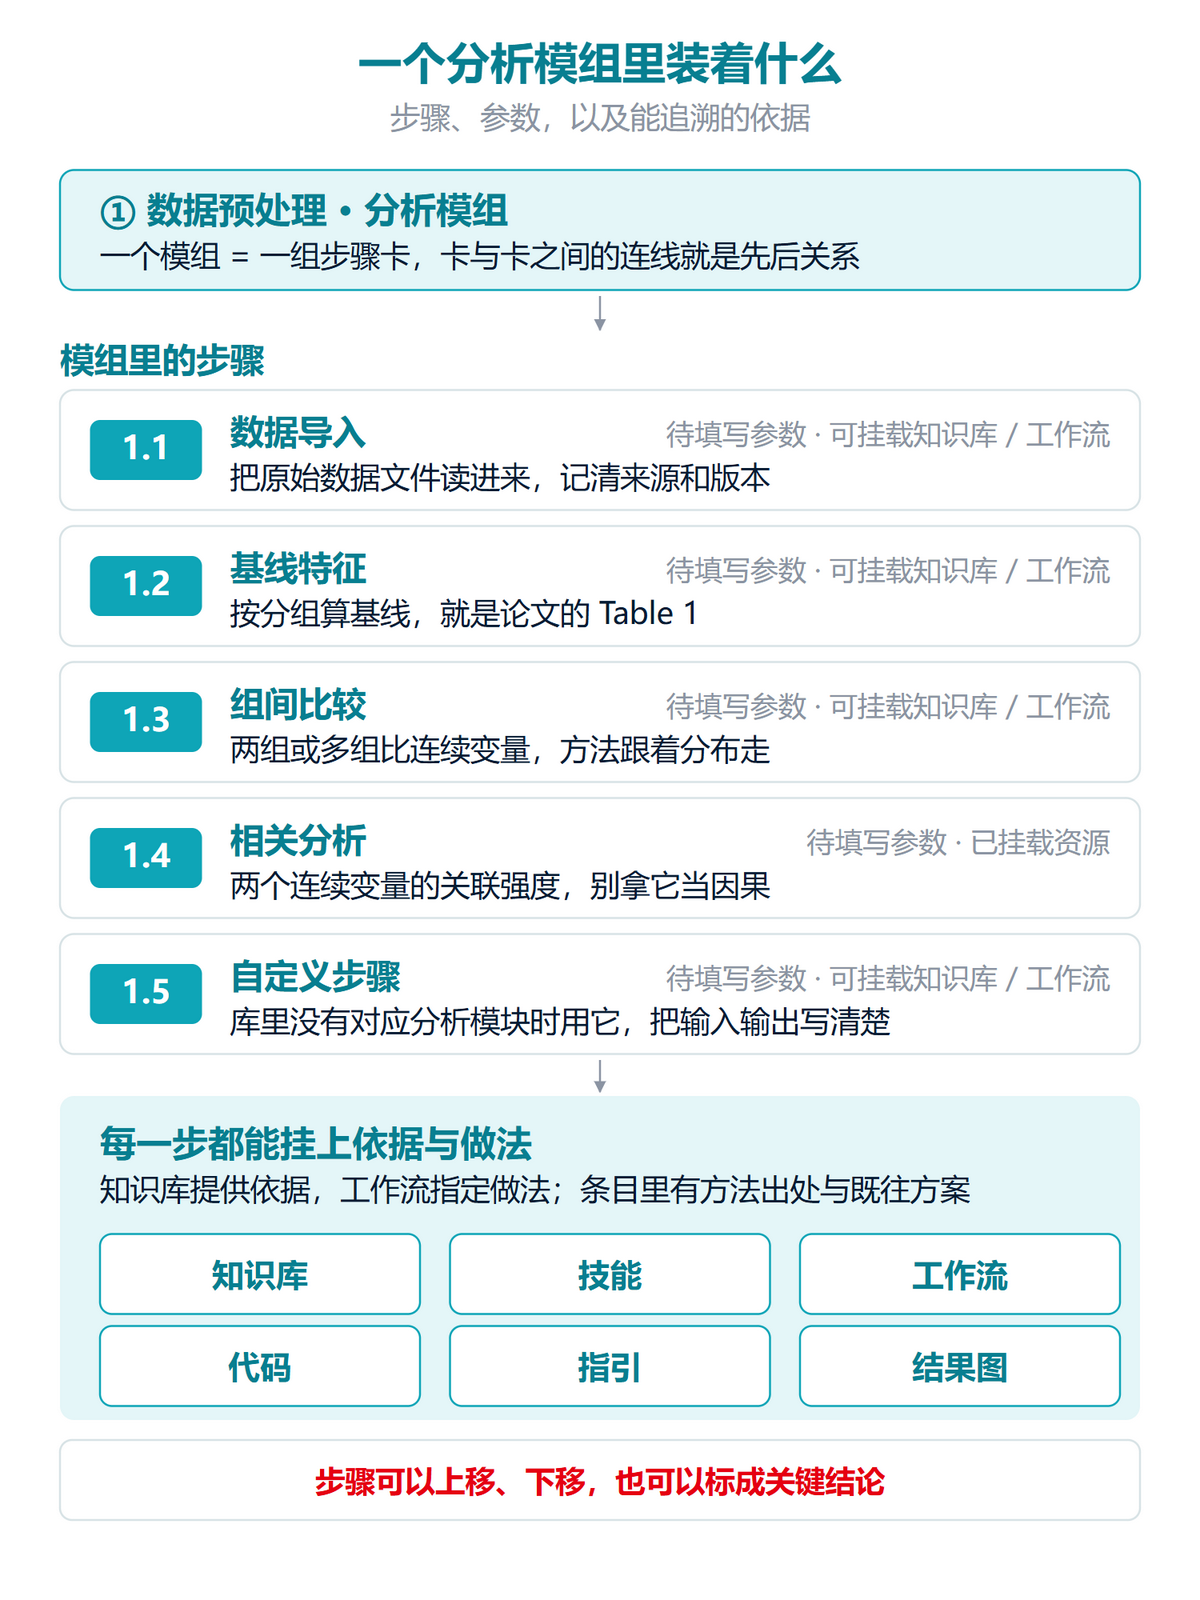
▲ 模组 → 步骤卡 → 每一步可挂载的依据与做法
底下这一层,才是这套流程能被复用的原因。卡片底部都标着状态:多数步骤是「待填写参数 · 可挂载知识库 / 工作流」,1.4 相关分析那一步挂上了「相关性连线组合图」,状态变成「待填写参数 · 已挂载资源」。
三、每一步都能挂上依据
「可挂载知识库」点开是什么?
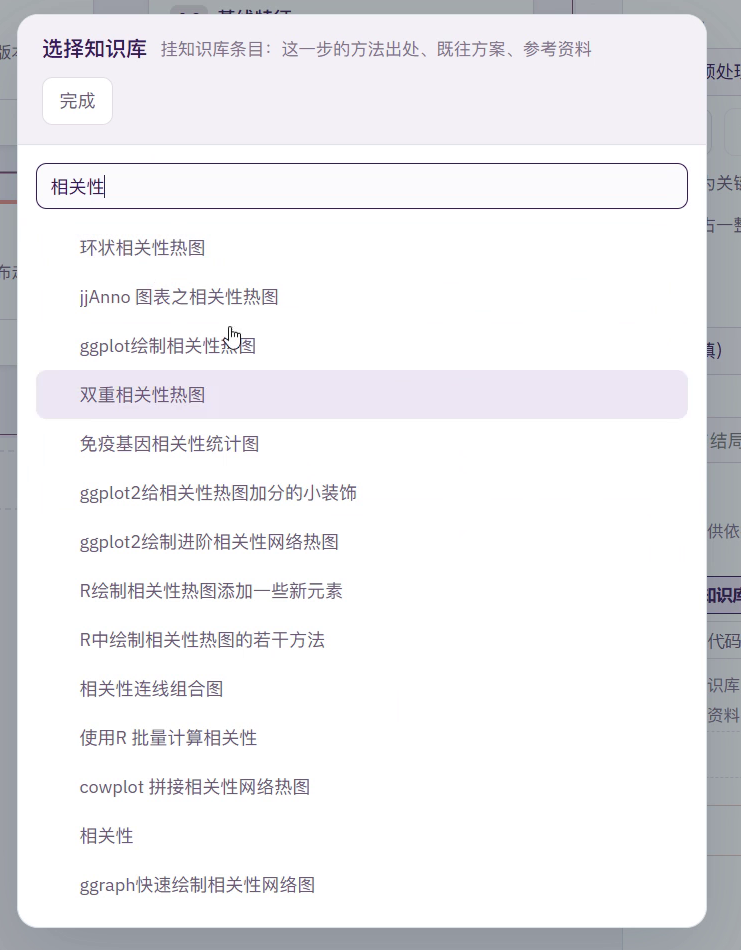
▲ 选择知识库:条目即这一步的方法出处、既往方案与参考资料
弹窗上写得很清楚:挂载知识库条目,这一步的方法出处、既往方案、参考资料。搜索框里敲进「相关性」,列出来的是环状相关性热图、jjAnno 图表之相关性热图、ggplot 绘制相关性热图、双重相关性热图、相关性连线组合图等等,都是能直接取用的条目。
面板底部还交代了分工:知识库提供依据,工作流指定做法,生成分析工作流时一并保留。
💡 一句话记住:这一步为什么这么做、参考了谁的方案,可以直接挂在步骤上,不靠口头交接。
四、做过的工作流和模组,可以直接调出来
换一个课题重来一整套分析,烦的是重复劳动。MedCortex 这边备了两份现成的清单。
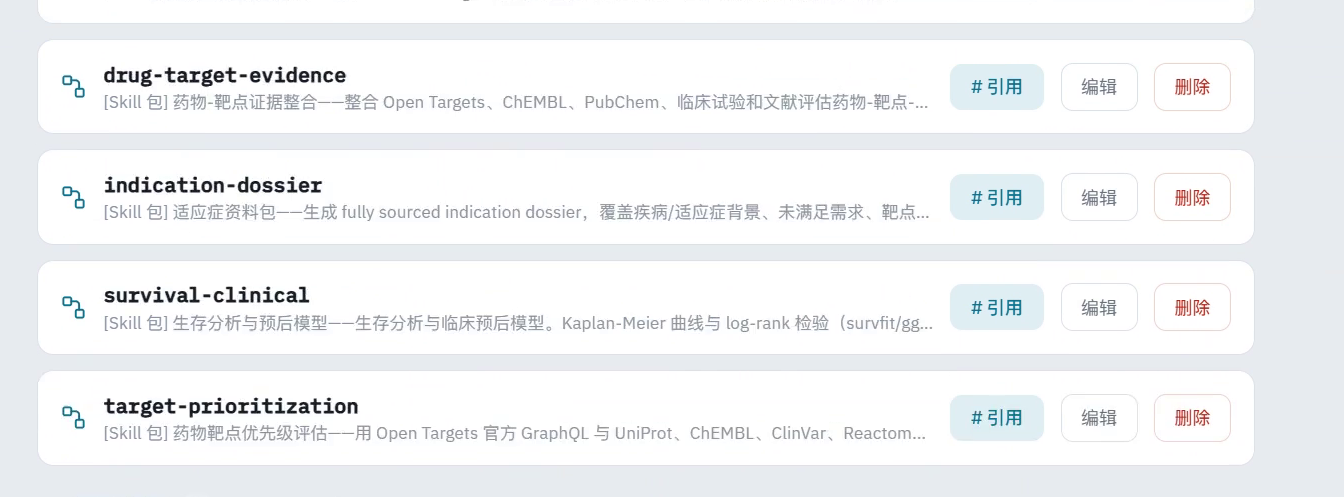
▲ 分析工作流清单:每条都带用途说明和「引用 / 编辑 / 删除」
这是「分析工作流」页面。drug-target-evidence 是药物-靶点证据整合,indication-dossier 是适应症资料包,survival-clinical 是生存分析与预后模型(KM 曲线与 log-rank 检验),target-prioritization 是药物靶点优先级评估。每条后面跟着引用、编辑、删除三个按钮。
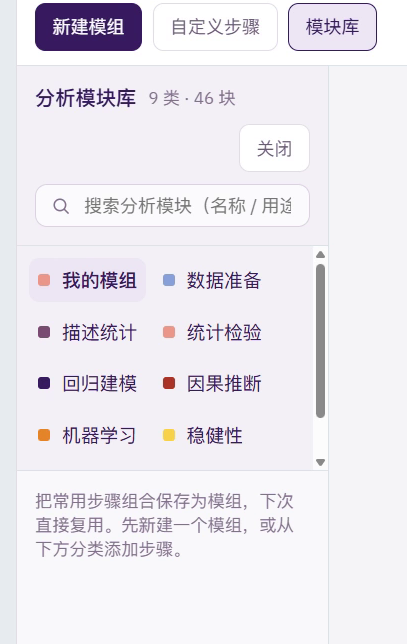
▲ 分析模组库:9 类 · 46 块,按用途分好类
另一份是「分析模组库」,写着 9 类 · 46 块,按用途分了类:我的模组、数据准备、描述统计、统计检验、回归建模、因果推断、机器学习、稳健性。面板下面那句话说得直白:把常用步骤组合保存为模组,下次直接复用。
五、模组里的步骤,是真实的分析方法
上面说的模组,装的不是空壳。
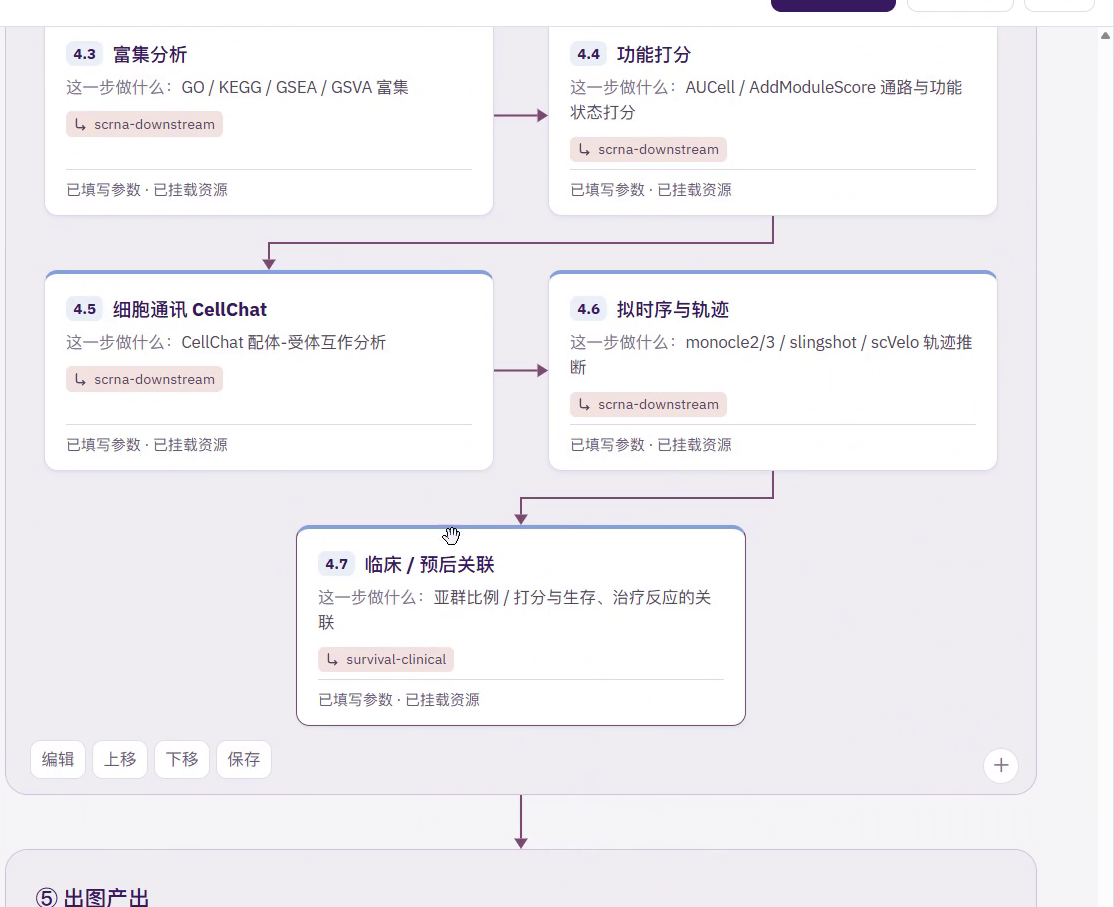
▲ 单细胞分析模块:每张卡写明这一步做什么,并挂着对应的工作流
这是演示里的一个单细胞分析模块。4.3 富集分析写明做 GO / KEGG / GSEA / GSVA 富集;4.4 功能打分是 AUCell / AddModuleScore 通路与功能状态打分;4.5 细胞通讯 CellChat 做配体-受体互作分析;4.6 拟时序与轨迹走 monocle2/3、slingshot、scVelo;4.7 临床 / 预后关联把亚群比例、打分和生存、治疗反应连起来。
每张卡上都挂着一个工作流标签:4.3 到 4.6 挂 scRNA-downstream,4.7 挂 survival-clinical。卡片底部统一标着「已填写参数 · 已挂载资源」,再往下还有一个「⑤ 出图产出」分组。
💡 一句话记住:步骤卡上那句「这一步做什么」,就是能直接抄进论文方法学的话。
六、这套流程是从哪儿长出来的
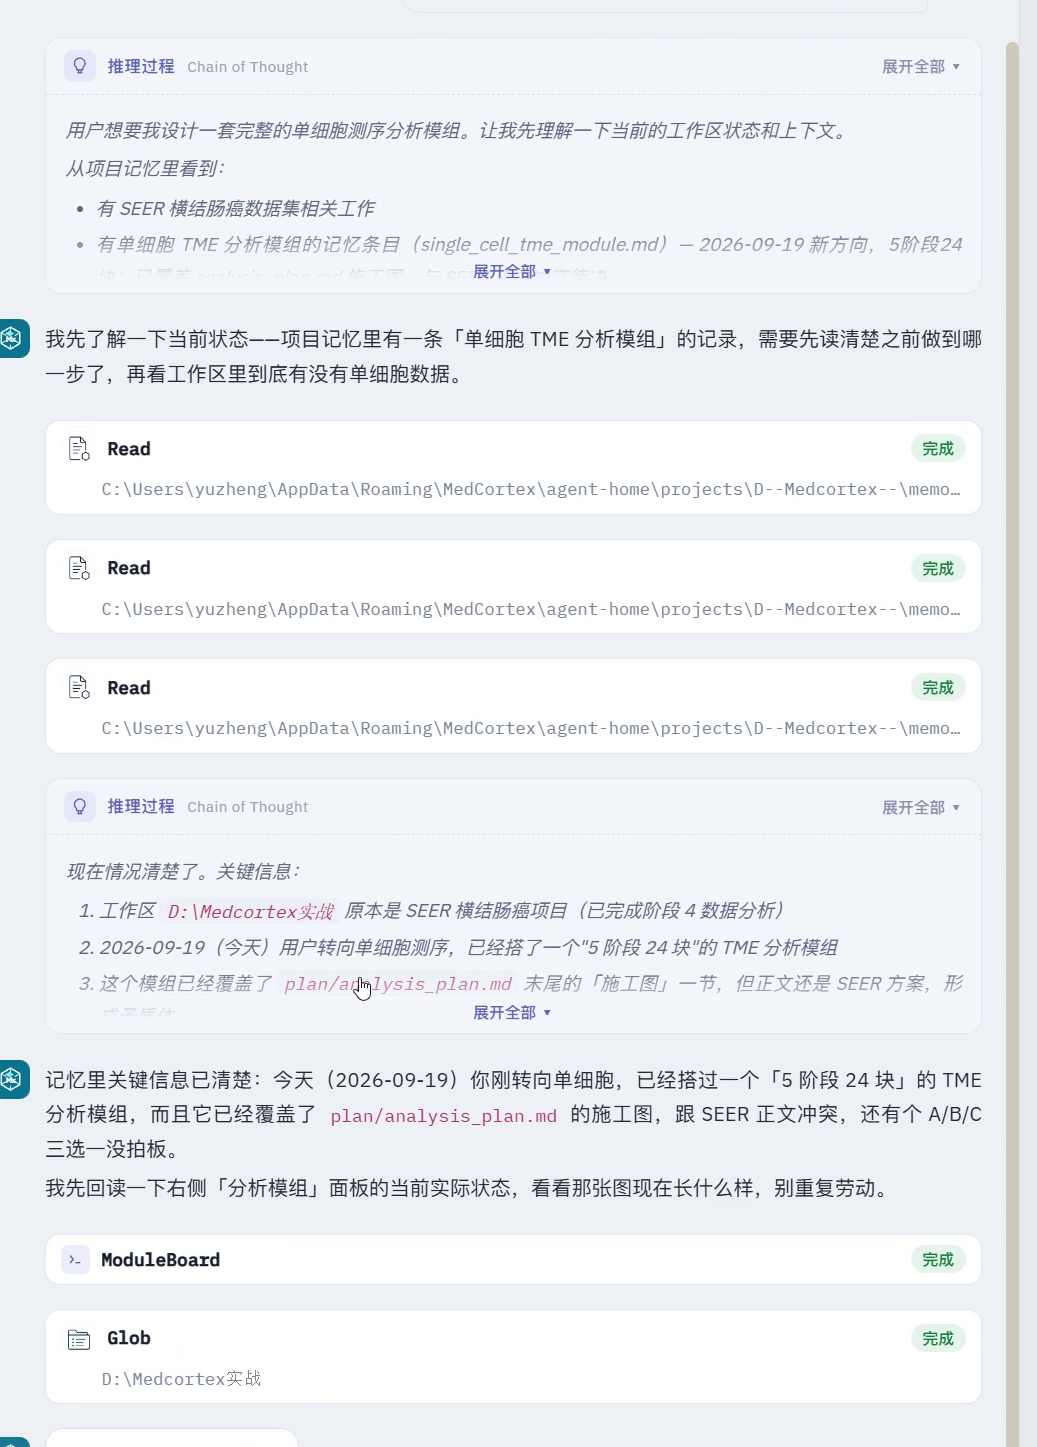
▲ 对话区:任务被拆成一条条工具调用,每步都有完成标记
有意思的是左边这块。研究对话区里,任务不是一句提示词丢出去就不管了,而是被拆成一条条工具调用:Read 读文件、Glob 找目录、ModuleBoard 读模块面板,每张卡片后面都标着「完成」。它的推理过程里先交代了现状——项目记忆里有一条单细胞 TME 分析模组的记录,得先读清楚之前做到哪一步了,再看工作区里到底有没有单细胞数据。
先读记忆,再决定下一步,这个顺序决定了它接得上前一个课题的活。
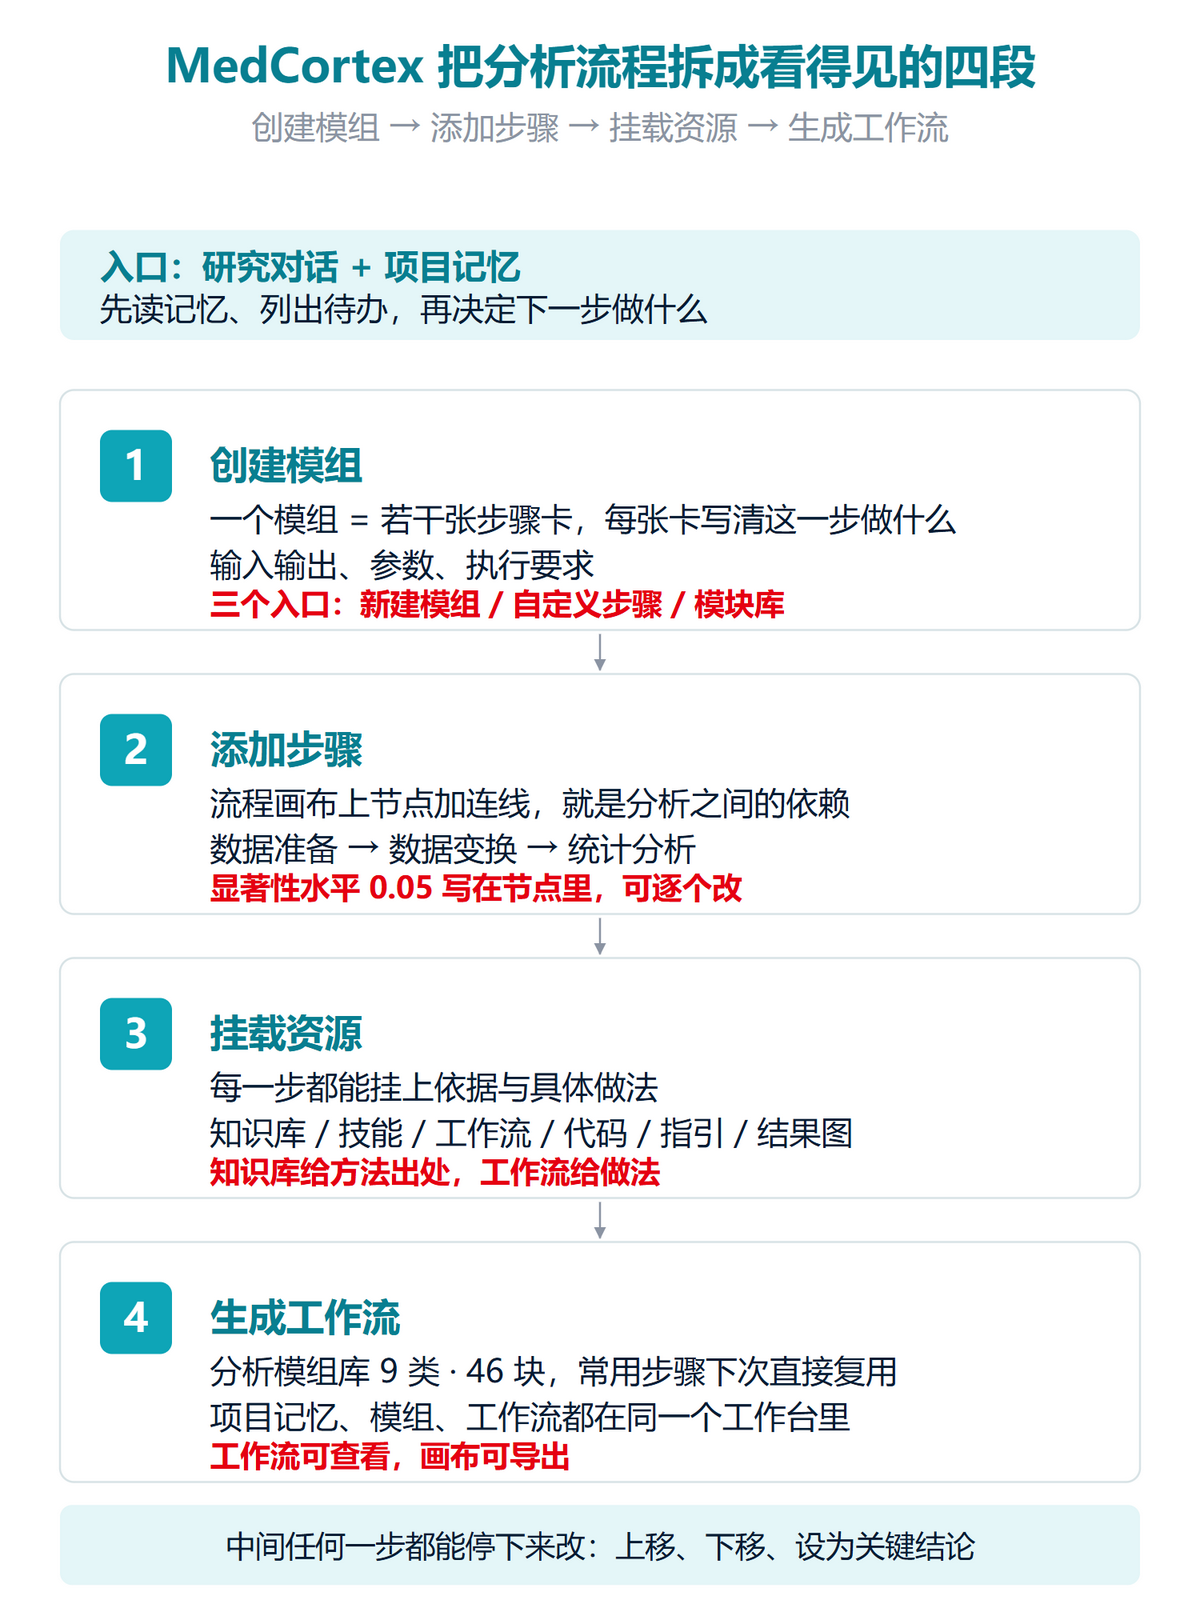
▲ 四段链路:创建模组 → 添加步骤 → 挂载资源 → 生成工作流
把整条链路合起来看:创建模组、添加步骤、挂载资源、生成工作流。中间任何一步都能停下来改——步骤可以上移、下移,也能标成关键结论。
结尾
回到开头那个问题:分析跑通了却说不清跑了什么,换个课题还得重来一遍。
MedCortex 的答案是把分析拆开、摆出来、存下来。拆成模组,每步写清做什么;连成画布,依赖关系一眼可见;挂上知识库和技能,方法出处留在步骤里;存进模组库和项目记忆,换个课题接着用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号