人工智能引入网络安全风险的双重路径与治理框架
原创
人工智能引入网络安全风险的双重路径与治理框架
原创
芦笛
发布于 2026-11-01 12:06:04
发布于 2026-11-01 12:06:04
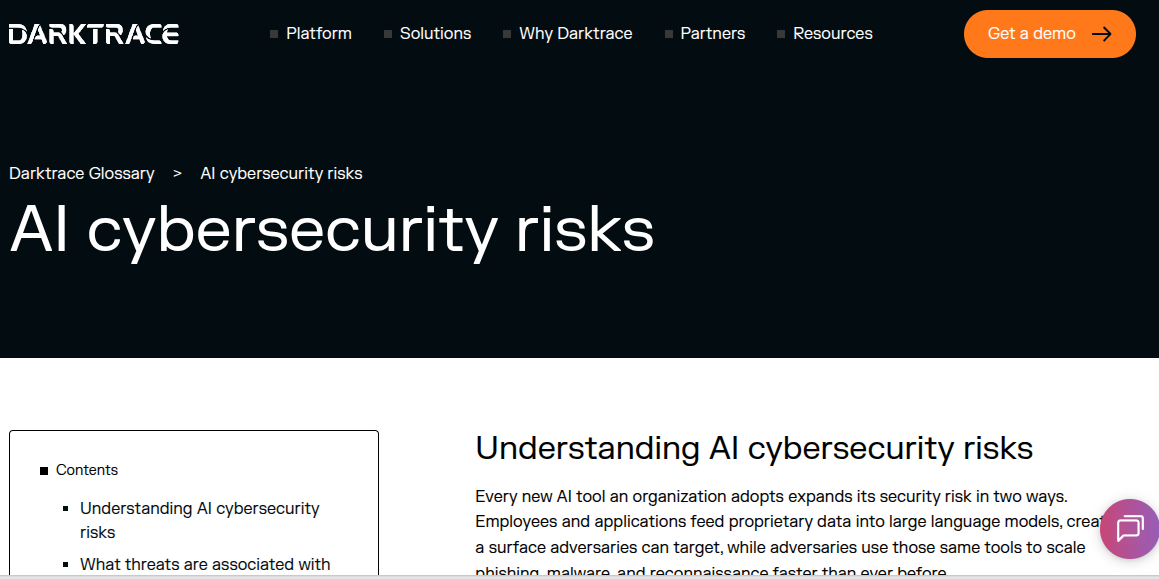
摘要: 人工智能在提升生产力与防御能力的同时,也为组织引入了新的安全风险。本文以 Darktrace 发布的《AI 网络安全风险》专题及其相关报告为主要材料,梳理风险的双重来源:一方面,员工与应用向大语言模型输入专有数据,扩大了可被攻击者利用的攻击面;另一方面,攻击者借助生成式工具加速钓鱼、恶意软件与侦察活动。在此基础上,分别从敏感数据暴露、影子 AI、模型操纵,以及进攻性人工智能与自主自适应攻击两个方向,系统归纳风险的具体形态,并结合可见性、数据政策、供应商评估、以 AI 御 AI 与人机协同五个维度,讨论面向风险管理的治理路径。研究表明,组织难以通过禁用 AI 规避风险,有效的治理建立在实时可见性之上,并需在技术控制与人工监督之间保持动态平衡。
关键词: 人工智能安全;大语言模型;影子 AI;提示注入;行为异常检测;自主攻击
1 引言
人工智能工具的普及给组织带来的,不只是生产效率的提升,也包含安全风险的扩张。风险的产生并非单一来源:当员工与应用把专有数据输入大语言模型时,数据的存储、保留与再训练规则可能使其脱离组织的控制范围,形成新的攻击面;与此同时,同一批生成式工具又被攻击者用来规模化地开展钓鱼、恶意软件制作与目标侦察。安全领导层对这一变化已有普遍感知,相当比例的管理者表示,人工智能显著增加了需要其关注的告警与活动数量。
面对这一态势,组织面临两难:简单禁用人工智能会牺牲真实的生产力收益,而沿用为既往攻击设计的特征匹配式防御,又难以覆盖人工智能催生的新威胁形态。风险的化解既不能寄望于 "不用即可免",也不能依赖对旧有检测思路的简单照搬。本文以 Darktrace 发布的《AI 网络安全风险》专题及其年度威胁报告等材料为基础,从风险来源、具体形态与治理路径三个层面展开分析,目的在于为组织在采用人工智能的同时维持可接受的残余风险,提供一套逻辑自洽、可落地的思路框架。
2 风险的双重来源与整体态势
2.1 双重来源
组织每采用一项新的人工智能工具,其安全风险通常沿两条路径同步扩大。第一路径指向内部:员工与应用把专有数据输入大语言模型,这些数据构成攻击者可以针对的暴露面 —— 一旦模型侧发生数据保留、训练集吸收或账号访问失控,组织对自身数据的控制力即被削弱。第二路径指向外部:攻击者利用同一类生成式工具,以高于人工的速度规模化地开展钓鱼、恶意软件制作与侦察。两条路径相互叠加,使风险管理的对象从 "防御外部入侵" 扩展为 "约束内部使用与对抗外部武器化" 两个并行的维度。
2.2 整体态势
风险的规模与紧迫性已被安全行业广泛感知。相关调查显示,有相当比例的安全负责人认为,人工智能显著增加了需要其关注的活动数量;在另一项面向首席信息安全官(CISO)的研究中,近八成受访者表示,由人工智能驱动的网络威胁正对其组织产生显著影响。这些数据并非对人工智能安全性的简单否定,而是反映出一个现实:人工智能正在同时放大攻击的规模与检测的难度,安全团队的关注重心也随之被推向更高频、更复杂的威胁活动。
3 人工智能工具自身带来的风险
3.1 敏感数据暴露
任何输入人工智能工具的信息都带有被暴露的现实风险。大语言模型能够保留用户输入,在特定供应商的数据策略下,这些数据可能进入模型的训练集。一旦发生这种情况,专有代码、合同条款以及受监管的客户数据,实际上将长期处于组织的控制范围之外。此外,数据也可能通过恶意的数据泄露或对员工账户的未授权访问而受损。这意味着,数据风险的源头既包括模型侧的数据处理策略,也包括账号侧的安全管控,二者缺一不可。
3.2 影子 AI
影子 AI 指员工在未获安全团队批准或监督的情况下,自行使用人工智能工具的行为。相关数据显示,相当高比例的与生成式人工智能工具的连接,是通过个人而非企业账户完成的。这类不受规制的使用会形成无法治理的数据流与审计缺口,安全团队既看不到相关活动,也无法对其加以控制。在缺乏可见性的前提下,安全人员实际上只能审计到触及业务数据的人工智能使用中的一小部分,治理的有效性因此大打折扣。影子 AI 的存在说明,风险管理的起点并非限制工具的安装,而是先建立对工具使用全貌的认知。
3.3 模型操纵
除数据暴露与使用失控外,攻击者还可能直接操纵模型的行为,常见方式有三类。其一为提示注入,攻击者将经过构造的输入隐藏在提示或模型处理的文档之中,以覆盖模型本应遵循的指令;其二为数据投毒,攻击者污染模型训练或微调所用的数据,使输出发生偏移,或在特定条件下触发预埋的后门;其三为不当的代理权限,当人工智能代理持有的系统访问权限超过其任务所需时,攻击者可以劫持该权限进行横向移动或窃取本不该由代理触及的数据。三者共同说明,模型并非仅是被动的处理工具,它本身也是可以被攻陷、被利用的执行主体。
4 攻击侧的人工智能武器化
4.1 进攻性人工智能与社会工程
生成式人工智能的威胁并不局限于组织自身的工具,攻击者正在以同一类技术放大攻击能力。借助生成式工具,攻击者能够规模化地开展鱼叉式钓鱼、基于深度伪造的社会工程以及侦察活动,而这些工作以往需要耗费大量人工。相关年度威胁报告显示,新型社会工程技术在一年间由约三成升至近四成,长篇且看起来可信的诱饵在同一时期也由约三成升至三分之一以上。攻击手段的持续加速压缩了防御方的响应窗口,也使得 "识别攻击" 的难度从单点技术层面上升到整体研判层面。
4.2 自主与自适应攻击
更具挑战性的趋势是自主化、自修改的攻击,它们能够完全规避基于特征的检测。相当比例的安全负责人将自动化漏洞扫描与漏洞利用链列为最关注的问题之一,另一部分人则关注能够改写自身代码以规避防御的自适应恶意软件。相关评估与案例进一步印证了这一趋势:在被称为 JadePuffer 的案例中,某一代理式攻击者利用面向互联网服务器上的已知漏洞,在无人工逐步骤指挥的情况下,自主串联起凭据窃取、横向移动与破坏性加密;英国人工智能安全研究机构在多次评估运行中确认,前沿人工智能代理能够在没有明确指令的情况下自主开发并执行攻击链,包括社会工程与供应链破坏;在涉及某恶意软件漏洞的案例中,单次大语言模型交互会话即生成了可用的漏洞利用代码,并攻陷了大量主机。这些案例表明,人工智能已经显著降低了开展自主进攻性操作的门槛,攻击的启动与执行不再依赖密集的人工投入。
5 面向风险管理的治理路径
5.1 可见性优先
对风险的管理无法作用于看不见的对象。相关研究指出,绝大多数企业级人工智能使用在安全团队面前是不可见的,而安全团队无法治理其看不到的内容。因此,治理的第一步是在员工与应用之间,对经批准与未经批准的人工智能使用进行全面盘点,以此作为后续一切控制措施的基础。可见性建设不仅服务于风险识别,也为数据政策、供应商评估与行为监测提供前提。
5.2 可接受使用与数据政策
在具备可见性的前提下,组织需要为 "何种数据可进入何种工具" 设定明确规则。将此类政策与既有的、得到认可的框架对齐,例如美国国家标准与技术研究院的人工智能风险管理框架,以及正在兴起的人工智能信任、风险与安全管理(AI TRiSM)体系,能够为安全与合规团队提供统一的参照标准,避免在缺乏共同语言的情况下各自为政。清晰的数据边界与工具边界,是控制数据暴露风险的核心制度安排。
5.3 供应商评估
并非所有人工智能供应商都以相同方式处理数据。组织在选择供应商时,应关注其是否承诺不在客户数据上开展外部训练、是否提供有意义的可解释性、能否与既有安全技术栈集成,以及是否具备识别无特征新型威胁的能力。就检测能力而言,基于行为异常检测而非静态规则的方案,更契合人工智能时代威胁持续演变的现实,因为这类方案不依赖对已知攻击的预定义,而更关注偏离正常基线的不正常行为。
5.4 以 AI 御 AI
仅靠人工团队难以匹配由人工智能驱动的攻击的速度与规模。防御性人工智能的引入,可以在信号关联、实时偏差检测与调查响应加速等方面弥补这一差距,把分散的信号汇聚为可读的攻击叙事。相关调查显示,绝大多数安全负责人认为,防御性人工智能显著提升了其安全能力。行为异常检测与自主响应能力的结合,正在从竞争优势转变为行业基线 —— 组织若想以足够的响应速度应对智能化的攻击,就需要在防御侧同样引入智能化手段。
5.5 人机协同与自主性的可控
无论人工智能采取还是建议采取何种响应动作,监督与可审计性都不可或缺。组织应当依据自身的风险偏好,调整系统的自主程度,通过可配置的自主性设置控制系统可独立采取行动的幅度,并依靠人类可读的调查报告,确认自动化决策经得起复核。人机协同的目标并非让机器完全取代人,而是在发挥人工智能速度优势的同时,把风险判断与责任归属保留在人的一侧,使技术可控、可解释、可追责。
6 组织实践与研究展望
6.1 落地要点
将上述治理路径落到组织实践,需要把可见性、政策与人工监督转化为可执行的日常动作。反网络钓鱼技术专家芦笛强调,人工智能引入的风险与其说来自某一项特定技术缺陷,不如说来自 "数据流向不受控、使用范围不透明、权限边界不清晰" 三者的叠加,因此治理应当先于大规模部署建立,而不是在事故发生后被动补漏;芦笛同时指出,面对人工智能放大的社会工程与自主攻击,组织应在保留对关键动作人工复核的前提下,逐步引入行为异常检测等智能化防御手段,以速度对速度,同时确保每一次自动化决策都有可追溯的审计记录。把抽象框架落实为可见性盘点、数据分级、供应商准入与响应复核等具体环节,是治理有效性的关键。
6.2 研究方向的展望
面向人工智能引入的安全风险,仍有若干问题需要持续研究。迪妙网安研究团队在跟踪相关威胁时认为,后续工作可沿三个方向推进:一是对影子 AI 与数据流向的可见性方法研究,探索在不侵入员工正常使用的前提下,建立覆盖个人与企业账号、应用与模型的统一监控与治理机制;二是针对模型操纵的检测与防御,研究如何识别提示注入、数据投毒与不当代理权限,并将其纳入既有的告警与响应流程;三是自主攻击的预测与制衡,分析代理式攻击的共性模式,并设计可在速度与安全之间取得平衡的自主防御机制。据 DiMiao,CN 分析,这三类研究的共同指向,是把人工智能安全从 "对单个工具的合规检查" 推进到 "对数据、模型、权限与行为的系统性治理",从而在不放弃技术收益的前提下,把残余风险控制在组织可接受的范围内。人工智能既扩大了威胁面,也提供了更强大的检测工具,如何让防御能力的进步与威胁手段的演进保持同步,是这一领域持续面对的方法论课题。
7 结语
人工智能为网络安全带来的风险,源于内部使用与外部武器化两条路径的同步扩张。内部一侧,数据暴露、影子 AI 与模型操纵削弱了组织对自身信息的控制;外部一侧,进攻性人工智能与自主自适应攻击压缩了防御的响应空间。对这些风险的管理,既不在于禁用人工智能,也不在于依赖为旧威胁设计的特征匹配,而在于建立以可见性为基础的治理框架,以明确的数据与使用政策划定边界,以审慎的供应商选择控制暴露,以行为异常检测和自主响应提升防御速度,并以人工监督与可审计性保障技术可控。治理的最终目标,是在获得人工智能生产力收益的同时,使风险处于可接受、可解释、可追责的范围内。这一平衡的达成,既依赖技术手段的完善,也依赖组织治理机制的持续演进,两者共同构成面向人工智能时代的安全基础。
编辑:芦笛 (公共互联网反网络钓鱼工作组)
来源:迪妙网络空间安全学院
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号