给Agent装了个“专属文件柜”:Agent Bucket 上手实录
原创
给Agent装了个“专属文件柜”:Agent Bucket 上手实录
原创
猫七条
发布于 2026-10-31 13:05:07
发布于 2026-10-31 13:05:07
之前做Agent项目,我最头疼的不是模型调用,是“文件存哪”。
最早图省事,让Agent把上传资料、中间产物、生成报告都写服务器本地目录,按会话ID建文件夹。结果上线没几天就出问题:单机磁盘告警、多实例部署后文件散落在不同机器、权限基本靠约定。知识库Agent想找上一个会话的产物,经常找不到,或者直接读到别人的。
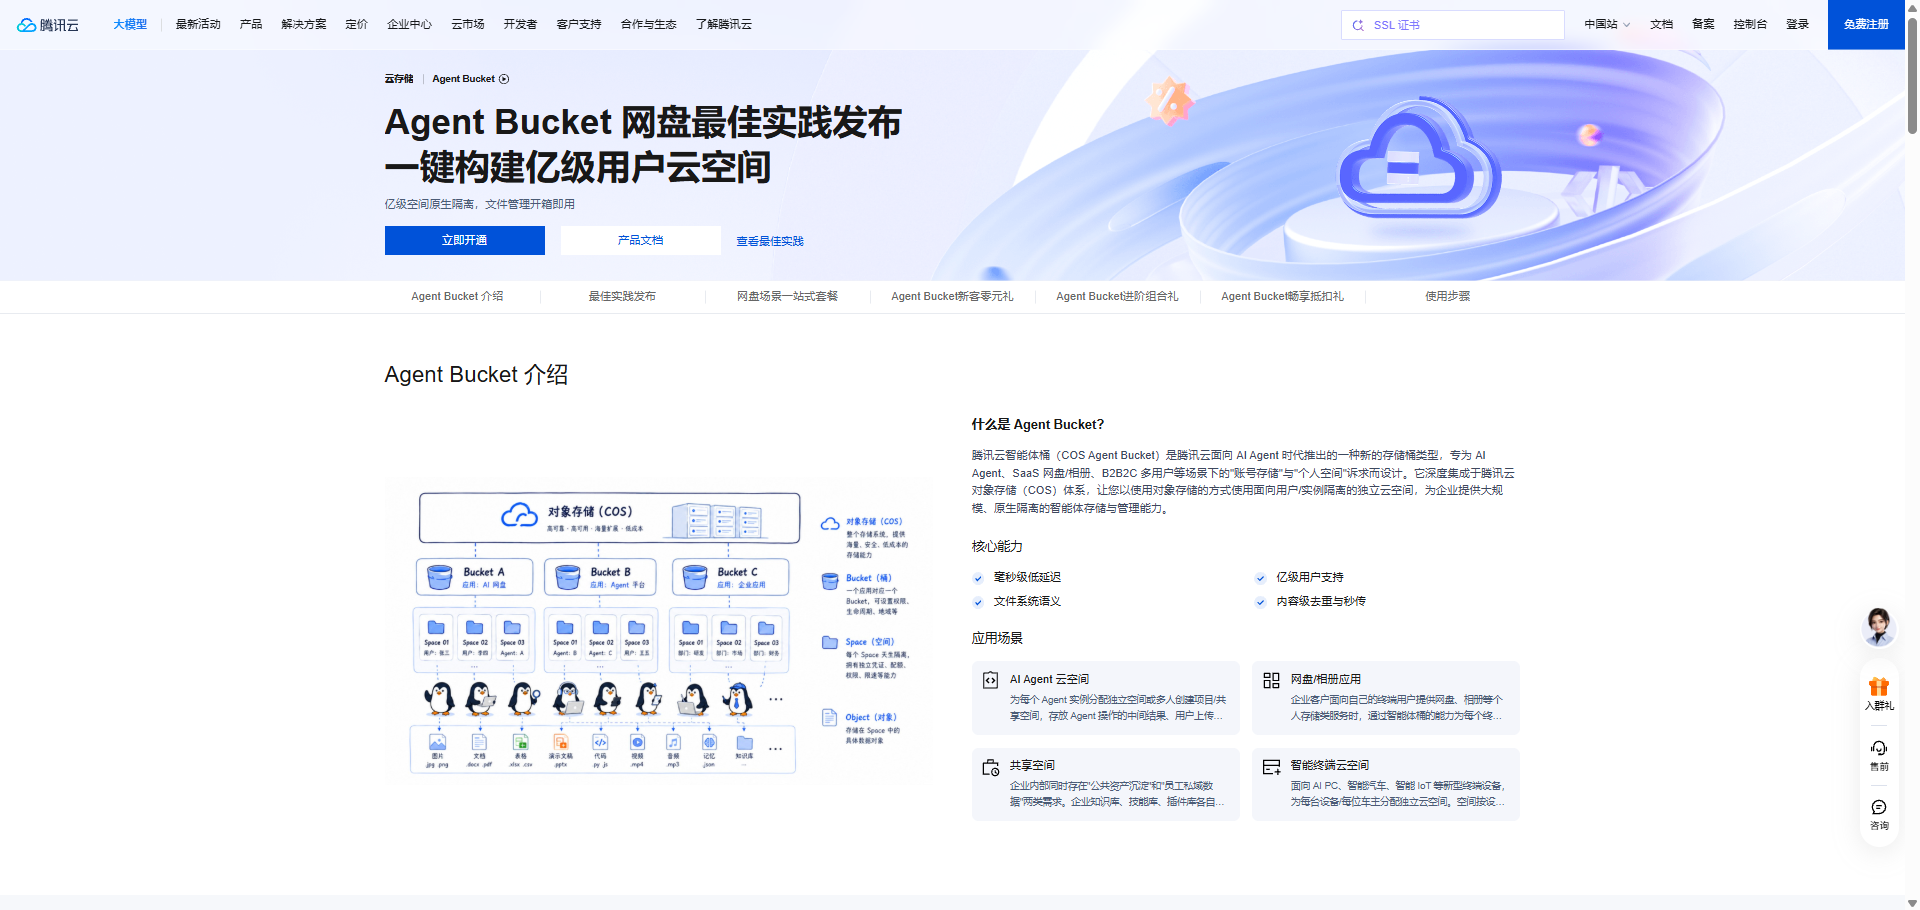
后来看到腾讯云 Agent Bucket(智能体桶),就拉起来测了一版,整体感觉是:它把“多用户/多Agent隔离”这件本来要自己造轮子的事,直接做成了存储层能力。
我的接入过程
流程比预期简单:
- 对象存储控制台开智能体桶,首次要授权 SMH 服务角色
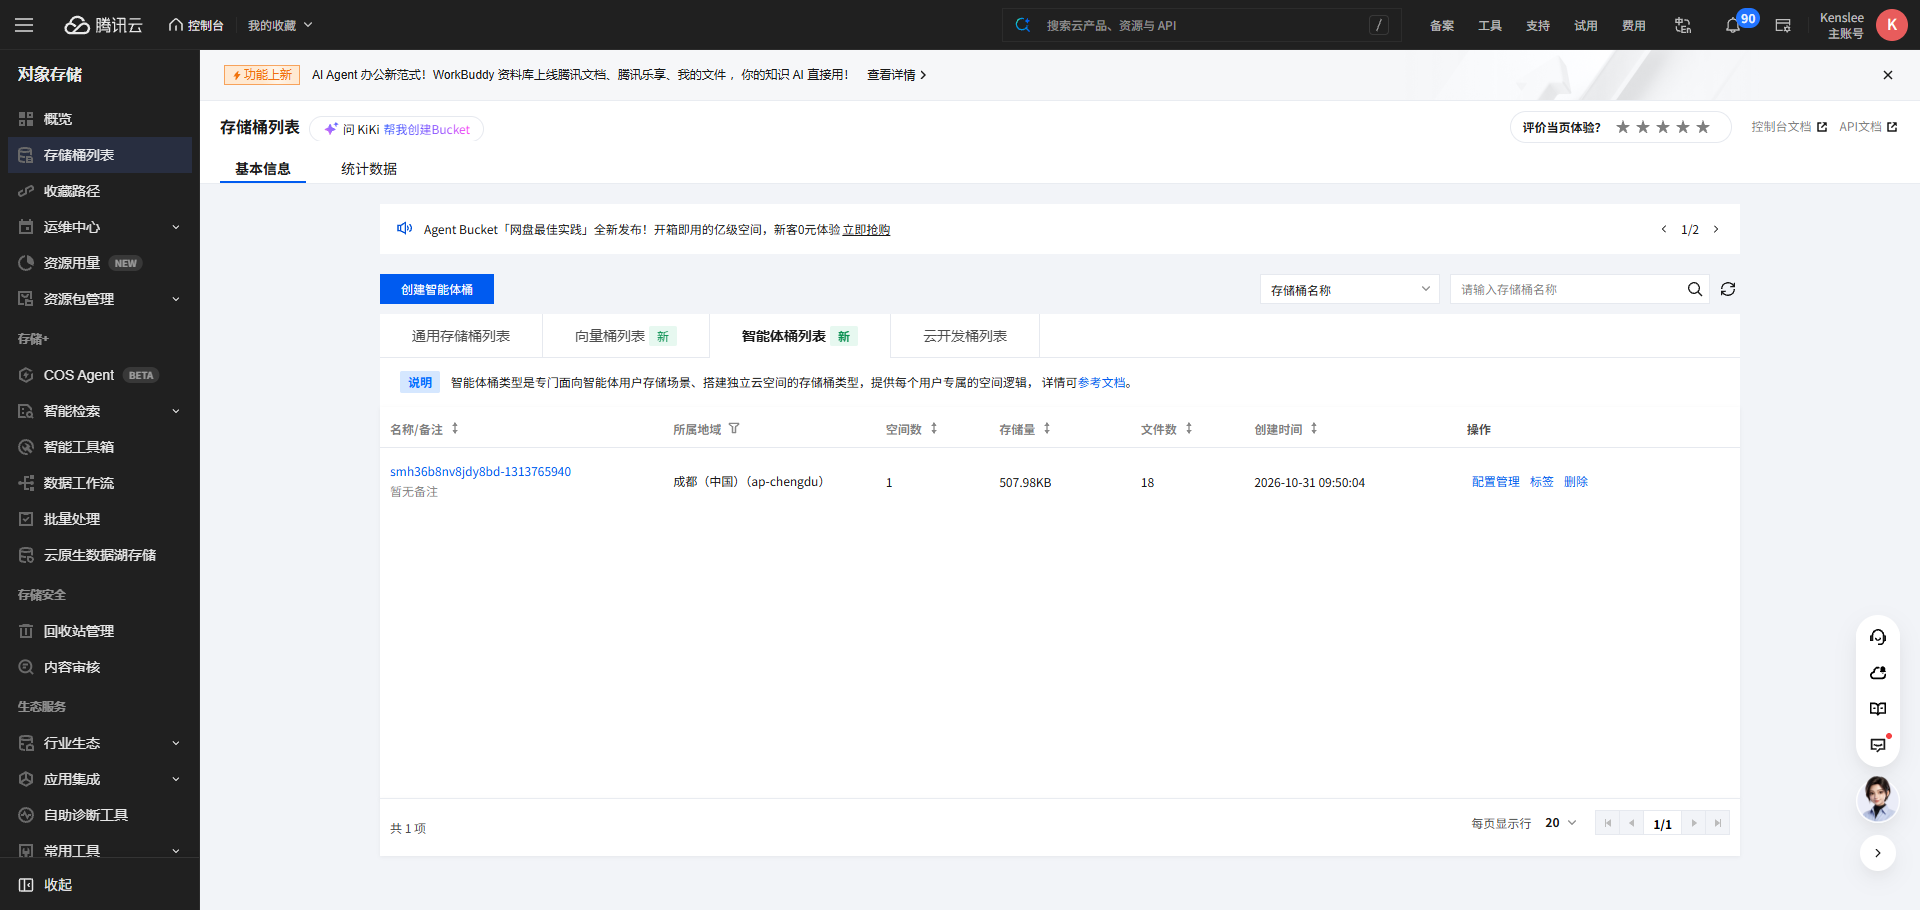
- 建一个 Agent Bucket,系统自动生成桶名
- 在桶下建 Space,一个 Space 对应一个用户或一个Agent实例
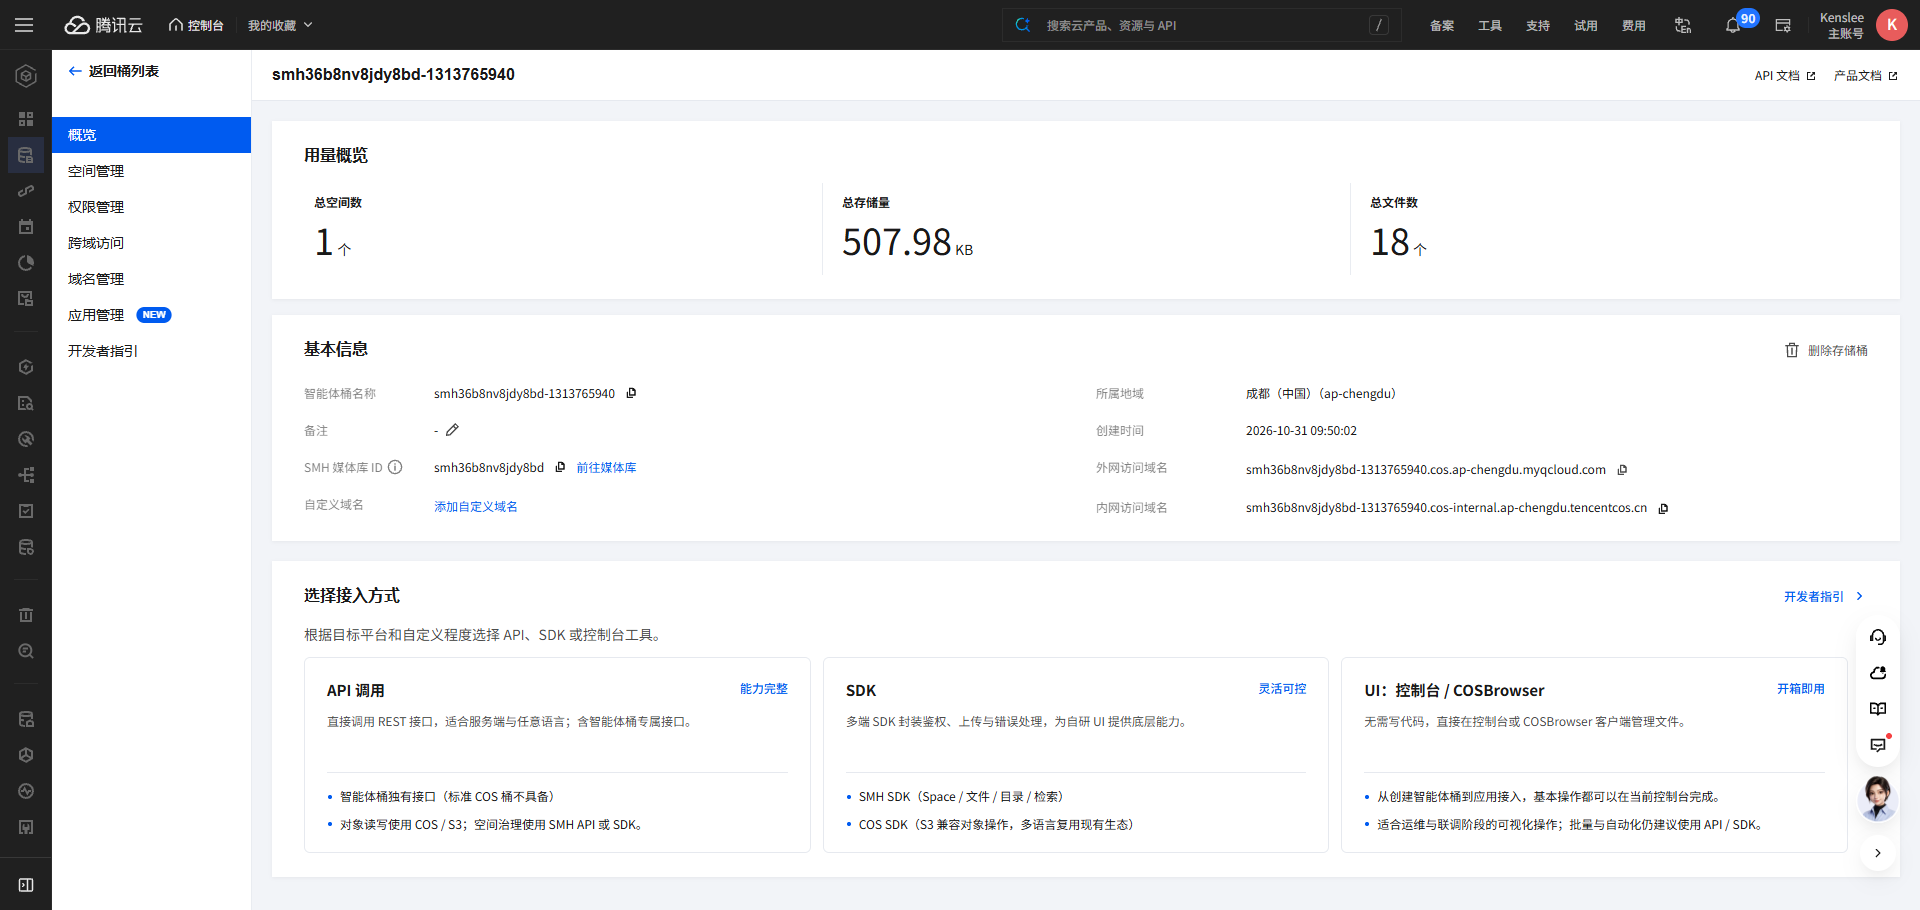
- 上传文件、建目录、用SDK读写,完全兼容COS/S3习惯
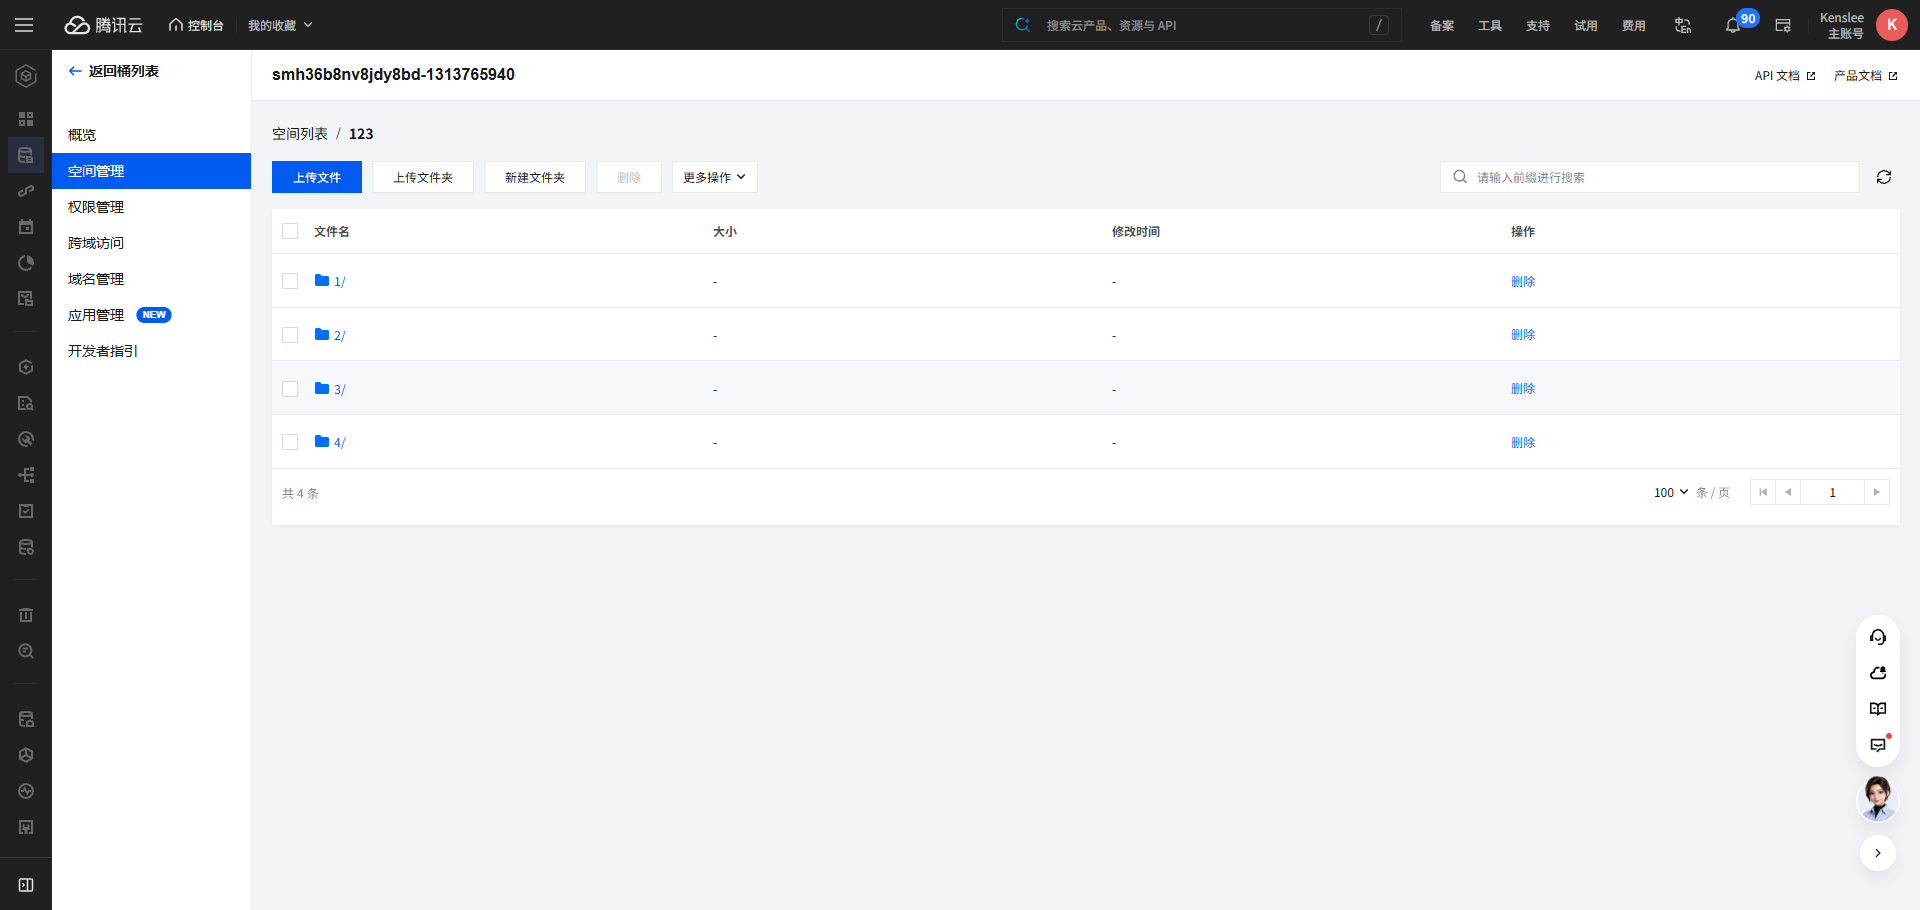
我自己的映射方式是:
- 每个终端用户 → 一个 Space
- 每个Agent运行实例 → 一个 Space
- 企业公共知识库 → 独立共享 Space
Space 这一层是关键。它不是业务代码里“假装隔离”,而是存储侧就有独立配额、权限、AccessToken和用量统计。
实际用下来,最爽的三个点
第一,不用自己写隔离逻辑了
以前多租户最怕串空间。现在Space天然隔离,业务侧只要管好“这个用户对应哪个SpaceID”,剩下的配额、鉴权、路径隔离由桶自己兜住。
第二,目录语义比裸对象存储舒服
Agent 跑任务会同时产出代码、图片、报告、日志。Agent Bucket 有类文件系统的目录管理,不用把所有东西拍平成一个长Key。Agent 自己建“/input /work /output /logs”就很直观。
第三,秒传和去重是真的省
同样一份产品手册,多个用户上传,底层按内容指纹去重。对我们这种“用户爱重复传PDF”的场景,存储成本能压下来。
我搭的一个最小实践
场景:用户上传Excel/PDF → Agent分析 → 产出图表+报告。
链路大概是:
- 用户文件进
space-user-001/input/ - Agent中间结果写
space-user-001/work/ - 最终报告写
space-user-001/output/ - 公共提示词、行业模板放
space-shared-templates/ - 前端用Space维度展示“我的文件”,后端按Space签临时凭证
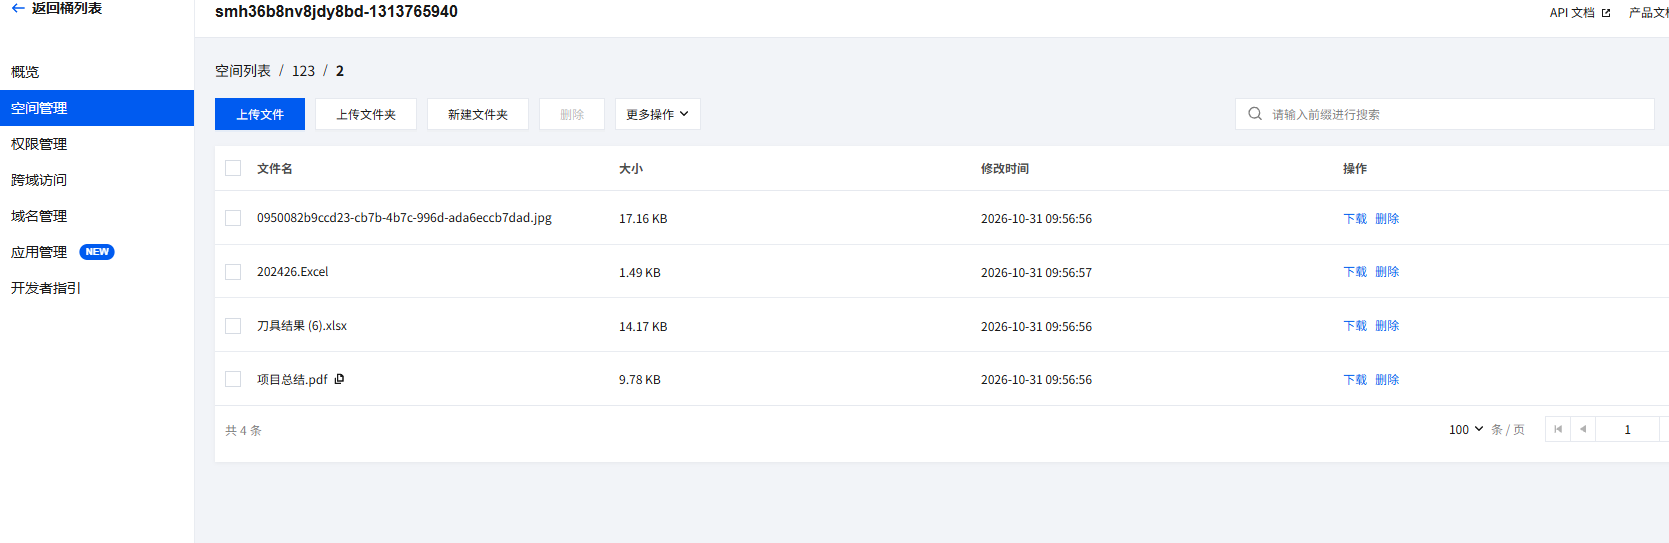
跑下来最直观的好处:会话结束了,文件还在;换设备登录,空间还在;Agent重启,上下文资料不丢。
小结
Agent Bucket 不是“又一个云盘”,它补的是Agent系统里最容易被忽略的一层:长期、隔离、可审计的工作空间。
对我这种做AI落地项目的人来说,它解决的是三件事:
- 多用户数据不串
- Agent产物可沉淀
- 文件权限不用从零造
AI Agent 要从“能聊天”走向“能干活”,存储底座迟早要独立出来。这次体验下来,Agent Bucket算是把这块短板补上了。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号