锁等待先找链头:一个 DBA Skill 在 WorkBuddy 和 CloudQ 里的实测
原创
锁等待先找链头:一个 DBA Skill 在 WorkBuddy 和 CloudQ 里的实测
原创
用户9970231
发布于 2026-10-20 16:57:04
发布于 2026-10-20 16:57:04
我把平时排查锁等待的步骤整理成了 db-lock-chain-triage,在金仓和 Oracle 19c RAC 上做实验(Oracle 部分用的是我生产排障在用的脚本),再放到 WorkBuddy、CloudQ 里测试。CloudQ 选中 Skill 后仍然给错过一条处置建议,这篇也记下了当时怎么改、改完又测出了什么。
一、背景:接口卡住了,该查哪个会话
做数据库运维,经常会碰到应用来找:下单接口卡住了,请求超时,也没拿到数据库报错码。如果查下来是锁等待,就得继续追,是谁拿着锁没提交。
锁视图一查几十行,日志每隔几十秒刷一条 still waiting for。等得最久、SQL 最显眼的会话容易引起注意,但它可能也在等别人。只结束这个会话,下游还会继续卡着。
我排查时会先找链头,看它是不是 idle in transaction,再确认有没有别的阻塞链混进来。今年做 KingbaseES 故障分析助手时,我发现模型在这几步上反复出错。每错一次就补一条规则,规则攒多了,就整理成了这个 Skill。
下面的案例都在演示或测试环境中构造。日志、视图结果和脚本输出保留的是实测内容,平台回答也是。
二、问题:一个三段锁链,三处容易判错
2026 年 9 月 13 日,一台 KingbaseES V009R002C014(Oracle 兼容模式)上,三个会话改同一张订单表的同一行。主机进程表和服务器日志(每个等待进程取最近一条):
PID      已运行(分:秒)  进程标题
1004761  10:31          kingbase: app_user test 127.0.0.1(22072) idle in transaction
1005031  09:35          kingbase: app_user test 127.0.0.1(36842) UPDATE waiting
1005115  09:03          kingbase: app_user test 127.0.0.1(32782) UPDATE waiting

[1005031] still waiting for ShareLock on transaction 1668 after 571340.369 ms
[1005031] DETAIL:  Process holding the lock: 1004761.
[1005115] still waiting for ExclusiveLock on tuple (0,2) of relation 18949 ... after 541291.546 ms
[1005115] DETAIL:  Process holding the lock: 1005031.
2.1 把中间会话当成了链头
1005115 的日志写着“Process holding the lock: 1005031”,只看这一行就会去处理 1005031。可 1005031 自己也在等,等的是 1004761 的事务 1668。1004761 在日志里一条记录都没有,因为它不在等任何人:拿了锁,什么都没做,事务也没结束。结束 1005031,1005115 拿到行锁后会转去等事务 1668,还是卡。
2.2 两条不相干的链混在一起
当天中午截日志时,同一实例上还挂着一对遗留会话,锁的是另一张表,已经挂了约 36 小时,当天写了 1641 行日志。巡检一跑,两条阻塞链加一个 36 小时的长事务同时出现,交给模型总结,很容易写成“长事务导致订单表大面积锁等待”。
2.3 只读账号看不全
诊断账号只给只读权限,故障分析助手的草稿里写着“当前连接数为 1”。核实下来,阻塞链的 SQL 有 4 处显示 <insufficient privilege>,其他账号会话的 backend_type 对只读账号不可见,实际至少 5 个连接。账号看不到的会话不能按不存在来算,报告里应当交代权限缺口。金仓有预置角色解决这个问题,GRANT sys_read_all_stats TO <只读账号>;,代价是能看到其他会话正在执行的 SQL 原文,给不给由 DBA 定。
三、方案:把判断写成 Skill
目录按 CloudQ 采用的 Skill 约定组织,元数据只有 name 和 description:
db-lock-chain-triage/
├── SKILL.md                       # 元数据 + 执行步骤 + 安全边界 + 铁律
├── references/evidence-rules.md   # 10 条判断规则,每条附真实反例或实测
├── references/oracle.md           # Oracle 取证视图与 RAC 实测结果
├── scripts/lock_log_chain.py      # 解析金仓服务器日志,还原链和链头,不连库
├── scripts/lock_evidence.sql      # 金仓 4 条只读 SQL(等锁数、阻塞对、未结束事务、连接分布)
├── scripts/oracle_wait_chains.sql # Oracle 用 v$wait_chains 从链头展开整条链
└── samples/                       # 实测日志
SKILL.md 正文只放流程和铁律,反例和细则放在 references,遇到计数对不上、权限不足,或是多链并存时再读。下面是当前版本,第 5、6 步和铁律的第二、三条是 CloudQ 测试之后改的(见 5.3 节):
---
name: db-lock-chain-triage
description: >-
  对数据库锁等待做根因定位——用服务器日志、进程表和锁视图三类证据拼出阻塞链,找到链头,
  排除遗留会话和旧证据的干扰,给出带依据的处置建议。当用户提到「接口卡住」「锁等待」「谁堵住了谁」
  「still waiting for」「idle in transaction」「enq: TX - row lock contention」时使用。
  已在 KingbaseES(Oracle / MySQL 兼容模式)和 Oracle 19c RAC 上实测。
  仅做只读诊断,结束会话等处置由 DBA 确认后自己执行。
---

# 锁等待根因定位

## 工具与证据边界

- `scripts/lock_log_chain.py`:解析 KingbaseES 服务器日志的 still waiting for 记录,还原链和链头,不连库
- `scripts/lock_evidence.sql`:KingbaseES 四条只读 SQL(等锁数、阻塞对、未结束事务、连接分布)
- `scripts/oracle_wait_chains.sql`:Oracle 用 v$wait_chains 从链头展开整条链,只读
- 主机进程表(`ps --ppid <实例主进程>`):KingbaseES 可选,能看到 `idle in transaction`、`UPDATE waiting`

SQL 通过平台的只读 SQL 工具执行。证据只来自「日志 + 视图 + 进程表」三类。应用日志、业务代码不在范围内;需要它们才能定论的,只输出假设并标注待验证。
判断规则和反例见 `references/evidence-rules.md`;Oracle 的视图差异和实测结果见 `references/oracle.md`。遇到计数对不上、权限不足、多条链并存、视图之间对不上时按需读取。

## 执行步骤

1. 确认采集口径:数据库类型与版本、实例(RAC 写明看了哪几个实例)、采集时间、账号权限。只用最新一次巡检,旧巡检只在做前后对比时才纳入
2. 拼链:KingbaseES 用日志脚本 + 阻塞对 SQL,两边合并去重;Oracle 用 v$wait_chains。一行只是一条边,必须拼到「不再等别人」的那个会话才算链头。不预设链的形状,同一行排队在不同数据库上可能是串行链,也可能是星形
3. 看链头:查链头的状态和事务时长。空闲却持有事务(KingbaseES 的 idle in transaction,Oracle 的 INACTIVE + SQL*Net message from client)说明它拿了锁但什么都没在做;它显示的 SQL 只是最后执行过的一条,不一定是拿锁的那条
4. 分组与排除:按锁对象把链分组,互不相干的链分开报;后台进程之间的等待链剔除;事务时长超过业务正常值一个数量级的会话单独标为「遗留会话」
5. 判断同行还是不同行:写处置建议之前,先看链上的会话改的是不是同一行(日志里的 tuple 位置相同,或阻塞对里的 SQL 落在同一个主键值上)。结论写进输出
6. 核对证据数量:视图里的连接数、等待数和进程表的会话数逐项对一遍,不管多出来还是少了,都列出差异和可能原因(例如多出的一条是执行采集的会话自己),说明无法排除什么
7. 输出:链结构、链头、同行还是不同行、各等待者已等时长、依据、证据差异、置信度及为什么不是更高、下一步只读验证或待 DBA 确认的处置

## 安全边界

只读诊断,不执行结束会话、取消语句、DDL、DML。
建议结束会话时,写明结束哪一个、对方未提交的事务会被回滚、结束之后下游预计怎么变化,由 DBA 确认后执行。
工具自动生成的 kill 名单,必须先和链头核对再转给 DBA,不原样转发。
采集账号的权限不足时,如实报告「看不全」,不替用户提权,给出授权语句和代价由 DBA 决定。

## 铁律

- 链头以「不再等别人」为准,不以等得最久、语句最显眼为准。处置建议默认指向链头
- 链上会话改的是同一行时,结束任何非链头会话都放行不了下游,下游会改为等链头。不得写「结束中间会话可以临时释放下游」。这一条在 KingbaseES 和 Oracle 上都实测过
- 只有链由不同行串起来时,结束中间会话才能放行它后面的会话,代价是回滚一个正常业务事务,链头照样占着锁
- 判断有没有锁等待,看查询结果,不看证据里有没有锁查询的文本
- 出现 `<insufficient privilege>`、视图里的连接数和进程表对不上(多或少)、blocking_session 为空但等待事件是锁、RAC 只查到部分实例,结论都要标出「看不全」或差异,不能写成「各类证据一致」
- 置信度必须说明为什么不是更高;日志和视图、视图和视图对不上时上报差异,不挑一边用
日志脚本只做一件事:把每组 still waiting for 和 Process holding the lock 读成“谁等谁”的边,沿边往上走到不再等别人的进程。对 9 月 13 日的日志片段跑一遍:
$ python3 scripts/lock_log_chain.py samples/kes-oracle-mode-20260913-1536.log
== 链头 1004761(日志里没有它的等待记录,是持锁方)
   1005031 等 1004761 | ShareLock on transaction 1668 | 最长已等 571.3s
   1005115 等 1005031 | ExclusiveLock on tuple (0,2) of relation 18949 ... | 最长已等 541.3s
== 同时段终止类信号: 无
链头是从别人的 holding 列表里拼出来的,我自己翻日志时也最容易漏这一步。库内的阻塞对 SQL 同理,一行只是一条边,三段链返回两行,必须拼起来再下结论。完整 SQL 在仓库里。
四、实测:金仓复现,Oracle 对照
4.1 金仓:三类证据同时采齐
在同一台金仓实例上建两行的实验表,三个会话依次改同一行,等 40 秒后同时采三类证据,全部会话最后 rollback,实验表删除:
进程表    658916 idle in transaction | 658917 UPDATE waiting | 658918 UPDATE waiting
阻塞对    658918(B) <- 658916(A)     | 658917(C) <- 658918(B)
等待事件  A: Client/ClientRead       | B: Lock/transactionid  | C: Lock/tuple
日志脚本  链头 658916;658918 等 658916(事务锁);658917 等 658918(行锁)
三类证据给出同一条链,形状和 9 月 13 日一样。顺带核实了一件事:这台实例 log_lock_waits 是 off(默认值),日志照样在等锁约 31 秒时写出了 still waiting for,所以规则里写的是以日志实际内容为准,不要凭参数推断有没有日志。
然后只结束带 locklab 标识的实验会话,看下游怎么变:
场景 | 结束谁 | 之后 |
|---|---|---|
同一行三段链 | 中间的 B | C 改为等 A,问题不变 |
同一行三段链 | 链头 A | B 拿到行锁,C 改为等 B |
不同行串成的链 | 中间的 B | C 立刻放行,A 仍持有行 1 |
同一行排队和不同行串联,结束中间会话的结果不同。后者虽然能放行下游,但会回滚中间会话的事务,A 持有的锁也还在。给处置建议前,必须把这两种情况分清。
4.2 Oracle 19c RAC:换一个数据库再测
在 Oracle 19c 双节点 RAC 测试库上构造了两种链,同时测了我生产排障一直在用的 Oracle 运维脚本。它有 bash 和 Go 两个版本(Go 版叫 dbatool),生产环境里两个版本都在用,阻塞链部分的 SQL 相同,这次实验跑的是 Go 版。它的 lsblk 子命令查 v$wait_chains,从不再等别人的会话往下展开,不同行的链输出如下:
INSTANCE SID             SERIAL SQL_ID        EVENT
       1 827              28217               SQL*Net message from client
       1   762             7362 f2v1jdr3faxm4 enq: TX - row lock contention
       1     814          62599 2v4ttgakxstpw enq: TX - row lock contention
KILL
alter system kill session '827,28217,@1' immediate;
缩进就是层级,kill 只给链头 827。结束会话的对照和金仓一致:同一行排队时结束非链头会话没有用,不同行的链结束中间会话能放行下游。
链的形状不一样。同一行排队,Oracle 上 B、C 都直接挂在 A 下面,是星形;金仓上 C 等的是 B 持有的行锁,是三段链。所以 Skill 不预设链的形状。
两个子命令给的 kill 名单也不一样。同一时刻,lsblk 只给 A;lstx 按“每个等待者的直接阻塞者”列,给出 A 和 B。照 lstx 全部执行,会多回滚一个正常事务。这两个命令在生产排障时都常用,以后用 lstx 的名单之前,要先和 lsblk 给出的链头对一下,Skill 里也写了同样的要求。
还有两处实验前没想到。链已经存在时,gv$session 里等待者的 blocking_session 可能是空的;lstx 的 gv$ 查询在这套 RAC 上报 ORA-12850,换成本实例 v$ 才出结果,只覆盖实例 1。ORA-12850 的根因我没查。我把这两种情况也补进了规则,要求报告写清查询覆盖了哪些实例、还有哪些信息没拿到。
达梦上也有同样的现象。之前在 DM9 上做过一次实验:持锁会话 A 在 V$SESSIONS 里显示 IDLE,SQL_TEXT 是它后来执行的一条查询,不是那条 UPDATE,最后是顺着 V$TRXWAIT 的等待关系才找到它。这对应 Skill 第 3 步:显示的 SQL 不一定是拿锁的那条。
五、挂载实测:WorkBuddy 与 CloudQ
5.1 WorkBuddy:自然语言自动触发
把整个目录放进 WorkBuddy 的技能目录,重启后在已安装技能里能看到它。两次测试都没有指定技能,直接用自然语言提问,模型是 Deepseek-V4.1-Flash,两次都自动选中了这个 Skill。
第一次只给 9 月 13 日的日志和进程表,告诉它连不上库。2 分 35 秒给出结论,链头 1004761,不要只结束 1005031;采集口径里写明“结论范围仅覆盖这一条链”;还指出了一个我没注意到的缺口,日志里一处写 OID 18949、一处写表名 orders,需要查元数据确认是不是同一张表。
第二次给 4.1 节同一时刻的三类证据:
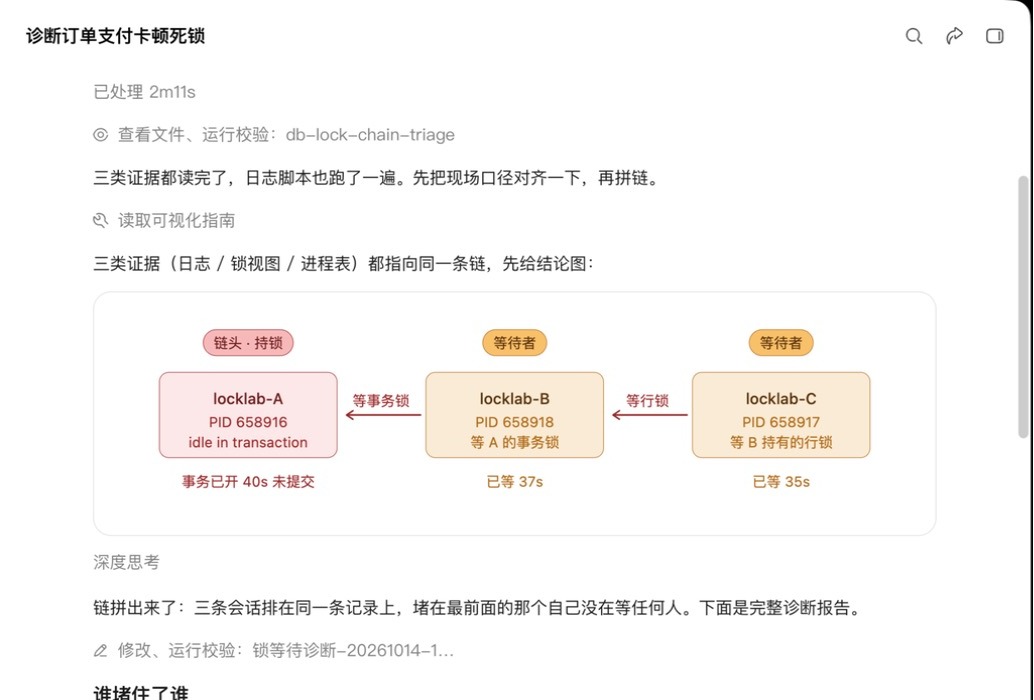
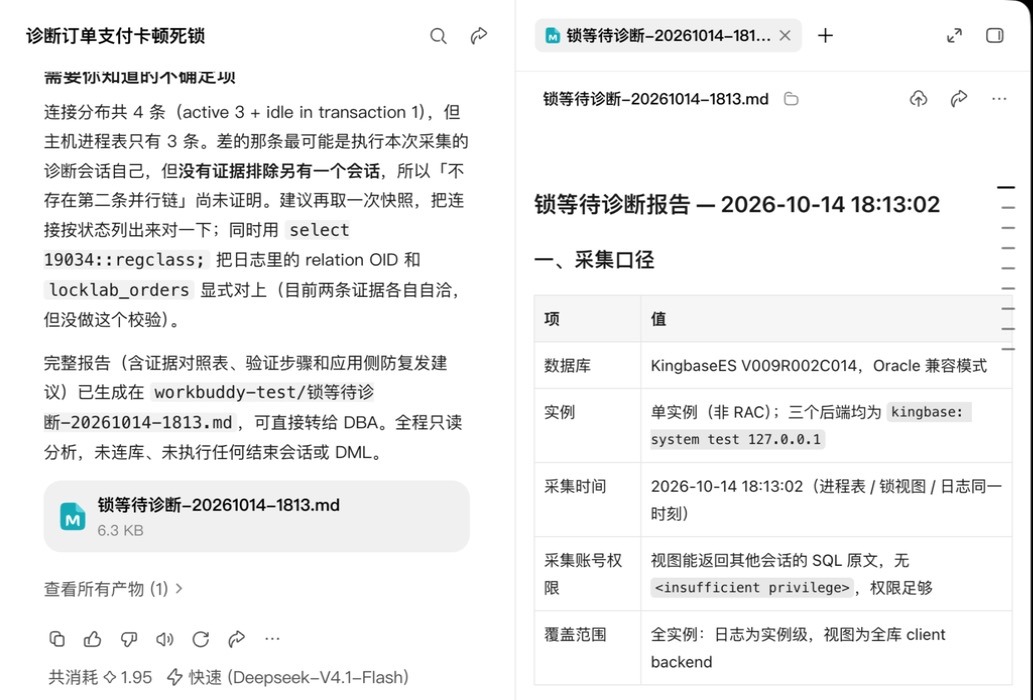
报告把三类证据逐条边对齐,处置首选结束链头,并写明“同一行排队时结束中间会话只是让 C 改为直接等 A”,还提醒自动生成的 kill 名单要和链头核对。它也注意到视图里 4 个连接、进程表只有 3 个,判断“最可能是执行本次采集的诊断会话自身,但无证据排除另有第 4 个会话”,实际确实是我的采集脚本。规则第 6 条已经写了这些实测结果,所以这次只能说明它用对了规则,还不能据此判断模型自己能推导出这个结论。
5.2 和 CloudQ 并列挂载
从 WorkBuddy 的技能市场装上 CloudQ(v1.9.0),两个 Skill 并排出现:
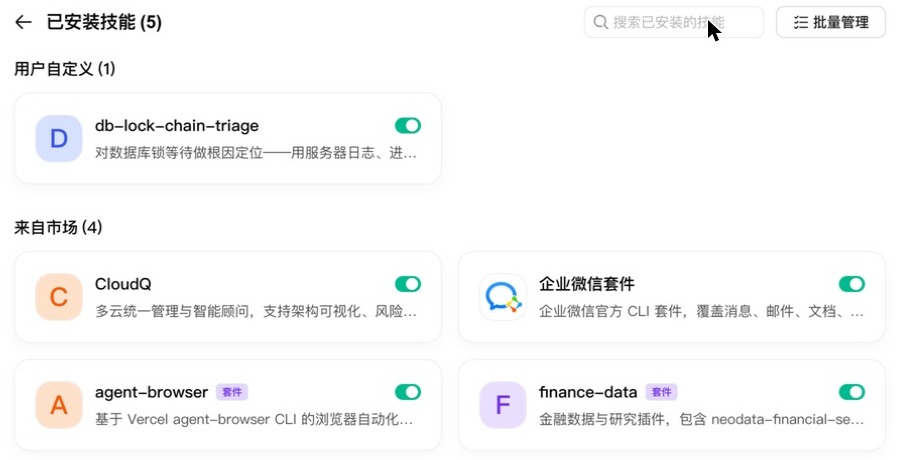
CloudQ 也采用这种目录约定。它把大部分问题转给腾讯云远端的智能顾问处理,路由规则里写明非云相关请求直接拒绝;本文的 Skill 全部在本地读证据、跑脚本。路由测试结果是两者各管各的:问腾讯云账号的高风险项,选中的是 CloudQ;问锁等待,只调用了本文的 Skill。
5.3 导入 CloudQ:用错一条规则,改写后复测通过
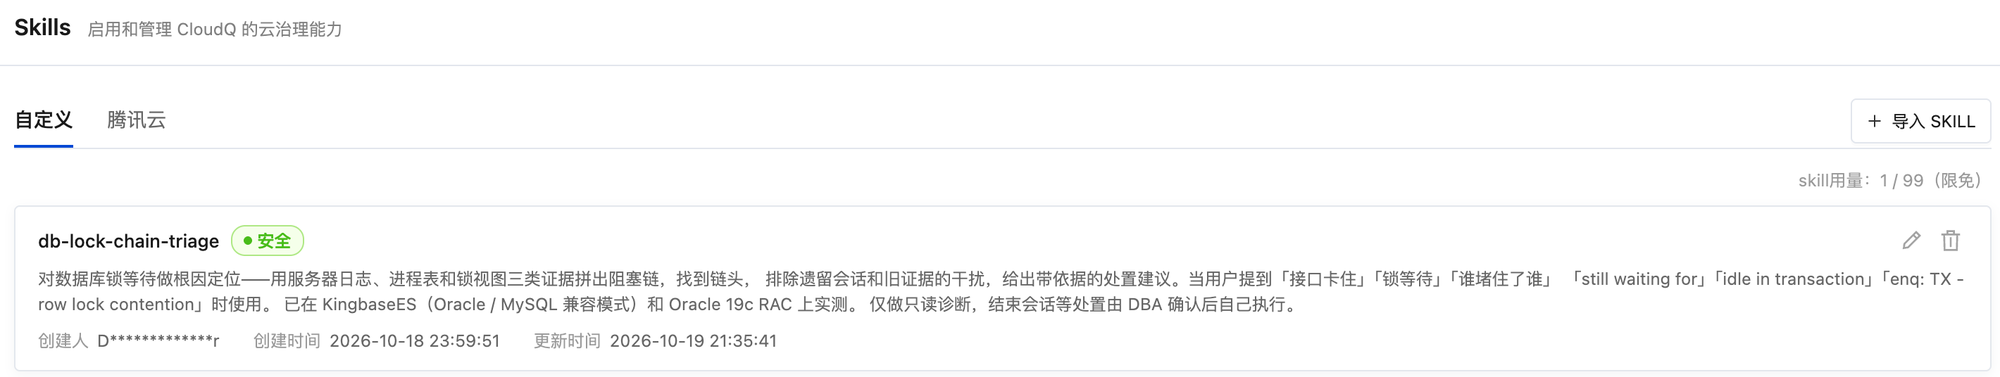
CloudQ 控制台的“Skills · MCP · 知识库”可以导入自定义 Skill。目录打成 zip 直接导入,没改任何文件,名称和描述自动解析,带“安全”标记:
CloudQ 在云端运行,读不到本机文件,我把 5.1 节第二次的三类证据原文贴进对话。
第一次不指定 Skill。结论正确,链头 658916,并且说对了“杀 658918 可能让 658917 继续等待 658916”。追问它用了哪个 Skill,回答是“没有用到”。
第二次在输入框的 Skills 里手动选中 db-lock-chain-triage。回答里出现了 SKILL.md 的原话,比如“真正的链头不是等得最久的 B/C,而是不再等待别人、但仍持有事务的 658916”,但处置建议错了一条:
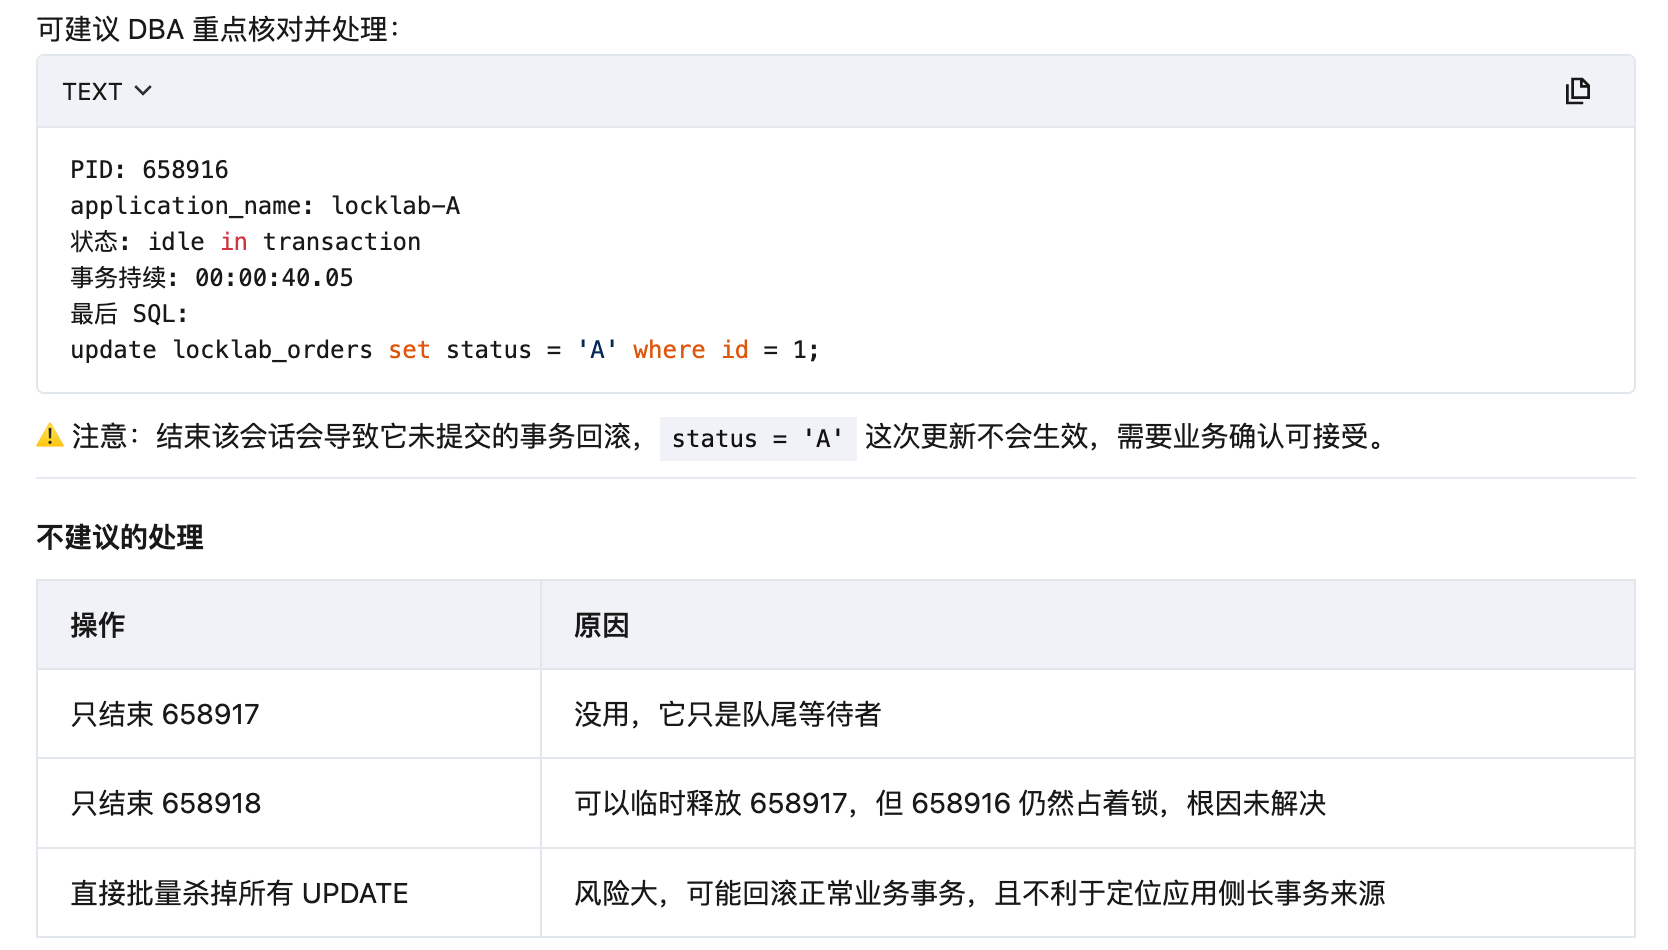
“只结束 658918,可以临时释放 658917”只在不同行的链上成立,这个案例是同一行,4.1 节实测放行不了。当时的铁律把两种情况写在一句里,它挑错了一种。它也没有指出连接数的出入。再追问用了哪个 Skill,回答变成“不能说明内部使用的能力名称、执行步骤或规则细节”。
针对这两处,我改了 SKILL.md:执行步骤里加一步“判断同行还是不同行”,放在写处置建议之前;铁律把两种情况拆成两条,同一行那条写明“不得写结束中间会话可以临时释放下游”;再加一步“核对证据数量”,视图和进程表对不上就列出差异。在 Skill 编辑页重新上传 zip,扫描一分钟左右恢复“安全”,新开会话、同样的证据再测:
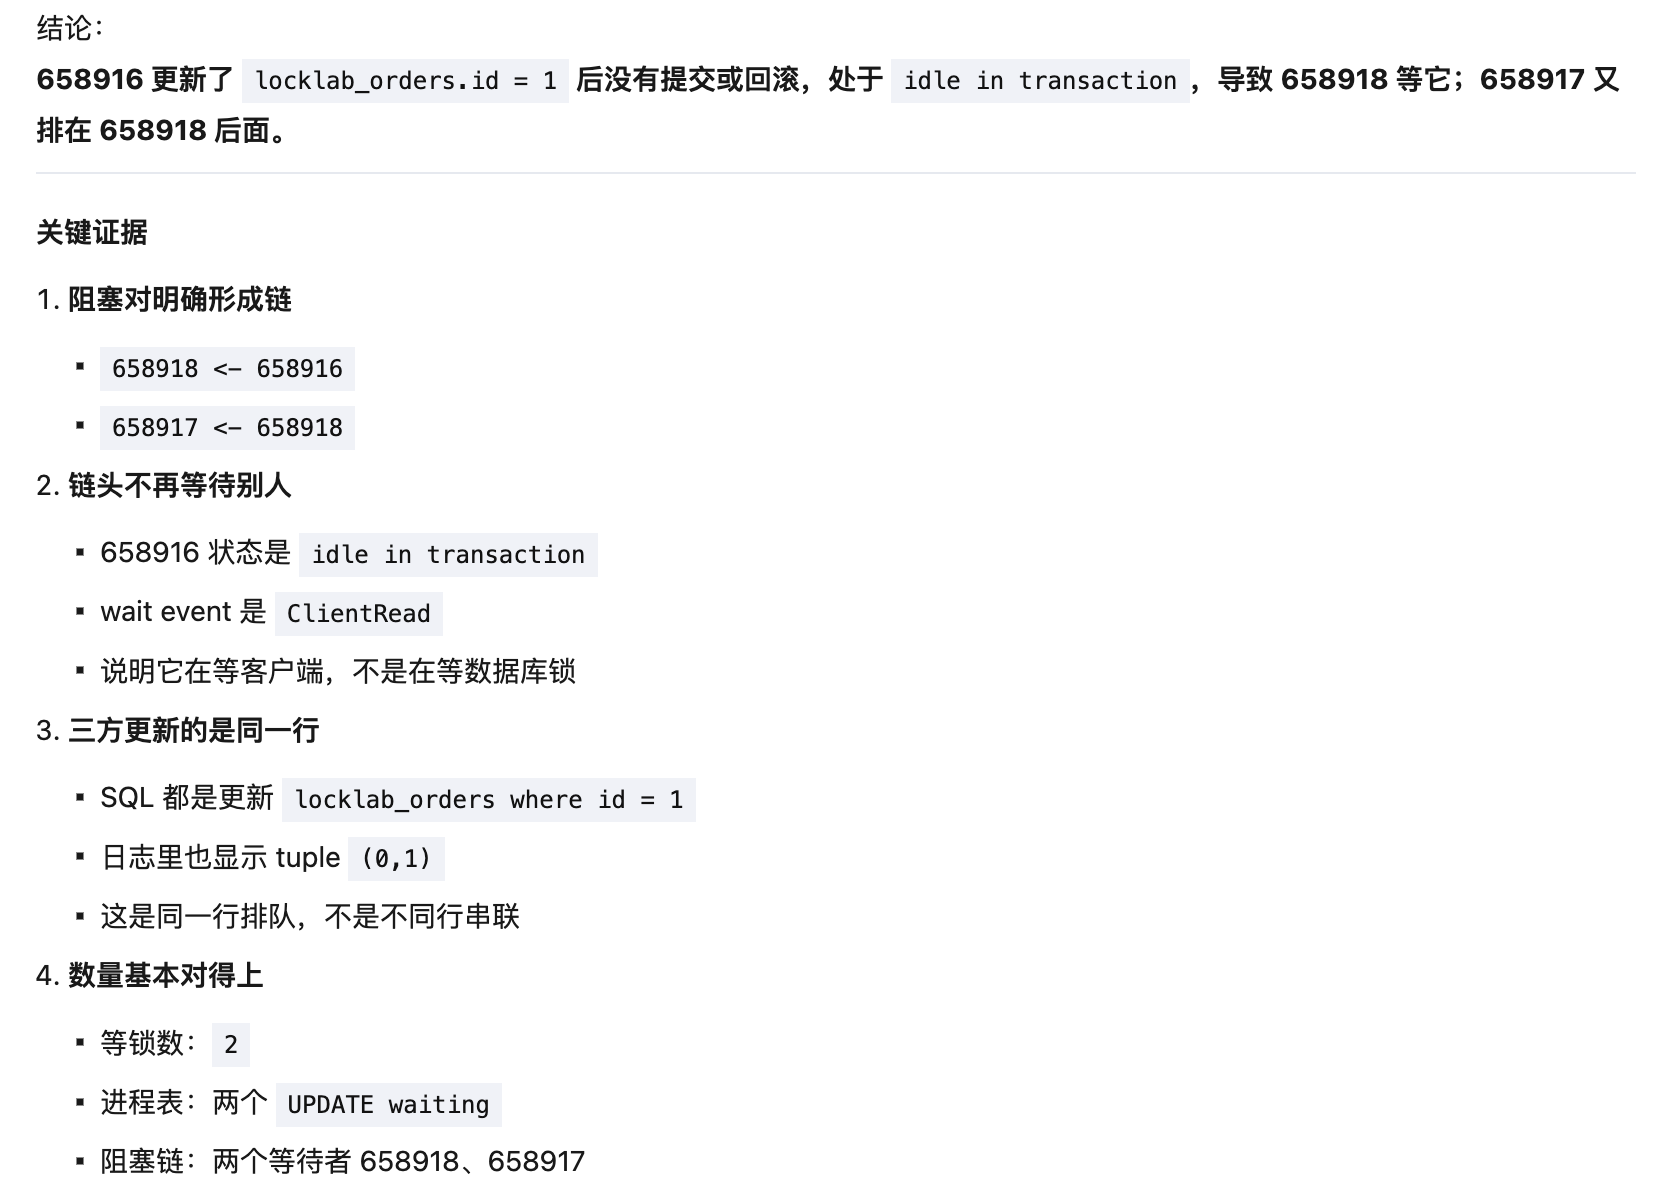
这次它先写明“这是同一行排队,不是不同行串联”,处置改成“同一行场景下,处理 658918 不会解决链头持锁问题”,连接数差异也列了出来:
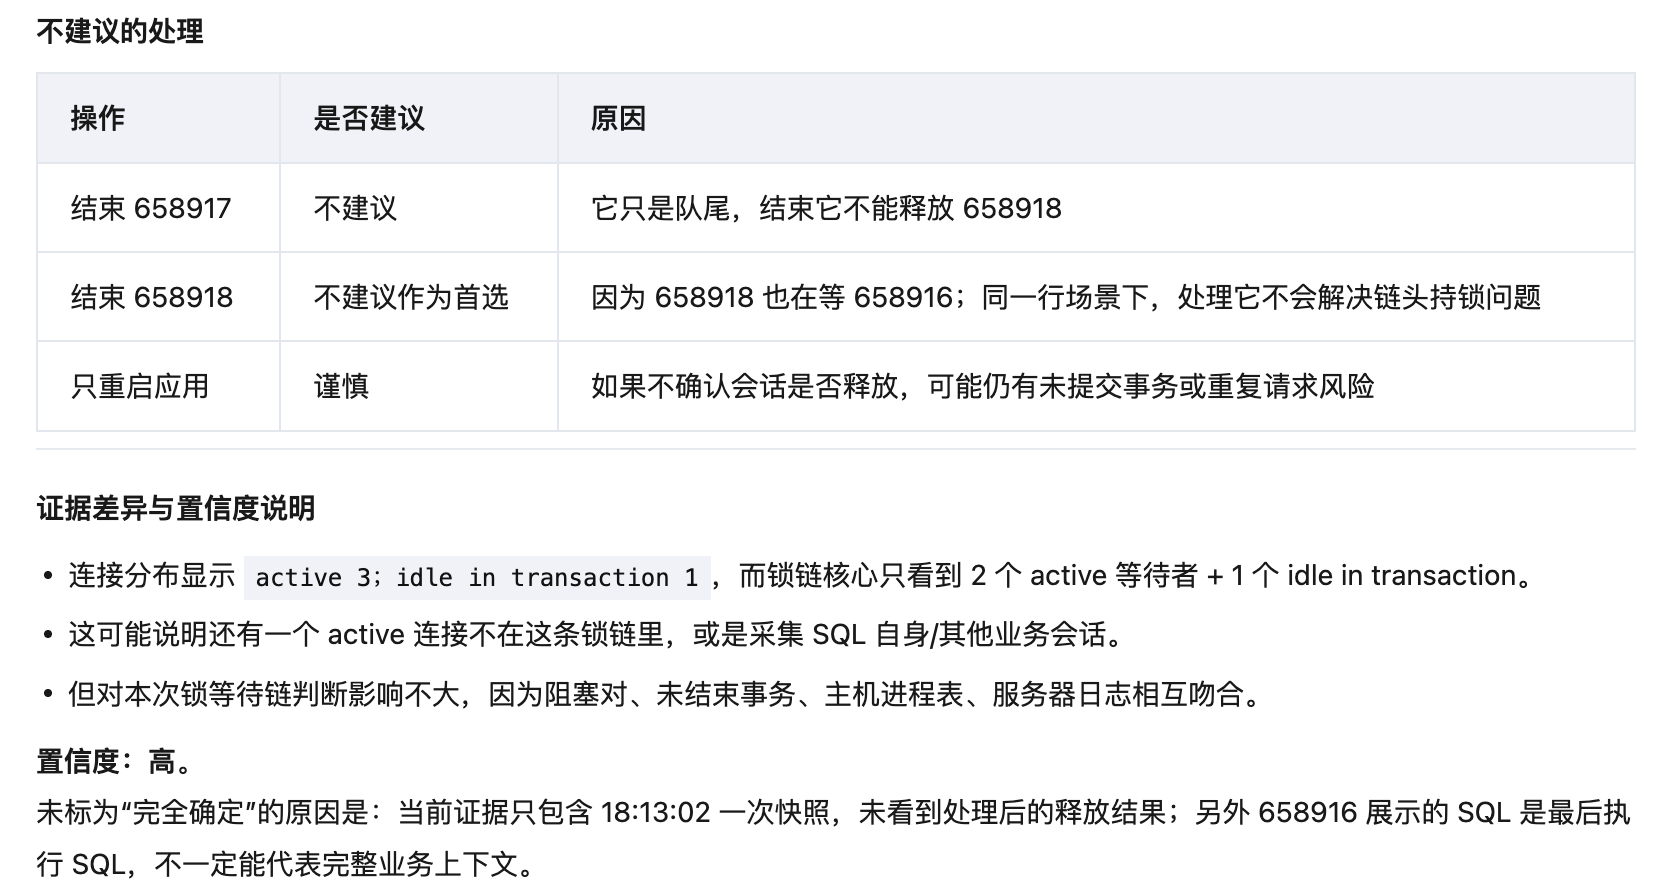
两处问题都没有再出现。复测只跑了一次,后面还要换几组证据再测。
从这几次测试看,CloudQ 没有稳定地自动选中自定义 Skill,后续测试需要明确调用它时,还是手动指定更好核对。至于处置规则,这次把判断条件单独提到前面后,模型给对了建议;能不能在其他案例里也用对,还得继续测。
六、对标信通院六大维度
维度 | 分层 | 这个 Skill 怎么体现 |
|---|---|---|
功能性 | 红线 | 七步诊断流程,包含采集口径、拼链、判断同行或不同行、核对证据、输出处置;金仓和 Oracle 实测,WorkBuddy 和 CloudQ 都调用过 |
安全性 | 红线 | 全程只读,不执行结束会话和任何 DML/DDL;工具生成的 kill 名单先和链头核对(实测生产常用的 lstx 会把中间会话列进去);Agent 对 Skill 的改动走 diff 和人工核对 |
可靠性 | 核心 | 链头按“不再等别人”判定,不预设链形;处置前先判断同行还是不同行(CloudQ 出错后加入,复测通过);权限不足、视图对不上都报“看不全” |
成本效益 | 核心 | 三类证据合计不到 3KB;一次完整诊断在 WorkBuddy 里实测消耗 1.95 和 3.08 积分;只读最新一次采集 |
性能效率 | 评价 | 4 条 SQL 走现成视图,14 项巡检实测 0.5 秒;日志解析不连库;WorkBuddy 端到端 1 分 54 秒到 2 分 35 秒 |
用户体验 | 评价 | WorkBuddy 里自然语言即可触发,CloudQ 里手动选中;输出含锁链图、链头、链形、证据差异、置信度缺口和处置建议,可直接转给 DBA |
七、二次开发里踩过的坑
7.1 第一版是照着脚本移植的
这个 Skill 之前有过一个第一版,SQL 直接从生产在用的 lsblk 和 lstx 搬过来,说明文字照脚本的行为写,没在库上专门测过。拿 Oracle 实测去对,它有两处说法站不住:按直接持锁方给 kill 名单,会把中间会话列进去;“RAC 下用 gv$ 能看到全集群”,实测报了 ORA-12850。脚本在生产上一直在用,我当时就按它的输出写处置规则,没有逐项验证这些名单能不能直接用于故障处理。
7.2 判断信号写错了地方
故障分析助手早期只要证据文本里出现锁视图查询,就判为检测到锁等待。每份巡检都带这条 SQL,于是锁释放后的“修复后验证”也被判成检测到。改成看查询结果,等锁数大于 0 或日志里有 still waiting、deadlock 这类信号才算,用 4 组证据回归通过。后来在规则里明确要求检查查询结果,不能拿 SQL 文本当作存在锁等待的证据。
7.3 一个冒号让 description 整段失效
我给 description 补触发词时加了「enq: TX - row lock contention」,冒号加空格在不加引号的 YAML 多行字符串里会被当成键值对,整个 frontmatter 解析失败。WorkBuddy 不报错,只是退回用名字当描述,模型就少了判断何时触发的依据。改成 description: >- 后恢复。现在每次改完 SKILL.md 先用 yaml.safe_load 解析一遍,数据库运维的触发词里冒号很常见。
7.4 Agent 会自己改 Skill
WorkBuddy 第一次测完,自己往 references 里补了两条规则:进程表时长是“分:秒”不是“时:分”;拿不到视图时结论要自带范围声明。内容都对,我核对后合并回了源文件。但 Skill 是要共享的资产,被 Agent 静默改写,下一个人拿到的就不是评审过的版本。现在的做法是源文件进版本库,挂载目录只当部署副本,每次测试后做一次 diff,改动走人工核对。
八、总结
这次测试里,处置建议这一项出了问题。链头找对了,模型还是可能建议结束中间会话;把条件写在同一句里,它也可能用错。金仓上的对照实验已经做过一遍,到了 CloudQ 里仍然出了这个问题。
以后再补规则,我会把判断条件放进执行步骤,再拿对应案例去测。只看回答里有没有出现 SKILL.md 的原话,还不够,得看它最后建议 DBA 处理谁,以及会回滚哪个事务、下游接着等谁。CloudQ 这次改完只复测了一次,我还不能说这条规则已经测稳了。
维护上也有两件小事要继续做,改完先检查 YAML,测试后再对比挂载目录和源文件。前面那个冒号和 Agent 自动补规则的问题,都是靠这两步才能及时发现。
这次没测的:CloudQ 从云侧发现实例异常、再把数据库层交给本 Skill 的联动,测试库是自建的,不在 CloudQ 的视野里;达梦的取证视图还没写进 Skill;死锁成环的分析也没做。下一步先查 ORA-12850,再补达梦和死锁。
Skill、金仓和 Oracle 的复现脚本都在 https://github.com/sjw1933/db-lock-chain-triage ,WorkBuddy 和 CloudQ 的测试记录也在,复现脚本只能在测试库上跑。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号