Jev 对比传统大模型:速度、成本、可靠性到底差在哪
原创
Jev 对比传统大模型:速度、成本、可靠性到底差在哪
原创
hollyx
发布于 2026-09-23 19:32:41
发布于 2026-09-23 19:32:41
这一周我做得最多的一件事,就是把同一批判断任务分别丢给 Jev 和几款传统大模型,然后把速度、成本、可靠性和准确率一项一项摆到一起看。外界的说法大多是"Jev 快几百倍、便宜几百倍",但真正落到我自己的工作负载上,这句话既对也不对。这篇文章我不谈感受,只把可对照的数据和机制差异讲清楚:它们到底差在哪、差多少、以及在什么前提下这个差距才成立。文中数据来自 TypeSafe 官方评测与我参考的第三方实测,Jev 仍处早期访问阶段,口径可能调整。
一、先厘清:它们根本不是同一类模型
对比之前必须先说清一件事,否则容易比错。传统大模型(GPT、Claude、DeepSeek 这些)是生成式的,产物是"给人读的文本";Jev 是 TypeSafe 的 System One 决策模型,产物是"给程序用的类型化判断"。
这意味着我拿它们对比,只在一种任务形态上公平,分类、路由、打分、真伪判断这类"判断题"。一旦任务变成写代码、写文案、做多步推理,Jev 根本不参赛,因为它压根不生成文本。所以下面所有的对比,前提都锁定在"判断类任务"上。把这个前提丢掉去谈"谁更强",是没有意义的。
二、速度:毫秒级与秒级的代差
先看最直观的速度。传统大模型是自回归的,逐个 Token 串行生成,一段结构化结果要一个字一个字"蹦"出来,端到端延迟通常以秒计。Jev 是并行一次采样,官方公布的端到端延迟约 70~500 毫秒。
我参考的第三方实测(挪威开发者 Emil Lindfors,2026 年 9 月 18 日)给了一组更具体的数字:同一批文档判断任务,Jev 中位延迟 0.32 秒,DeepSeek V4.1 Flash 关闭推理是 2.7 秒、开启推理是 26 秒。也就是说,在这个场景里 Jev 比同一款大模型快了约 8 到 80 倍。这跟我自己的观感一致:Jev 的延迟不随输出长度增长,而大模型一旦开了推理,延迟会显著拉长。
三、成本:一到两个数量级的差距
成本这一项差距更大,而且比速度更容易核对,因为它直接来自定价。
Jev 的输入价格是每百万 Token 0.042 美元,输出免费,它没有传统意义上的输出 Token 生成,自然不收输出费。作为对照,TypeSafe 给出的大模型输入价格区间是每百万 Token 0.20~10 美元,且输出通常比输入更贵(约 5 倍)。
同样是那份第三方实测,落到"每 1000 份文档"的实际账单上:Jev 0.22 美元,DeepSeek V4.1 Flash 关推理 1.31 美元、开推理 3.08 美元。差距大约在 6 到 14 倍。对我这种要跑高频、海量判断的场景来说,成本这一项往往才是决定用不用得起的关键。
四、把三项放到一张图上看
我把官方工作流评测(准确率、单次成本、单次耗时)整理成一张对照图,Jev 用青色标出。这张图最能说明它的真实位置:
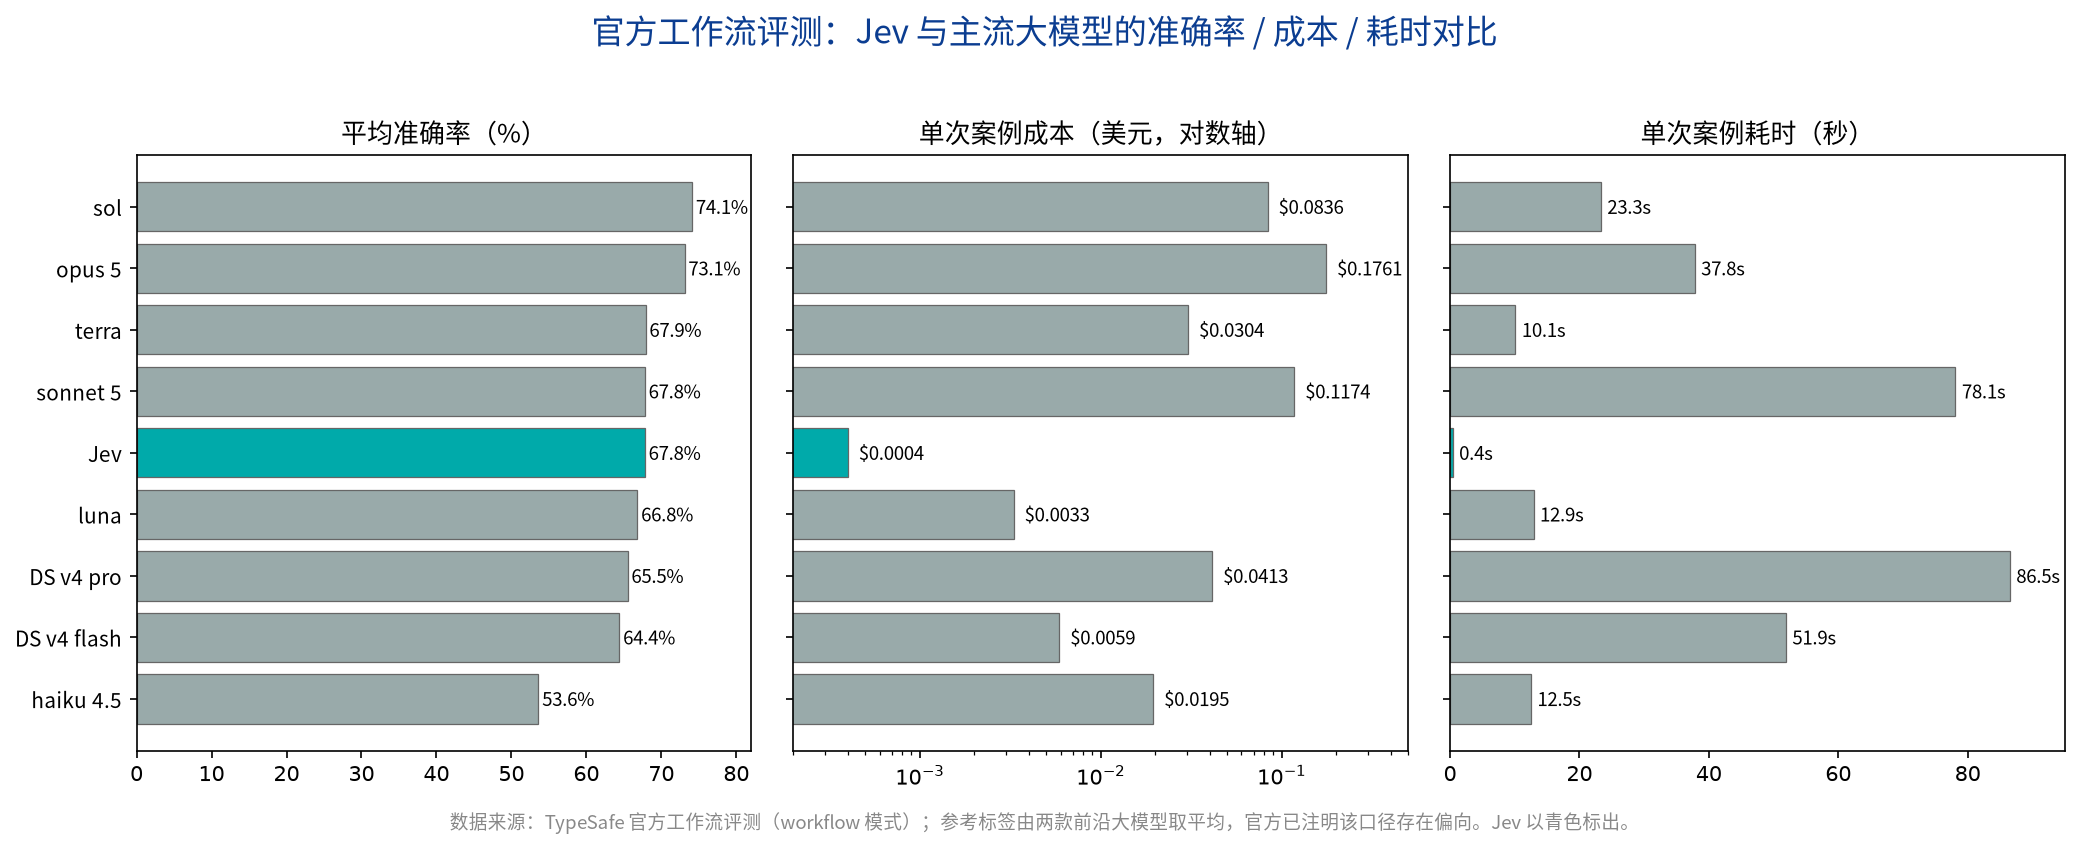
官方工作流评测:Jev 与主流大模型的准确率、成本、耗时对比
这张图我建议横着读,而不是只盯一列:
维度 | Jev 的位置 |
|---|---|
准确率 | 67.8%,处于中游,有两款前沿模型高它 5~6 个点,另有两款与它几乎持平 |
单次成本 | 0.0004 美元,比其他模型低一到两个数量级 |
单次耗时 | 0.4 秒,同样低一到两个数量级 |
对照最明显:opus 5 的准确率 73.1%,但单次要 0.1761 美元、37.8 秒;Jev 用 0.0004 美元、0.4 秒换来 67.8%。准确率上它没有赢,真正拉开差距的是成本和时间。这句话是这次大多数报道都忽略的重点,Jev 的卖点从来不是"更准",而是"用极低的成本和延迟拿到够用的准确率"。
五、可靠性:机制层面的差异,而不是准确率
很多人把"可靠性"和"准确率"混为一谈,我认为要分开看。
准确率上,前面已经说清楚,Jev 与前沿大模型大致在一个水平,没有明显优劣。真正的机制差异在另一处:让大模型输出结构化结果,仍要经过"生成文本再解析"的环节,存在格式出错、字段跳出枚举、甚至多写一句解释导致解析失败的风险,这些坑我在用大模型做判断时都踩过。Jev 的输出被约束在我给定的 schema 里,从机制上就不可能返回一个不存在的选项,官方把这个性质称为"在类型上不可证伪"。
但我必须把话说准确:这叫"不越界",不叫"永远正确"。Jev 一样会选错,也可能给错误答案分配高概率。它保证的只是格式和取值永远合法。对自动化来说,一个"偶尔选错但永远不越界"的答案,比一个"埋在几层依赖里、偶尔越界"的答案安全得多,这才是它在可靠性上的真正价值。
配套的还有校准置信度:Jev 每个 Choice、Score 答案都带一个 0 到 1 的置信度,且校准方向正确(高置信度对应更高正确率)。这让我可以按置信度分支,高的自动执行、中的转人工、低的交给更强模型。传统大模型自述的"我有 95% 把握"往往和真实正确率对不上,这一点上 Jev 更可用。
六、这些差距成立的前提
把上面几项收拢,我想强调差距成立的边界,避免被"几百倍"带偏。
第一,官方主页那句"最高快 193.6 倍、便宜 444.6 倍",官方自己注明是"实际收益的上限",来自内部编写的四个工作流,参考标签由两款前沿大模型取平均而来。它是最好情况,不是普遍结果。我在自己场景里实测到的倍数,通常落在"几倍到几十倍"这个更朴素的区间。
第二,所有对比只在判断类任务上成立。一旦需要生成、算数、比日期、多因素慢推理,Jev 要么不参赛,要么表现明显退化。
第三,准确率的参考标签本身由大模型生成,这个评测口径带偏向,官方也承认了。所以最靠谱的做法始终是:用我自己的数据、我自己的任务去测,再决定哪一段该换成 Jev。
七、我的取舍结论
一周对比下来,我的结论很简单:Jev 不是来取代大模型的,而是来接管大模型链路里那些"高频、原子、只要一个判断"的位置。在这些位置上,它用一到两个数量级的成本和延迟优势,换来与大模型基本持平的准确率,外加机制层面的类型安全和校准置信度。而在需要生成和复杂推理的地方,大模型依然不可替代。真正成熟的用法,是让它们各就各位,大模型负责想清楚和写出来,Jev 负责在执行链路里飞快地拍板。这条"决策与生成分工"的线,是我这次对比后最想留下的判断。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号