用 WorkBuddy 写四十万字长篇:让 AI 不"失忆"的一套笨办法 #WorkBuddy#
原创
用 WorkBuddy 写四十万字长篇:让 AI 不"失忆"的一套笨办法 #WorkBuddy#
原创
用户12723800
发布于 2026-09-23 12:02:11
发布于 2026-09-23 12:02:11
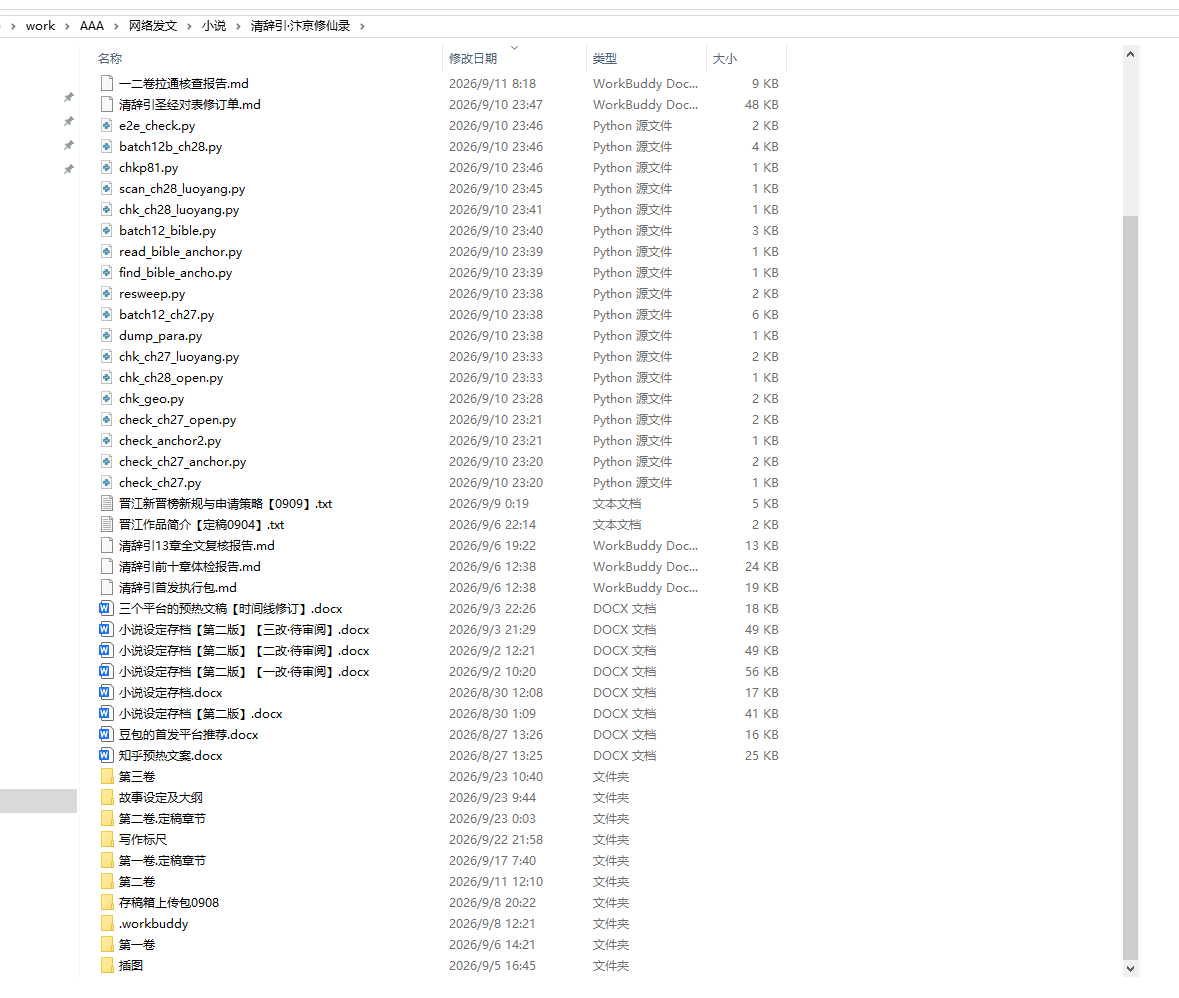
图1
一、先说结论:AI 写长篇,卡住你的从来不是文笔
我用 WorkBuddy 写一部北宋背景的长篇小说,正文四十万字量级,卷三写到第三十四章。前十二章很顺,写到第二十章开始出问题——不是写得差,是写得不像同一个人写的:
- 一个配角在第十五章是"沉默寡言的老卒",到第二十二章突然能说会道;
- 前边定过"这个人不知道那件事",后边他自己提起来了;
- 最要命的一次:我在大纲里标着"待裁"的两项,其实三个月前就已经裁过了,我又拿去问了一遍。
这些不是 AI 笨,是对话里的记忆靠不住。上下文一换窗口、一压缩,那些约定就蒸发了。
我的解法很笨,但有用:把记忆从对话里拿出来,做成硬盘上的文件。 让 AI 每次开工先读文件,而不是靠它"记得"。
二、四份档案,撑起四十万字
我的工作目录里,正文只占一小半,大头是这四样:
档案 | 作用 | 体量 |
|---|---|---|
故事圣经 | 不可违背的硬规矩(时间线、地理、人物关系、写作律条) | 单文件数万字 |
分章细纲 | 每一章写什么、埋什么、兑什么,以及当前状态 | 每章一个文件 |
人物速查卡 | 每个出场人物的定位、边界、他"知道多少" | 全卷一份 |
裁定补录 | 每一次讨论拍板的结论,按日期编号留档 | 一事一份 |
[ 配图位 ] 图1:我的档案目录——正文只占一小半,大头是这一屏 .md 档案 图1_档案目录.png
关键点在于:正文是可以改的,档案是不可以随便改的。 改档案要留痕,改正文要备份。
三、三条真正救命的制度(踩过坑才有的)
制度一:细纲顶部必须有"状态行"
每个细纲文件第一行是状态:✅ 已裁 / ⭕ 待裁 / ⏳ 待定。
判一件事做没做完,只看这一行,不许 grep 正文里的"待裁"两个字。
我在这上面栽过两次:大纲正文里写得清清楚楚"⭕ 待裁",可那一条其实早在细纲里已经拍板并落进成稿了,只有大纲没同步。我抄了大纲的标记,白问一遍,还差点把已经定好的东西推翻重来。
教训:标记会过期,状态行不会。 状态行是唯一权威。
制度二:动刀前先备份,备份名字要能看出"改的什么"
我的正文目录长这样:
第三十四章 勘辨【初稿0918】.docx
第三十四章 勘辨【初稿0918】_备份0920五次修订前.docx
第三十四章 勘辨【初稿0918】_备份0920六次修订前.docx
第三十四章 勘辨【初稿0918】_备份0920七次修订前.docx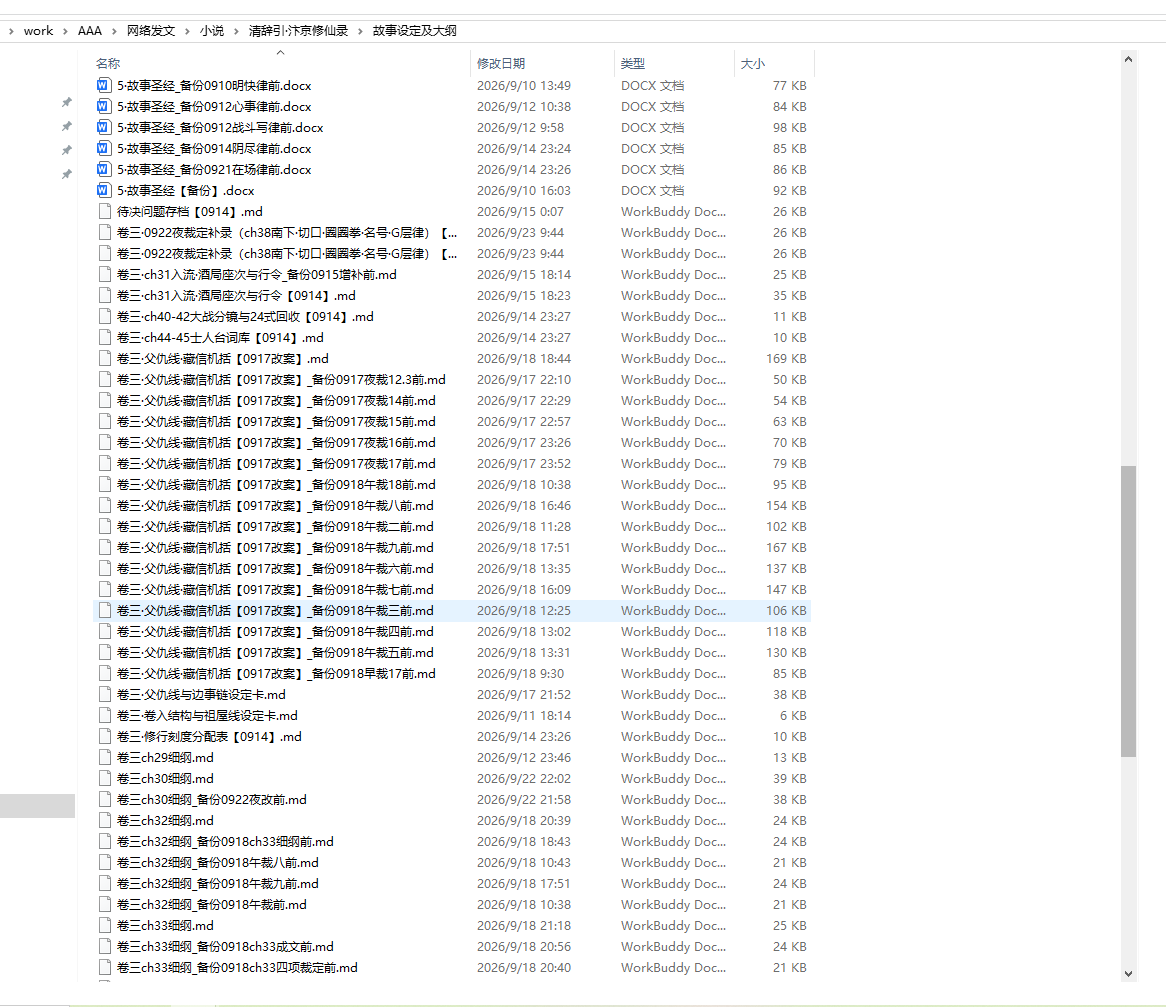
图2
[ 配图位 ] 图2:一章正文的八个备份——文件名直接写明"第几次修订之前" 图2_备份列表.png
一天改八次,就有八个备份。命名规则="备份+日期+这次改的是什么之前"。 哪一次改坏了,一秒回得去,不必跟 AI 来回拉扯(来回拉扯是最费积分的)。
制度三:批量改 docx,别用 python-docx
这是纯技术的一条,但省了我大量时间。
早期我用 python-docx 做批量替换,改完格式全乱——字体、样式、段落间距会丢。后来改用直接操作 docx 的压缩包结构:
import zipfile, shutil, re

shutil.copy(src, bak)          # 先备份
z = zipfile.ZipFile(src)
xml = z.read('word/document.xml').decode('utf-8')
xml = xml.replace('旧措辞', '新措辞')   # 文本层面替换
# 把修改后的 document.xml 写回,其余条目原样复制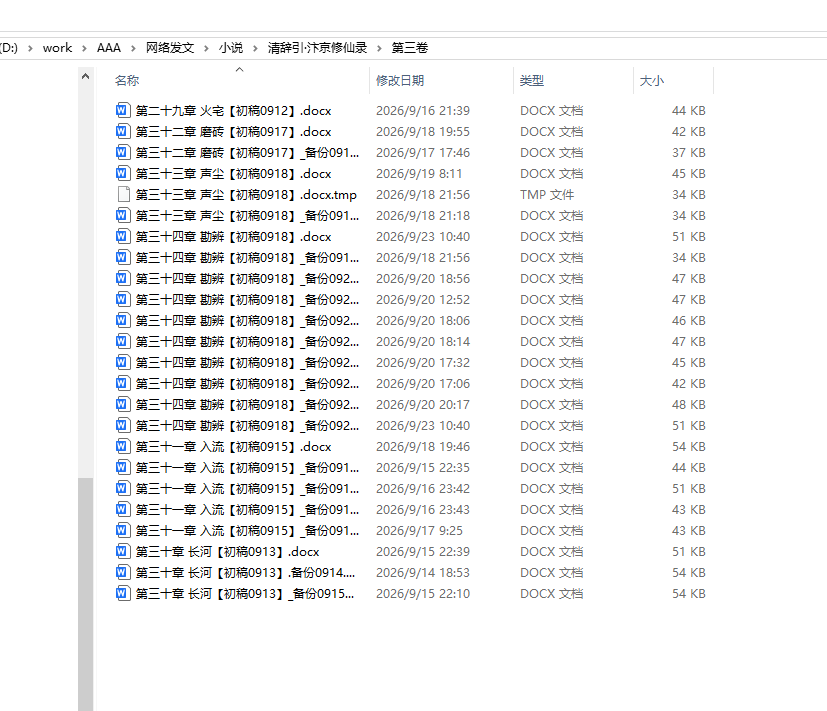
图3
[ 配图位 ] 图3:批量改稿的脚本目录——每一次改动都留一个带编号的脚本 图3_脚本目录.png
原理:.docx 本质是个 zip,正文在 word/document.xml。只换这一个文件、其余原样打包,格式一字节不动。 一次跑几十处替换,秒级完成。
配套建议:每次批量替换都写成一个带编号的脚本(
batch13_xxx.py),脚本本身就是改动记录。
四、让 AI 守规矩:把"纪律"写成律条文件
光有档案不够,还得有律条。我把写作纪律单独成文,比如:
- 在场律:某个人物不在场,就不许知道那件事,叙述者也不许补述;
- 不写追查律:主角不主动查案,只让事找上门;
- 静默律:某场打斗全程不出声,连拟声词都得是"骨头错位那一下的手感",不是人物喊出来的。
这些律条我分成两层存放:
- G 层(通用):换任何题材都成立;
- T 层(题材):只在这本书里成立。
分层判据只有一句话:把这条律里的全部专有名词抹掉,它还成立吗? 成立就是 G,不成立就是 T。
这样做的好处是:写完这本书,G 层可以整套搬到下一部去;而且 AI 不容易把题材的特殊规矩当成通用规矩乱用。
五、效果,和一句实话
实话:我这部小说目前在晋江的总点击是 249,收藏 9。冷启动阶段,数据不好看。
但我现在可以稳定地做到:隔一周再开工,AI 接上就能写,人物不走形,前后不打架。 这在四十万字的体量上,是以前不敢想的。
顺带一提,我真正依赖的其实是"人"的部分——拍板的是我,AI 负责不让我自己前后矛盾。 每一章能不能过,标准不是"写得好不好",是"有没有犯律"。
六、想抄这套方法的三条建议
- 别急着写正文,先花两天搭档案。 正文是消耗品,档案是资产。
- 每次讨论有结论,立刻落档。 别指望"下次还记得"——下次一定不记得。
- 备份比修改重要。 坏了能回去,就没什么是不可逆的。
最后一条最实在:AI 不会替你想清楚你要写什么,但它能保证你想清楚的东西不丢。
*(本文为 WorkBuddy 真实使用记录,工作流与脚本均在实际项目中运行。)*
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号