火了的 Jev,我替你们试了
原创
火了的 Jev,我替你们试了
原创
薛晓刚-
发布于 2026-09-22 10:05:15
发布于 2026-09-22 10:05:15
之前我让AI整理了一下这个工程概念脉络
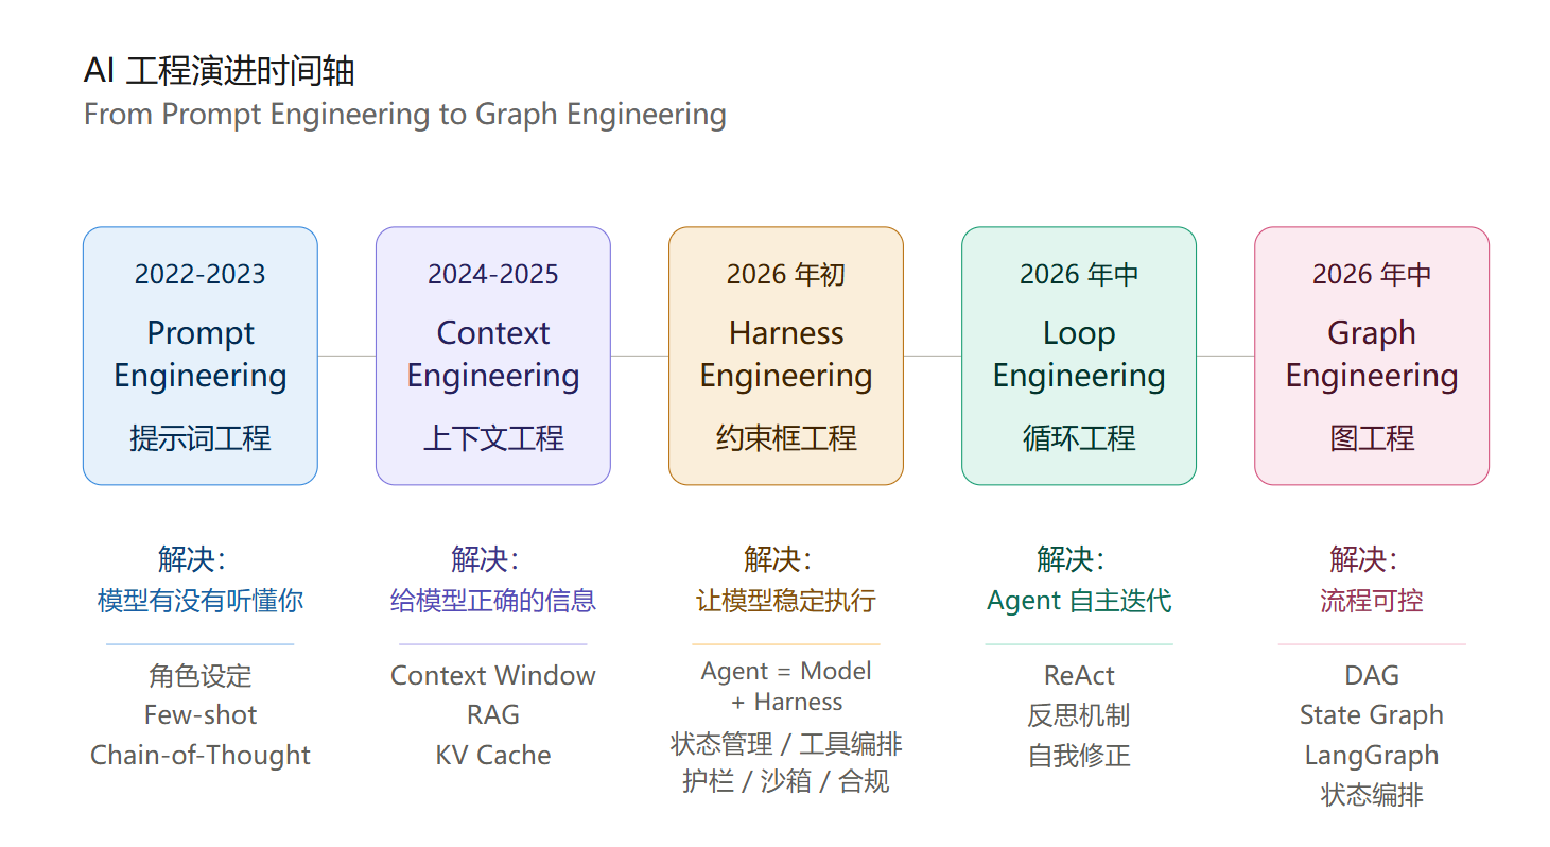
image.png
2026年中就出了两个。我8月时候就觉得9月可能还有。不出意外,上周就是出了一个新的。我也不知道叫概念还是叫框架。不管叫什么吧。它火了。
刚火起来的 Jev,这几天朋友圈、技术群都在刷。说它是"比 LLM 便宜几百倍、零幻觉、带置信度的决策模型"。
最近我顺手体验了一把,有些验证截图,都是这次试出来的结果。
今天不堆参数,就聊聊:它到底是什么、能干什么、干不了什么、怎么上手,以及——我最后让 agent 帮我把接口跑通了。
一、先说结论:Jev 不是"小一号的 LLM"
很多人一看到"AI 模型"就默认它是 ChatGPT 那一路:你问一句,它吐一段话。
Jev 不是。
它是 TypeSafe AI 发布的 System One Model(系统一模型)。一句话概括它的工作方式:
把一段非结构化文本(邮件、工单、评论、日志),变成一组"带概率的结构化决策"。
注意,是"决策",不是"文字"。它根本不生成句子。你问它"这条工单归哪个部门、客户有多急、要不要立刻处理",它返回一个带置信度的结构化结果,而不是一段分析。
这决定了它后面所有的优点和缺点。
二、原理:它凭什么又快又"不胡说"
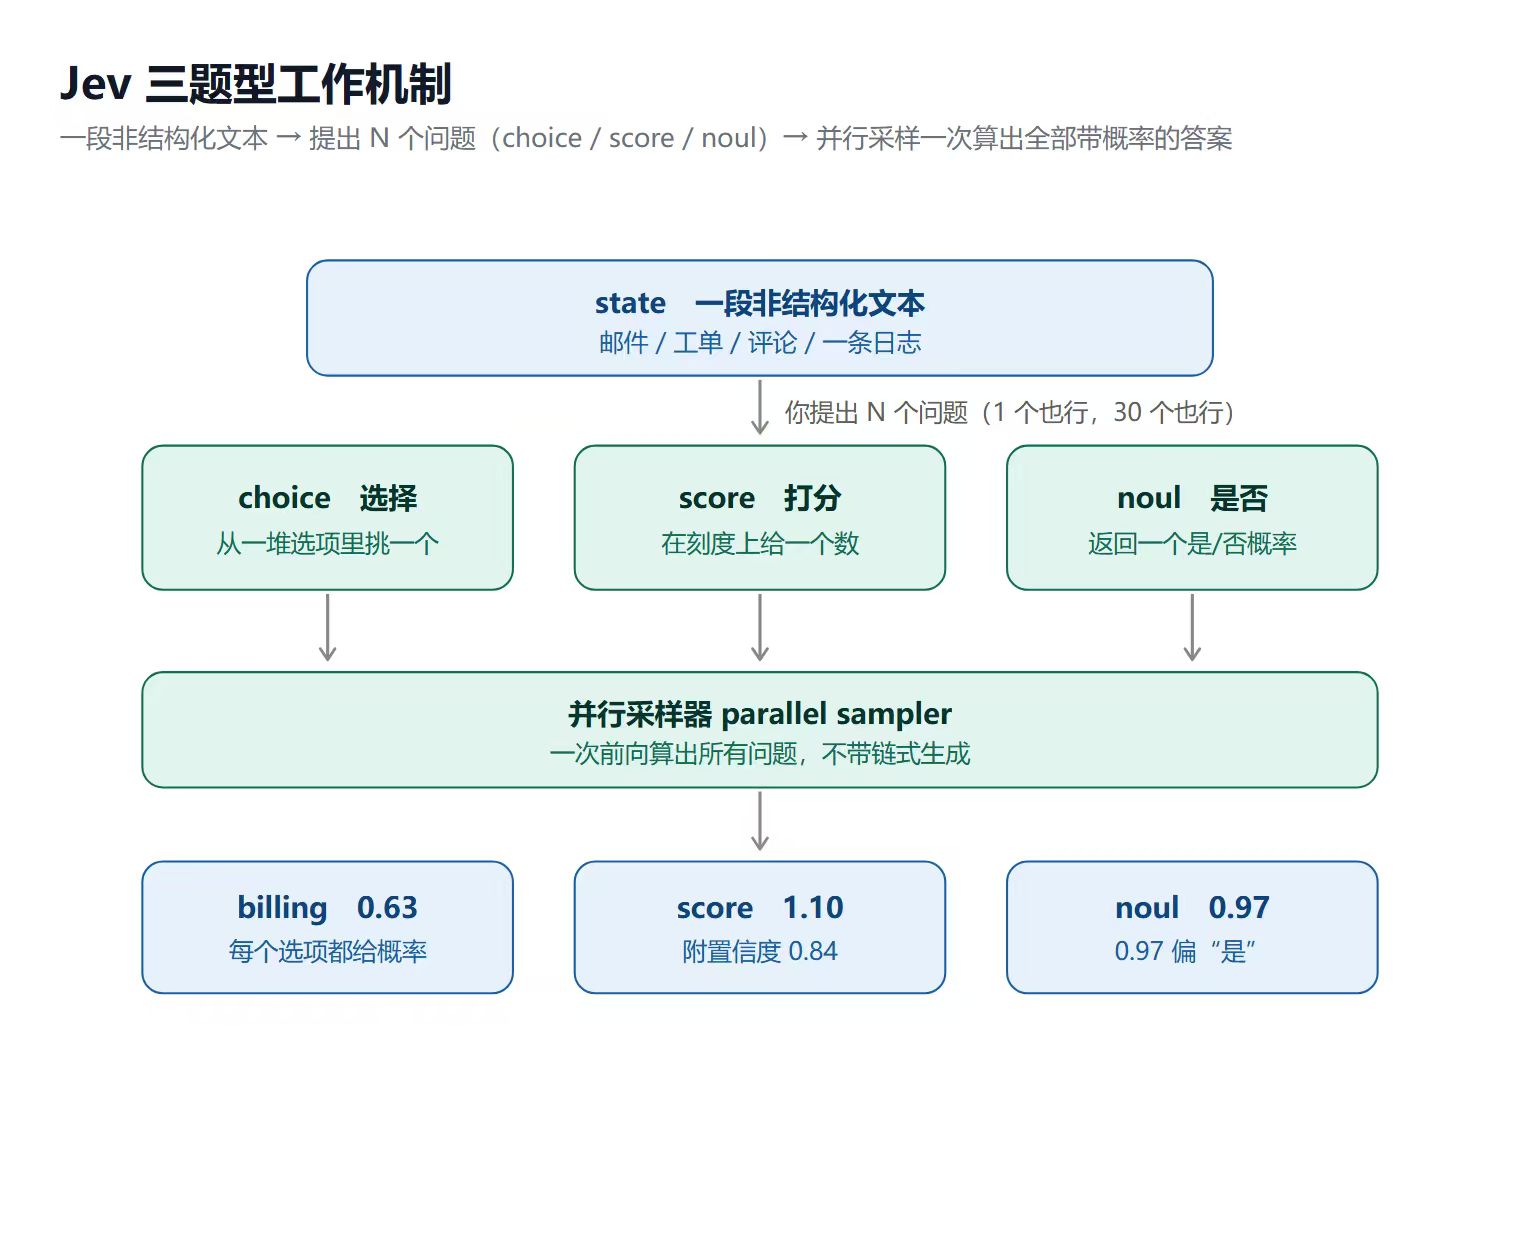
Jev 对外只暴露三种题型(question type),你提的每个问题必须从这三种里选一个:
- choice(选择):这件事归哪一类?用于路由、分类、打标签。
- score(打分):程度有多高?用于严重程度、紧急度、情绪分。
- noul(是否):这件事成立不成立?用于触发条件、是否违规、是否紧急。
为什么只给这三种?因为它从设计上就不输出"一段话",只能回答有固定形状的问题。这三种类型刚好覆盖了软件里"要做判断"的全部基本动作。
它快、它稳,根子在这三件事上:
1. 并行采样器(parallel sampler) 常规 LLM 是逐 token 串行生成,写一百个字就要跑一百步。Jev 一次前向传播,同时把 N 个问题全部算完。实测一次调用大概 1 秒左右,官方说最快能到 70ms。因为输出只是几个数值,不是成百上千 token,所以又快又便宜。
2. RLCD 训练法(Reinforcement Learning for Calibrated Decisions) 这是关键。它的训练目标不是"让人觉得回答得好",而是"概率要校准"——置信度高的时候,它真的更准。所以你拿到的那个 0.84 不是装饰,是校准过的。软件可以拿它当阈值:置信高自动执行,置信低转人工。
3. schema 约束类型 你定义的每个 question 的类型,直接决定了输出张量的结构和取值范围(choice 走 softmax 出概率分布,score 出连续值,noul 出 0~1 概率)。模型架构层面把"类型安全"焊死了,它不可能给你返回一个类型错误的结果。
三件事叠起来,换来三个核心收益:零幻觉(不生成文本,自然编不出东西)、概率可校准(能设阈值、能进自动化流水线)、快且便宜(输出几个数,不是一堆字)。
代价也很清楚:它牺牲了"写文章"的能力,换来了"做判断"的可靠、可控、便宜。
三、适用:它最适合"文本变决策"的流水线
从三种能力反推,Jev 最对味的是这一类任务——把一堆文本自动变成结构化决策,再喂给后面的系统:
- 工单 / 邮件分流:choice + noul。归哪个部门、是否紧急,直接路由。
- 内容审核:noul + score。是否违规、风险分多少,自动打标或转人工。
- 海量数据打标 / 筛选:choice(最多 255 个选项)+ score。十万条评论分类、质检,批处理很合适。
- 路由 / 拦截 LLM 输出:noul。检测 LLM 是否被越狱、输出是否安全,当一道闸门。
- 实时监控决策:任意题型。官方称 100ms 级延迟,适合嵌进业务链路里实时判。
e325e78f10ddb014d41ce5cca29c492f.jpg
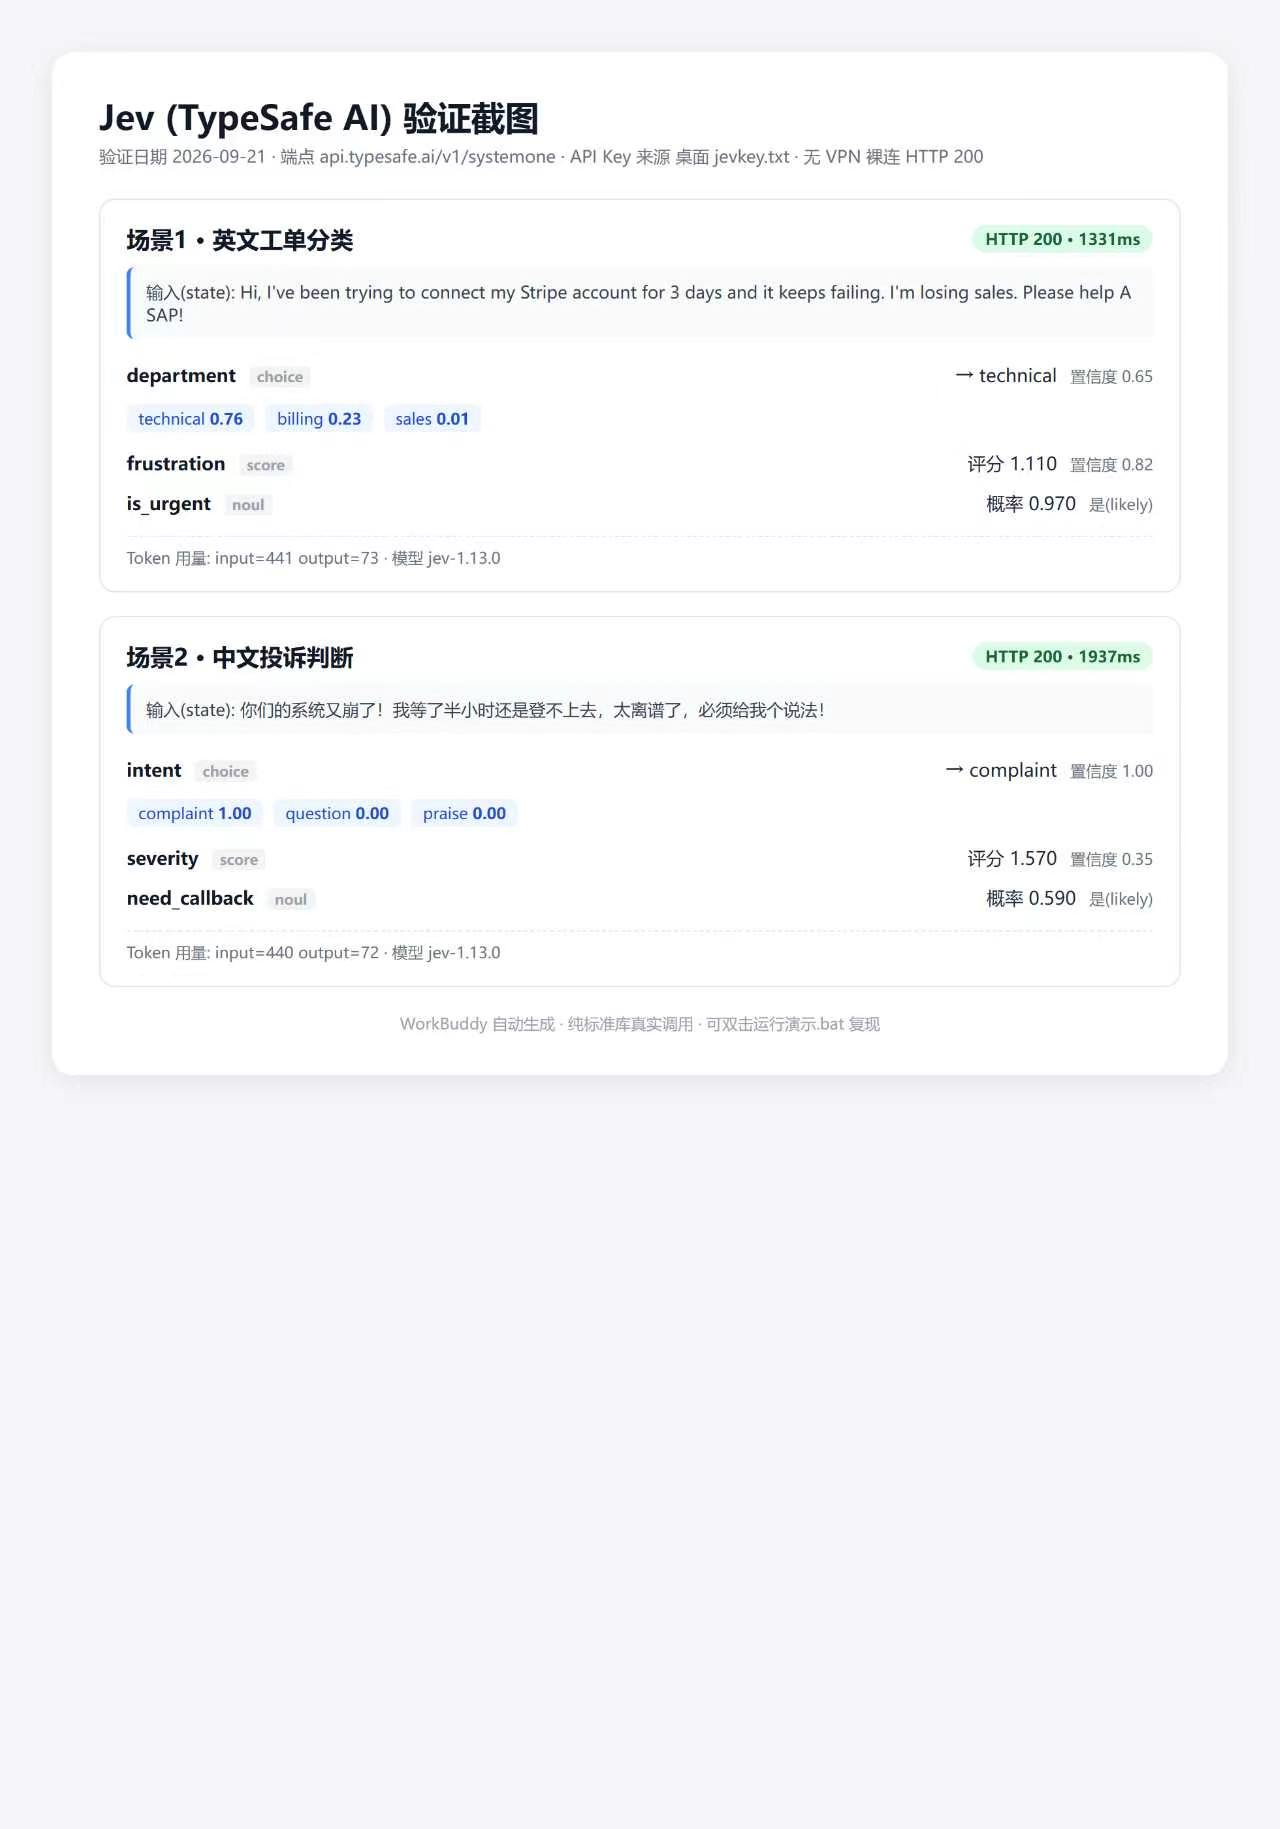
我让 agent 裸连它的 API(api.typesafe.ai/v1/systemone)跑了两个 case 验证:
- 英文工单"连了三天 Stripe 连不上、快流失客户了" →
department=technical(0.76)、is_urgent=0.97,HTTP 200,1.3 秒。 - 中文投诉"你们系统又崩了、等半小时登不上" →
intent=complaint(1.00)、severity=1.57,HTTP 200,1.9 秒。
aeec4b70c8dee6a90605b88aca3611a1.jpg
返回都是带概率的结构化 JSON,不废话,直接能用。这体验对传统企业那种"每天几万条工单要分"的场景,比养一个 LLM 吐完再解析稳得多。
四、不适用:它的边界,得说清楚
每种技术都有优劣,Jev 不是银弹。下面这些它干不了,或者干起来不划算:
- 写文案、翻译、代码生成、对话机器人:它不生成文本,这些必须配 LLM 来做。Jev 自己干不了。
- 需要"思考过程"的复杂推理:它只给结论和概率,不给推导。你要的是"为什么",它给不了。
- 题型被焊死:你只能问 choice / score / noul 三种。我实测传第四个类型(比如想让它写摘要
type:"text"),直接 HTTP 400 被拒;questions 留空,HTTP 422 被拒。想自由发挥?没门。 - 选项也有上限:choice 最多 255 个选项(实测 300 报错),超了得自己拆。
- 它不是"更聪明的模型",是"更专一的模型":独立技术分析指出,Jev 本质是 MoE 主干 + 并行读出(Medusa)+ KV Cache 共享(vLLM)+ listwise 评分头 + Brier 奖励 RL 的工程组合,不是单一新技术突破。这点不丢人,但别神话它。
说白了:要"创作"找 LLM,要"判断"找 Jev。把它当 LLM 用,是找错工具;把它接在 LLM 后面当"质量闸门"或"分类器",才是正解。
五、怎么上手:注册很简单,剩下的交给 agent
注册这块很简单,几步:
- 登录官网;
- 输入你自己的邮箱,收验证邮件、完成验证;
- 拿到 API Key。
就这三步。我这次的 key 就是这么来的。
拿到 key 之后,我没有直接上手写调用代码——而是让 agent 去实现了。把端点、key、两个测试用例丢给 agent,它直接裸连 HTTP 把上面那两组数据跑出来了,全程没让我碰一行代码。
这也是 Jev 这类"决策模型"最舒服的地方:接口极简、输出极规整,特别适合交给 agent 去编排、去嵌进现有系统,人只管定义"要问哪几个问题"。
六、写在最后
技术圈每隔一阵就出一个"颠覆 LLM"的新东西。Jev 不是那个颠覆者,但它是个实在的好工具。
它的价值不在"比大模型更聪明",而在"把判断这件事做得更可靠、更便宜、更可控"。零幻觉、带置信、能进流水线——这三个特性,对传统企业那些海量、重复、要可审计的决策场景,比"能侃大山"的 LLM 值钱得多。
但记住:每种技术都有他的优劣。Jev 放弃了生成,换来了判断;别拿它写方案,也别指望它替你想清楚业务逻辑。给它完整的信息、定义清楚的问题,它才还你一个靠得住的答案。
但是你要说这个怎么落地,实话实话我不知道。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号