机房温湿度数据上云:以太网温湿度记录仪通过腾讯云 CKafka 实现异步解耦
原创
机房温湿度数据上云:以太网温湿度记录仪通过腾讯云 CKafka 实现异步解耦
原创
BJ盛世宏博小程
发布于 2026-09-21 16:51:28
发布于 2026-09-21 16:51:28
机房温湿度数据上云:以太网温湿度记录仪通过腾讯云 CKafka 实现异步解耦
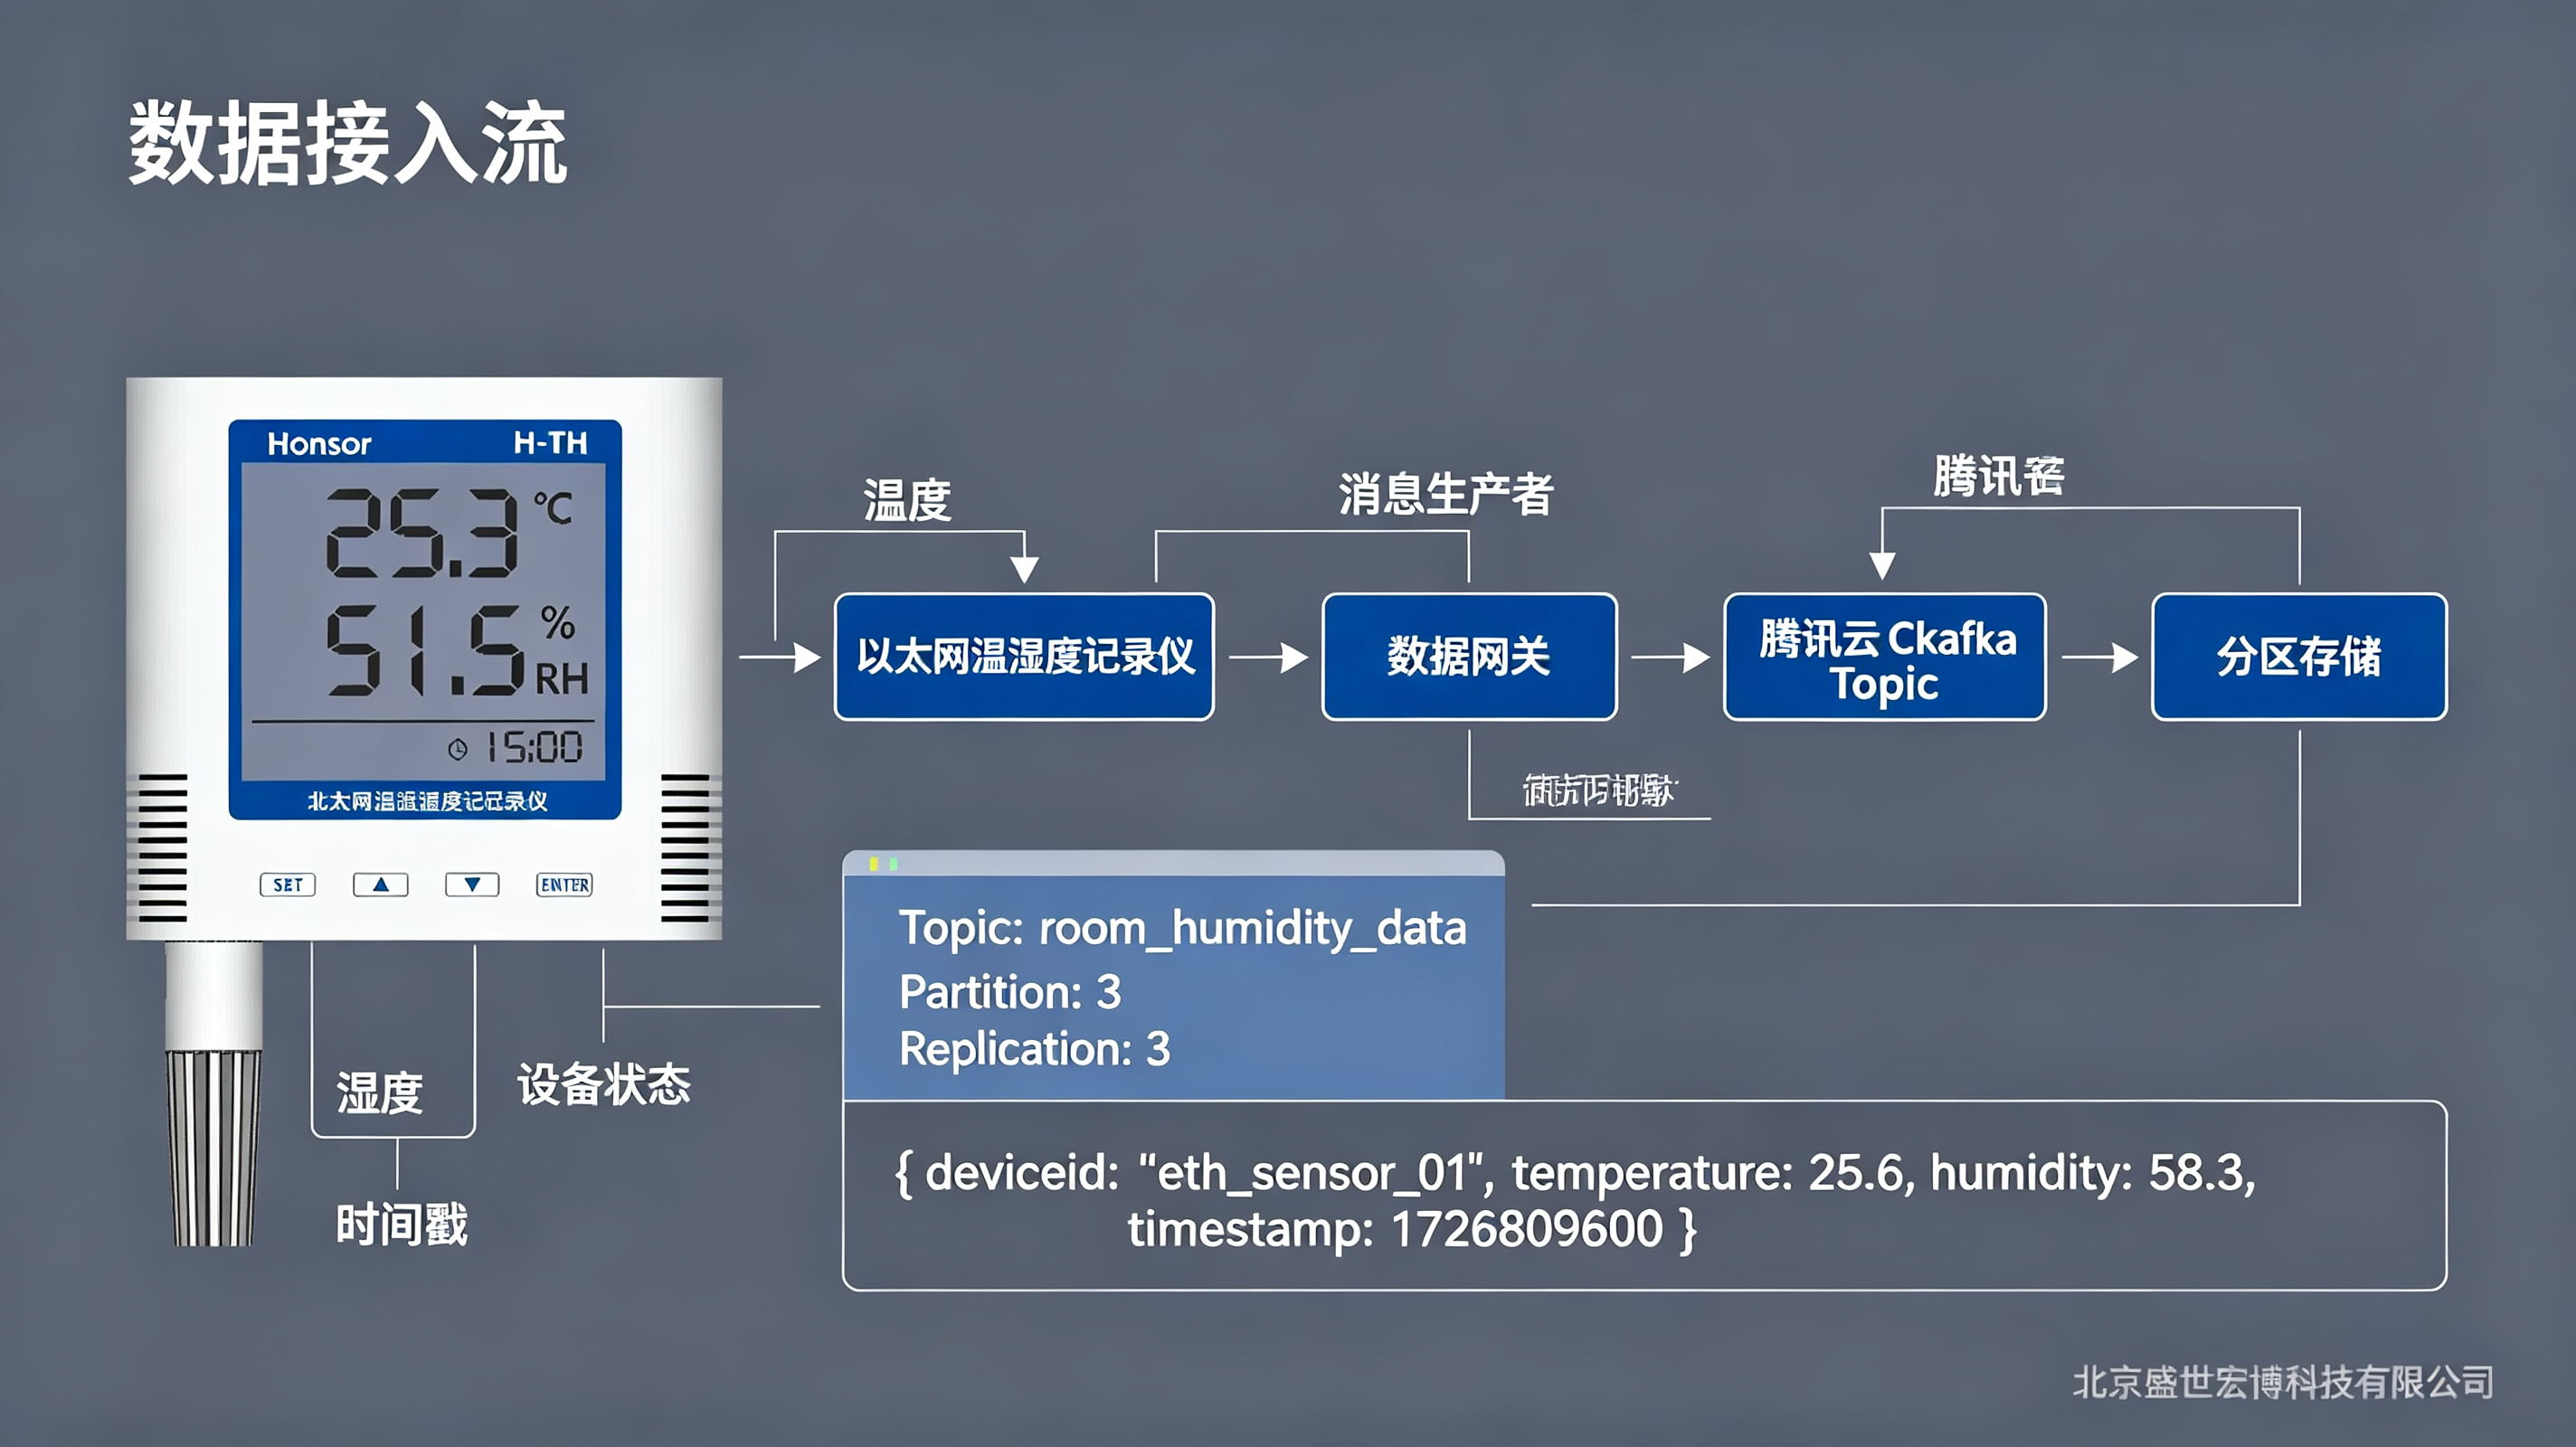
前面几篇已经把设备接入、控制链路、CTSDB 高频写入和 TCP 保活讲透了。这一篇把视角拉到平台集成层。
这里要先澄清一个常见误解:
普通以太网温湿度记录仪通常只能做 Modbus TCP 从站,它不会直接连接 Kafka。所谓“记录仪上 CKafka”,实际链路是: 记录仪 → 边缘网关/采集服务 → IoT Explorer 或 CKafka → 下游消费者
CKafka 只负责消息异步解耦和削峰,不承担设备身份认证、物模型、控制指令和持久存储。设备能不能长期稳定接入,仍取决于网关的 TCP 保活和 Modbus 轮询策略。
一、为什么需要 CKafka 这一层
假设有 20 台记录仪,每台 10 秒上报一次:
- 单日原始数据:约 17.3 万条
- 若再接入恒湿净化一体机,风机、压缩机、UVC 剂量、滤网压差等高频指标,写入量会翻几倍
- 告警、大屏、CTSDB、审计、企业微信通知可能同时消费这些数据
如果没有消息队列,常见的问题是:
- 数据库抖动直接拖垮采集网关
- 告警服务和存储服务互相阻塞
- 消费方扩容时,必须修改网关配置
- 某段时间断网补传,瞬间冲击数据库
- 数据已经持久化,但审计链和告警状态无法追溯
引入 CKafka 后,系统可以拆成三段:
采集侧:Modbus TCP → JSON → 生产消息
消息侧:CKafka 缓存、削峰、多消费者订阅
消费侧:CTSDB、规则引擎、告警、审计各自消费
价值不是“性能更高”这么简单,而是:
记录仪只负责稳定采集,数据库只负责高效写入,告警系统只负责业务判断,三者不再互相阻塞。
二、推荐的接入架构
方案 A:记录仪 → IoT Explorer → CKafka
适合腾讯云体系内、希望保留设备身份和物模型的场景。
以太网温湿度记录仪(Modbus TCP)
                │
                ▼
Modbus 网关 / 边缘服务
                │ MQTT / 物模型属性上报
                ▼
  腾讯云 IoT Explorer
                │ 规则引擎
                ▼
         消息队列 CKafka
                │
   ┌────────────┼────────────┐
   ▼            ▼            ▼
 CTSDB      告警服务      审计/分析
IoT Explorer 可以将符合条件的设备上报数据转发到 CKafka,应用服务再从 Topic 中读取数据。这种方式可以同时保留设备身份、产品模型和规则过滤能力。
IoT Explorer 规则引擎会把设备上报消息实时转发到云产品;如果希望保存超过 3 天的设备数据,官方建议通过规则引擎转发到 CKafka、数据库或其他存储。
规则转发失败时,系统会按 1 秒、3 秒、10 秒间隔重试;三次仍失败,则根据错误转发动作继续处理或直接丢弃。因此,CKafka 能缓冲突发流量,但不能替代端到端的失败补偿机制。
方案 B:网关直接写 CKafka
适合以下情况:
- 已有成熟的边缘网关
- 数据量很大
- 不需要使用腾讯连连、设备影子
- 主要目标是高并发数据管道
记录仪
   │ Modbus TCP
   ▼
采集网关
   │ Kafka Producer
   ▼
CKafka
   │
   ├─ CTSDB Sink
   ├─ Flink / SCF 规则计算
   └─ 告警消费者
这种架构链路更短,但设备身份、消息格式、鉴权、离线缓存和 Schema 都需要自己设计。
方案 C:边缘先缓存,断网后批量回放
适合库房、弱电间等弱网场景:
记录仪
   │
   ▼
边缘网关
 ├─ 实时生产到 CKafka
 ├─ 网络异常时写入本地 SQLite/WAL
 └─ 网络恢复后,按设备采样时间补传
                │
                ▼
            CKafka
这里尤其要区分:
produce_time:消息进入 Kafka 的时间sample_time:记录仪实际采样时间edge_store_time:边缘网关本地保存时间
审计和降采样必须始终使用 sample_time,否则补传数据会破坏时间轴。
三、Topic 和消息模型怎么划分
不要把所有数据都写入一个 Topic。
1. 按业务划分 Topic
Topic | 内容 | 保留期 | 分区策略 |
|---|---|---|---|
env_raw_telemetry | 温湿度、PM2.5 等原始遥测 | 3~7 天 | device_id % N |
env_device_event | 离线、故障、传感器异常 | 30~90 天 | site_id |
env_control_result | 一体机控制指令及回执 | 90~365 天 | ahu_id |
env_audit_trail | 人员操作、阈值修改、权限变更 | 3~10 年 | tenant_id |
env_dlq | 格式错误、Schema 校验失败 | 30 天 | topic |
事件、控制回执和审计数据不建议降采样,必须原样保存。
2. 推荐的消息结构
{
  "message_id": "msg-3f9c1a8b-20260920-000123",
  "device_id": "TH-A3-01",
  "site_id": "site-tianjin-001",
  "room_id": "archive-3f-a3",
  "product_id": "prod-env-recorder",
  "sample_time": "2026-09-20T10:30:00+08:00",
  "receive_time": "2026-09-20T10:30:00.214+08:00",
  "edge_id": "edge-3f-01",
  "schema_version": "1.2",
  "qos": 1,
  "metrics": {
    "temperature": 22.4,
    "humidity": 55.8,
    "pm25": 12,
    "pm10": 24,
    "quality": "good"
  },
  "source": {
    "protocol": "modbus_tcp",
    "slave_id": 1,
    "address": "192.168.10.21:502"
  },
  "trace": {
    "is_backfill": false,
    "backfill_batch": null
  }
}
需要特别注意的是:
message_id必须具备幂等性,最好同时包含时间、设备和序号schema_version用于兼容后续字段变化quality必须随数据一起进入消息队列,避免坏数据进入 CTSDBis_backfill用于区分实时数据和补传数据,审计时必须分开处理
四、IoT Explorer 规则引擎配置
规则引擎不能只写 SELECT *,否则控制回包、事件消息和属性消息可能混在一起。
建议按物模型 Topic 和字段过滤:
SELECT
  deviceid() AS device_id,
  productid() AS product_id,
  get_from_json(params, 'temperature') AS temperature,
  get_from_json(params, 'humidity') AS humidity,
  get_from_json(params, 'pm25') AS pm25,
  get_from_json(params, 'quality') AS quality
FROM
  "$thing/up/property/{{ProductID}}/+"
WHERE
  productid() = 'prod-env-recorder'
  AND get_from_json(params, 'quality') IN ('good', 'doubtful')
转发动作选择:
- 数据转发到 CKafka
- 选择同一地域的 CKafka 实例
- 指定
env_raw_telemetry - 初次使用时需要授权访问 CKafka
CKafka 转发属于异步链路。即使 IoT Explorer 已经显示“转发成功”,也只代表消息进入 CKafka,不代表 CTSDB 已经成功写入。故障定位必须同时检查:
- 网关日志
- IoT Explorer 规则日志
- CKafka 生产指标
- 消费者 Lag
- CTSDB Sink 错误日志
五、网关侧的异步生产策略
1. 使用本地消息队列
不要在 Modbus 轮询线程中直接同步发送 Kafka 消息。建议:
Modbus 轮询线程
      │ 取出数据
      ▼
Disruptor / BlockingQueue
      │
      ▼
Kafka Producer 批量发送
这样可以避免:
- Kafka 瞬时抖动阻塞 Modbus 轮询
- 单条消息发送失败拖慢整体采集
- 网络超时被放大成设备离线
2. 必须设置的关键参数
acks=1
retries=3
retry.backoff.ms=100
linger.ms=20
batch.size=65536
buffer.memory=67108864
max.in.flight.requests.per.connection=5
enable.idempotence=true
compression.type=lz4
delivery.timeout.ms=30000
request.timeout.ms=15000
要点是:
acks=all会提高可靠性,但也会增加延迟- 批量发送要设置上限,否则断电时容易丢缓存数据
enable.idempotence=true可防止网络重试造成重复写入- 生产者缓冲区不是永久存储,超过
delivery.timeout.ms的消息仍然可能丢失
3. 失败兜底
生产成功 → 继续
生产失败(可重试) → 本地重试
连续失败 → 写入本地 WAL
网络恢复 → 按 sample_time 升序回放
超过最大重试次数 → 进入 DLQ,不阻塞主流程
这里的关键不是“永不丢数据”,而是:
保证时间顺序,保证可重放,保证失败可见,避免一条坏消息堵住整个 Topic。
六、消费者怎么设计
1. 消费组分工
不要用一个消费者组包办所有业务。
消费组 | Topic | 职责 |
|---|---|---|
ctsdb-sink | env_raw_telemetry | 写入原始时序数据 |
alert-engine | env_raw_telemetry | 越限、连续异常判断 |
device-state | env_device_event | 在线状态、故障统计 |
audit-writer | env_audit_trail | 操作审计归档 |
不同业务可以使用不同的 group.id,实现真正的异步解耦。
2. 偏移量提交
自动提交:间隔太长 → 重复消费
自动提交:间隔太短 → 可能丢失
建议采用:
业务处理成功 → 手动提交 offset
业务失败 → 不提交
重试 N 次 → 转入死信队列
CKafka 虽然支持 Kafka 协议和客户端 SDK,但消息“至少一次”并不等于业务“只处理一次”。CTSDB Sink 和消费服务必须具备幂等写入能力。
3. CTSDB Sink 幂等示例
INSERT INTO env_room_metric
SELECT
  sample_time,
  site_id,
  room_id,
  device_id,
  temperature,
  humidity,
  pm25
FROM
  kafka_source
WHERE
  quality = 'good'
  AND sample_time > now() - interval '1 day'
ON CONFLICT (sample_time, device_id)
DO UPDATE SET
  temperature = EXCLUDED.temperature,
  humidity = EXCLUDED.humidity,
  pm25 = EXCLUDED.pm25;
message_id 或 sample_time + device_id 可以作为天然幂等键。
七、反压与容量控制
CKafka 可以缓冲突发数据,但不能无限缓存。
1. 监控告警指标
指标 | 建议阈值 | 动作 |
|---|---|---|
生产失败率 | > 1% 持续 5 分钟 | 检查 ACL、网络、实例规格 |
消费 Lag | > 10 万条 | 扩容消费者 |
最大滞后时间 | > 5 分钟 | 告警并检查 Sink |
磁盘使用率 | > 70% | 扩容或缩短保留期 |
请求超时率 | > 0.5% | 检查客户端和路由 |
DLQ 增长速率 | > 100 条/分钟 | 检查消息 Schema |
2. 背压策略
- CKafka 接近磁盘上限:临时缩短原始遥测保留期
- 消费者 Lag 持续增长:先扩容消费者,而不是提高单条消息处理能力
- 断网补传量过大:降低回放速度,并给实时数据单独设置高优先级
- 审计 Topic 不允许降采样或自动清理
八、控制指令为什么不能走 CKafka
这里是一个重要边界。
CKafka 适合:
- 设备遥测
- 环境事件
- 日志
- 审计记录
- 异步报表
不适合直接承担:
- 实时除湿控制
- 一体机模式切换
- 立即消毒指令
- 设备级同步控制
原因:
- Kafka 有消费延迟
- 消息可能重复
- 不保证固定端到端时延
- 无法确认设备当前在线状态
正确方式应是:
控制服务
   │
   ▼ 同步调用 IoT Explorer / MQTT / 设备影子
记录仪或一体机
   │
   ▼ 执行结果上报
CKafka → 审计消费者
IoT Explorer 的规则引擎支持将消息转发到 CKafka,同时也提供物模型、设备管理和消息通信能力;控制链路仍应使用其设备通信能力,而不是反向依赖消息队列。
九、CKafka 安全接入
CKafka 支持 Kafka 协议兼容,并可通过 SASL 或 SASL_SSL 进行身份认证和传输加密。
典型 SASL_SSL 客户端配置:
bootstrap.servers=ckafka-xxxx.tencentcloudmq.com:9093
security.protocol=SASL_SSL
sasl.mechanism=PLAIN
sasl.jaas.config=org.apache.kafka.common.security.plain.PlainLoginModule required \
  username="ckafka-xxxx#env_producer" \
  password="********";
ssl.endpoint.identification.algorithm=
不同接入方式的特点:
PLAINTEXT:性能最好,但明文传输,仅适合受控 VPCSASL_PLAINTEXT:有身份认证,但数据不加密SASL_SSL:身份认证和传输加密,更适合审计、控制结果等敏感数据
还应配置:
- 独立的生产者和消费者账户
- Topic 级 ACL
- 消费者组白名单
- 生产/消费流量配额
- 公网域名接入、用户名、密码、证书路径和鉴权机制
公网 SASL 接入时,CKafka 使用 SASL_PLAINTEXT 或 SASL_SSL 的接入域名,用户名和密码需要与 ACL 中的角色及 Topic 权限匹配。
十、验收清单
建议从以下项目验收,而不只是检查“Topic 里有没有数据”:
- [ ] 20 台记录仪同时上报,Kafka 无生产失败
- [ ] 单台设备故障后,不影响其他设备
- [ ] 断网 4 小时后补传,Consumer Lag 能在 15 分钟内追平
- [ ] 补传数据使用原始采样时间,没有被当成实时数据
- [ ] 同一
message_id重复消费,CTSDB 不出现重复行 - [ ] CKafka 转发失败时,IoT Explorer 规则日志有记录
- [ ] 消费者异常重启,不丢失已处理进度
- [ ]
quality=invalid数据不能进入 CTSDB - [ ] 告警消费者和控制链路相互独立
- [ ] ACL 账户只能访问指定 Topic
- [ ] DLQ 中的消息可以回放并重新处理
- [ ] 审计 Topic 满足合同规定的保存年限
十一、一句话复盘
以太网温湿度记录仪“上 CKafka”,本质上不是让设备直接连接 Kafka,而是:
边缘网关完成 Modbus TCP 采集、质量位过滤和断网缓存;IoT Explorer 负责设备身份与物模型;CKafka 负责异步解耦和削峰;下游消费者再分别承担时序存储、告警、规则和审计。
真正成熟的架构要做到:
- 记录仪不依赖云
- 网关不依赖数据库
- 告警不依赖大屏
- 审计不依赖实时链路
当网络中断 4 小时,边缘网关继续采集,Kafka 侧不会崩溃,恢复后数据按原始采样时间重新进入 CTSDB 和审计链——这才是 CKafka 异步解耦的价值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号