AI能力不是瓶颈!上下文管理带来2-3倍吞吐提升

AI能力不是瓶颈!上下文管理带来2-3倍吞吐提升

乔梁-北京
发布于 2026-09-16 21:35:45
发布于 2026-09-16 21:35:45
AI 的能力不是瓶颈,上下文管理才是
AI 的能力不是瓶颈,上下文管理才是。
这句话来自一个在真实代码库中跑出 2 到 3 倍吞吐量提升的团队。他们没有换模型、没有堆算力,只做了一件事:把上下文压缩变成系统化的工程实践,用一套研究-计划-实施(RPI)流程,管理 AI 每次工作前『看到什么、记得什么』。
模型的能力早就过剩了,真正决定 AI 产出上限的,是你给它看什么、怎么给。
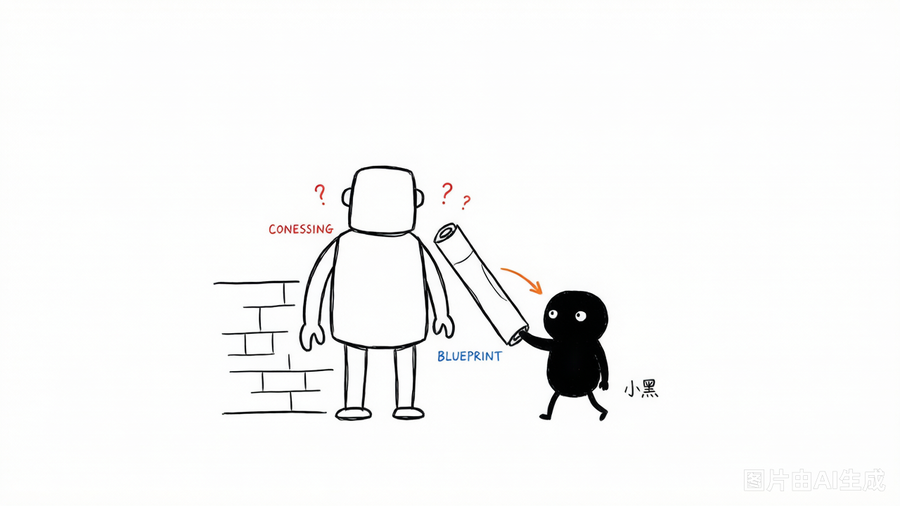
上下文就是给AI的图纸
1 01 上下文,是 AI 的工作台
想象一个顶级工程师被请到你的工地上,但你没有给他图纸,只给了他一句『把楼盖好』。他只能靠猜。猜对了是运气,猜错了是灾难。
AI 就是那个工程师。上下文就是它上工前的图纸——代码库结构、相关文件、历史决策、验收标准。图纸给得越准,它干得越快;图纸给得含糊,它就开始编。
大多数团队的 AI 效率上不去,不是模型不行,是上下文没管理:要么什么都不给,让 AI 在十万行代码里裸奔;要么什么都给,把整个仓库塞进上下文,让模型在噪音里找信号。
RPI 流程要解决的,正是这两个极端之间的路。
2 02 研究:先派侦察兵,带回真相快照
RPI 的第一步是研究(Research),但这里的『研究』不是人肉读代码,而是让子代理去探索代码库。
你的主 AI 不用亲自翻遍每个文件——那会烧光上下文。而是派一个子代理(侦察兵)去代码库里转一圈,只带回一样东西:简洁的真相快照。
快照里有什么?相关文件在哪、现有实现长什么样、改动会碰到哪些依赖、哪里有坑。全是结论,没有过程。
这一步的精髓是:把『找』和『做』分开。找的人(子代理)负责把世界压缩成一张图,做的人(主 AI)只负责看图干活。上下文不再用来装『探索过程的垃圾』,只用来装『探索得到的结论』。
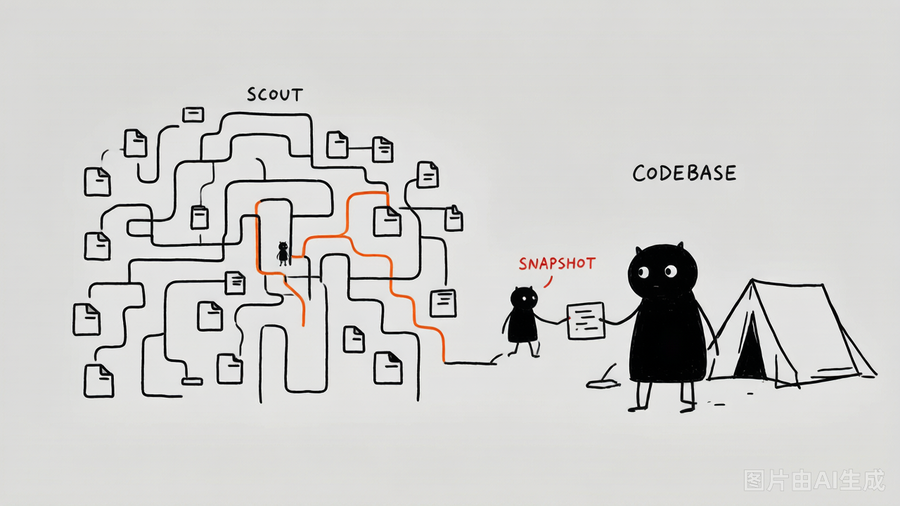
侦察兵带回真相快照
3 03 计划:写到『最愚蠢的模型』也能执行
第二步是计划(Plan),要求苛刻到有点反直觉:计划里要包含具体步骤和代码片段,让『最愚蠢的模型』也能照着执行。
为什么要以『最愚蠢的模型』为标准?
因为计划越具体,执行越不用动脑,AI 的自由发挥空间就越小,出错的可能就越小。每一步改哪个文件、加什么函数、返回什么值,全部写死。AI 的角色从『思考者』降级为『执行者』——这正是计划的目的。
反过来,计划写得含糊(『优化一下性能』这种),AI 就只能边干边猜,每猜一次就偏离一分,最后产出一个看似合理、实则跑不通的东西。
写计划这件事本身,也是人的思考在提前发生:你在动笔之前,已经把问题想透了。这为最后一步埋下了伏笔。
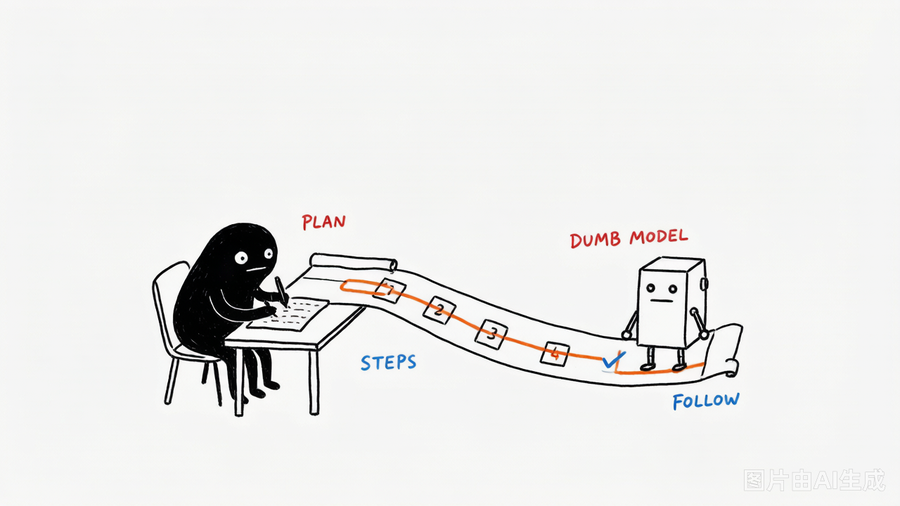
计划写到最笨的模型也能执行
4 04 实施:按计划执行,减少干扰
第三步是实施(Implement),听起来最没技术含量,其实最容易翻车。
按计划执行,意味着不要在中途加戏:执行到一半,发现可以顺手优化一下这里、重构一下那里——停。那不是计划里的内容。
AI 每偏离计划一步,就多一分不可控;每多一次『我觉得』,就离上下文里的共识远一步。减少干扰,就是减少 AI 的『自由意志』:只做计划里的事,做完就停,等下一轮计划。
这也让结果变得可预期:出错了,回到计划找问题,而不是在 AI 的即兴发挥里找原因。
5 05 心理校准:用计划代替代码审查
第四步最有意思:心理校准(Mental Calibration),核心是用计划代替代码审查,保持团队对齐。
传统流程里,代码审查是在事后兜底:写完再检查,发现问题再返工。RPI 的思路是反过来的——问题应该在计划阶段就被消灭,而不是等到代码写完再抓。
Uncle Bob(敏捷和 TDD 的拥护者)也持类似观点:只要前期准备做到位,就不需要做 code review。
计划写得足够具体,等于把审查前置到了动笔之前;团队在计划上对齐,比在成品上对齐便宜得多。
审查的对象从『代码』变成了『计划』:计划对了,执行只要不出格,结果就差不到哪去。团队对齐的锚点,也从『事后补救』变成了『事前共识』。
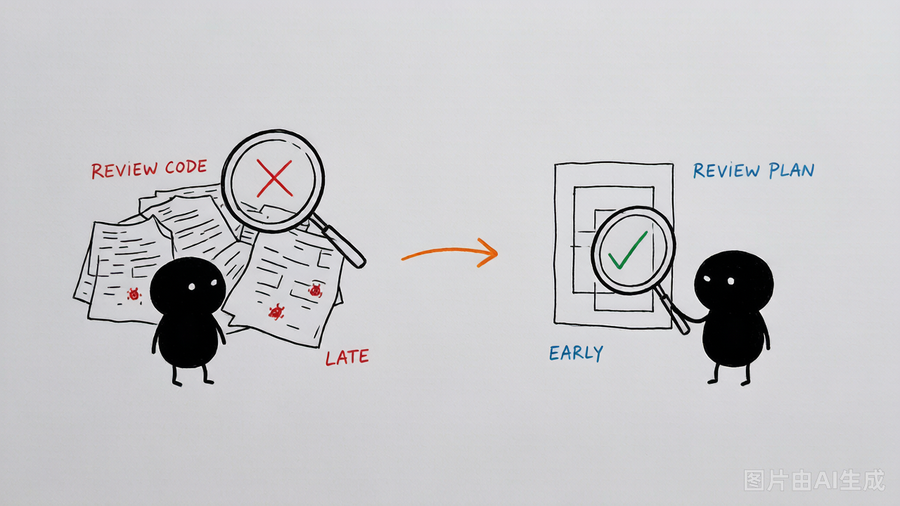
审查计划而不是代码
6 写在最后
RPI 四步——研究、计划、实施、心理校准——本质上是同一个动作:把思考提前,把执行推后。
研究把『找』变成结论,计划把『想』变成文字,实施把『做』变成照做,校准把『审』变成对齐。AI 从头到尾都只是一个执行者,思考的重担始终在人这边。
最值得记住的一句话:不要把思考工作外包出去。AI 不会替你思考,它只会放大你已经做的思考——或者你没有做的思考。
你们团队的 AI 工作流,现在卡在『研究』还是『计划』上?欢迎留言聊聊,我会挑有代表性的案例展开。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-19,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号