麻了,问一句'你好'它想了3分钟?关掉这个过度思考,AI速度直接翻5倍

麻了,问一句'你好'它想了3分钟?关掉这个过度思考,AI速度直接翻5倍
小机学AI智能体
发布于 2026-09-16 20:43:45
发布于 2026-09-16 20:43:45
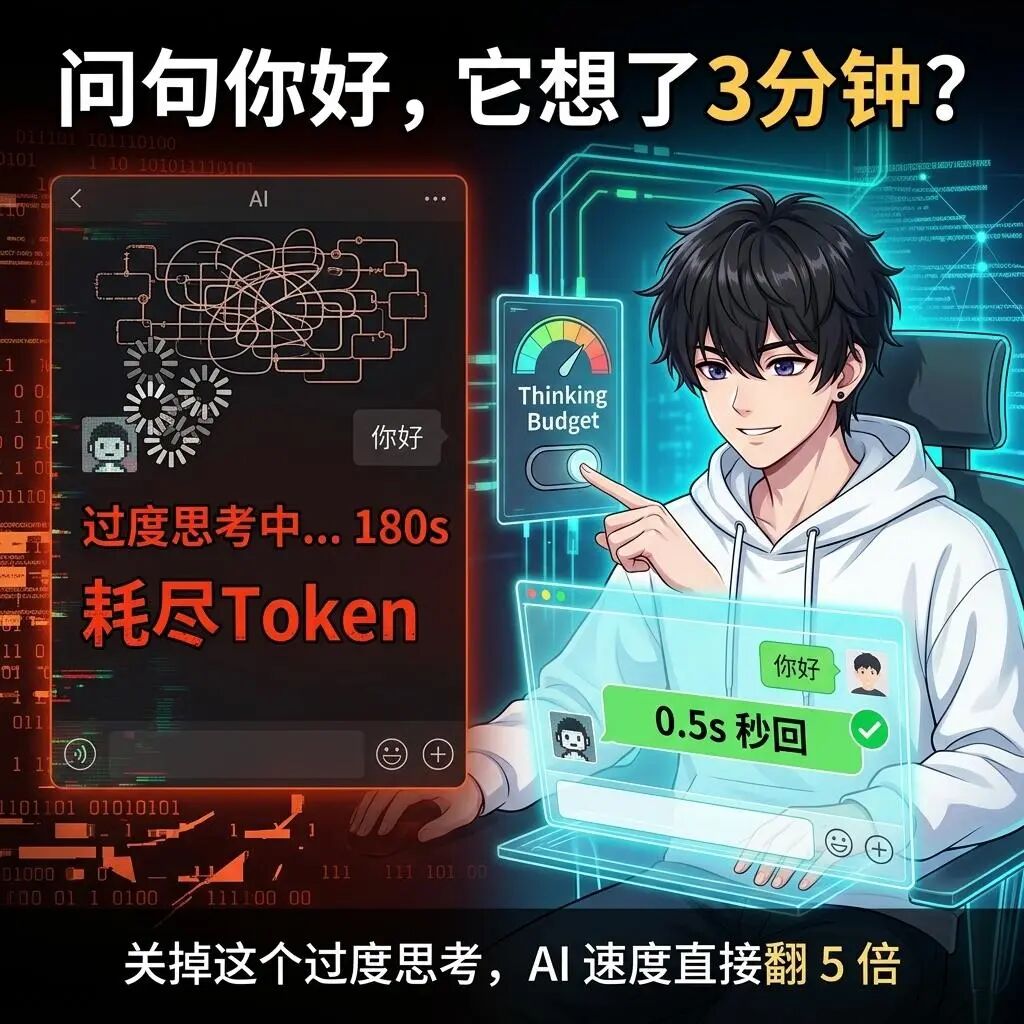
问一句你好它想了3分钟封面图
社群里有个人最近找我吐槽。
说他用现在的推理大模型,问点简单的事儿,都要等到地老天荒。
最崩溃的一次:
他问 AI:今天深圳要不要带伞?
然后他去倒了杯水,回来坐下,拿起手机一看。
AI 还在转圈。
足足等了三分钟,AI 终于开口。
吐出来两行字:深圳今天多云,不需要带伞。
一脸懵逼 的图像结果
你以为我说的是笑话。
但这是技术博主 Simon Willison 实测新版开源大模型 Qwen 3.8 27B 时,专门记录并吐槽的真实现象:
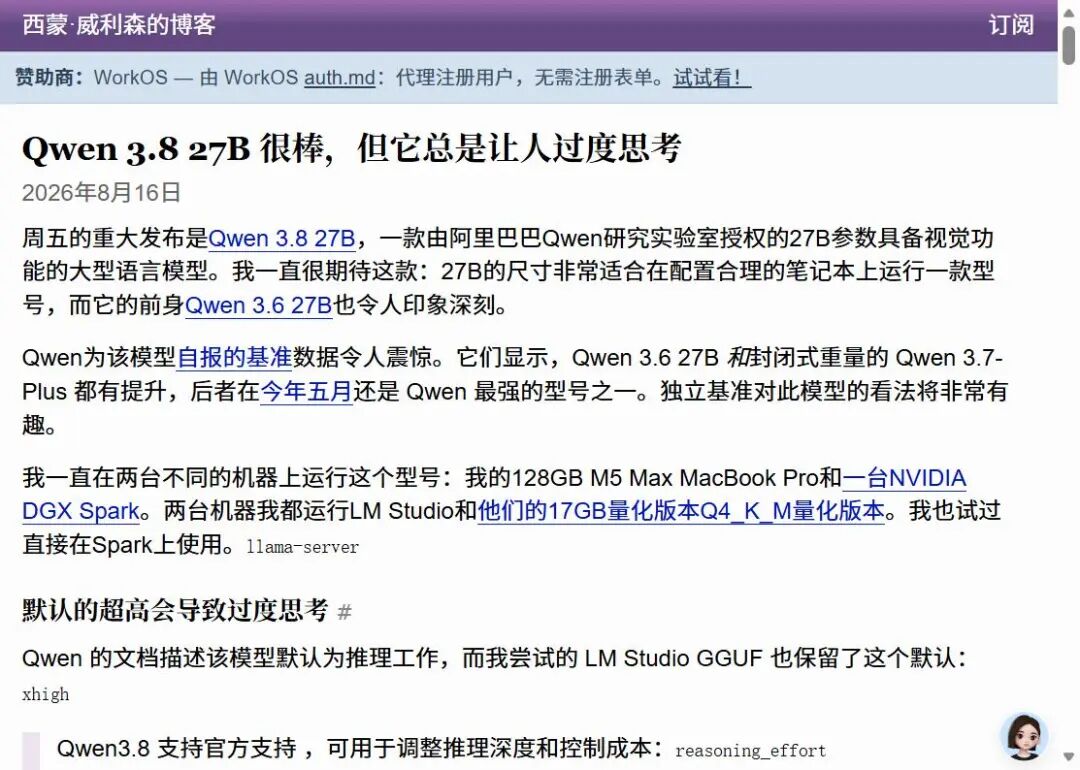
Qwen3.8过度思考实测报道截图
为什么越来越多的 AI 开始疯狂加戏?
现在大部分推理模型出厂的时候,默认就把思考算力拉到了最高档。
你让它攻克高难度逻辑题,这当然是福音。
但你只是让它帮你改个标题、翻译两行字、回复一封普通邮件。
它还是一样地疯狂推演几千个 token 的内心戏。
不是模型变笨了,而是聪明使错了地方。
不是"深度推理越多越好",而是推理量应该跟任务复杂度对齐。
不是你的问题太简单,而是它没有一个"普通任务不必过度动脑"的默认意识。
用江湖话说:杀鸡用了宰牛刀,力气大了反而是浪费。
解法其实特别简单
大道至简,真正的解法就两个开关。
至于是哪两个?
就是这个——
开关一:调节 Thinking Budget(推理预算上限)
如果你用的是 Claude 或者支持参数控制的 API 接口:
把 thinking_budget 从默认的 4000+ 直接压到 500 以内。
或者在界面上把思考模式从 Extended(深度推理)切到 Normal(普通模式)。
对于日常简单任务,直接禁用深度推理。
响应速度从六十秒掉到零点五秒,不是在省 token,而是在省你的时间。
开关二:Prompt 里加一句熔断指令
如果你用的是网页版对话(豆包、Kimi、ChatGPT 都行):
在每次简单任务末尾加上这一句:
速回口令(复制即用)
本任务为基础日常任务,请勿展开复杂推理,直接给出精炼结论。
就这句话,直接打断 AI 自我纠结的内心戏。
我用过的人反馈,速度提升的感觉不亚于换了台新机器。
把推理算力用对地方,AI 才是你的武器
深度推理是好东西,不该被废掉。
但它该用在代码架构设计、逻辑拆解攻坚、大纲规划梳理这些硬仗上。
问天气、改句子、翻译日常短文,不需要它去推演《三体》级别的宇宙尺度因果链。
弓可以拉满,前提是你要射得准。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-17,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号