Claude Code 缓存 Bug:你的 Token 被悄悄烧掉了多少?

Claude Code 缓存 Bug:你的 Token 被悄悄烧掉了多少?
用户12724357
发布于 2026-09-15 18:39:18
发布于 2026-09-15 18:39:18
最近社区里出现了一个引人关注的案例:一位开发者使用第三方 API 调用 Claude Code,一段时间后发现两个不对劲的地方——
一是 Token 消耗暴涨。明明对话次数没变,账单却是以前的好几倍。
二是响应速度骤降。之前几秒出结果,现在要等十几秒甚至更久。
这不是幻觉,也不是模型变懒了。而是一个隐藏在 Claude Code 客户端里的缓存 Bug,在第三方 API 场景下被彻底引爆。
一、Claude Code 的缓存是怎么工作的?
要理解这个问题,先要搞清楚 Claude Code 的缓存机制。它设计得很精巧,分为两层。
第一层:本地快照缓存
首轮对话时,大约 5 万 Token 的上下文全量推理、写入缓存。从第二轮开始,历史对话全部从缓存读取,只把本轮新增的几十个 Token 做推理。
5 万 Token 的历史,后续每轮只算几十个——这就是缓存省钱的本质。
第二层:云端会话缓存
Anthropic 官方服务器自己也维护会话上下文。本地复用历史 Token 时,服务器端也能命中自己的缓存,进一步减少算力消耗。
两层缓存的前提只有一个:请求内容不能变。篡改任意一句历史对话内容、打乱对话顺序、更换会话 ID,缓存立刻失效,一切从头来。
两层缓存机制第一层:本地快照缓存首轮:5 万 Token 全量推理 → 写入缓存后续轮次:历史从缓存读取,仅推理新增 Token5 万历史 → 每轮只算几十个 Token第二层:云端会话缓存Anthropic 服务器维护会话上下文本地复用历史 Token 时,云端也命中缓存双层命中 = 极低成本 + 极快响应前提:请求内容不能变(前缀一致)
二、Bug 的根因:一个小 Header 毁了一切
Claude Code ≥2.1.36 版本,存在两处行为叠加破坏前缀匹配,是缓存彻底失效的完整原因。
罪魁祸首:x-anthropic-billing-header
Claude Code 在每个 API 请求中注入了一个 x-anthropic-billing-header,里面包含一个 cch 字段。这个 cch 值每次请求都会随机变动。
这个动态 Header 被写入了请求体,直接参与缓存 Key 的计算。每次请求 cch 不同,缓存 Key 就不同,缓存永远 miss。
帮凶:Git 日志自动注入
客户端还会自动把本地 git status 运行结果写入 System Prompt。一旦文件发生变更,System Prompt 内容再次改变,前缀一致性进一步被破坏。
双重前缀破坏 → 缓存彻底失效破坏源 ①:x-anthropic-billing-headercch 值逐请求随机变动篡改 Prompt 头部前缀 → 缓存 Key 每次不同破坏源 ②:Git Status 自动注入文件变更 → System Prompt 内容改写前缀一致性进一步被破坏双重变动叠加前缀一致可能性 ≈ 0 → 缓存命中率 ≈ 0%每次请求都全量重算 5 万 Token
三、为什么官方用户不受影响?
这是最关键的一点。Anthropic 官方服务器的请求处理逻辑里,能主动识别并跳过这个 Header——它知道这个字段是动态的,不应该参与缓存 Key 计算。
但第三方代理服务(包括 AWS Bedrock、本地 vLLM、智谱 GLM 等)没有这个能力。它们把 Header 当成普通字段,算进缓存 Key 里——于是每次请求的 Key 都不一样,缓存永远 miss。
官方服务器 | 第三方代理 | |
|---|---|---|
Header 处理 | 识别并跳过 billing header | 把 cch 算进缓存 Key |
缓存 Key | 固定值 | 固定值 + cch(每次不同) |
缓存命中率 | > 80% | ≈ 0% |
Token 消耗 | 正常 | 暴涨 10-20 倍 |
这就是为什么直接用 Anthropic 官方 API 的用户毫无感知,而切换到第三方代理的用户却突然发现账单飙升。
四、问题排查:如何判断你是否中招?
简易自查方法:
- Claude Code 内置命令:在 Claude Code 中输入
/usage,查看cache read和input数据 - 判断标准:如果
cache read极低(接近 0)且input消耗持续偏高,即为缓存未命中 - 健康指标:正常情况下
cache read应远大于input(通常 10-25 倍)
/usage 健康度对比✓ 缓存健康input: 94.4kcache read: 2.4mratio: 25xcache read ≫ input缓存正常命中 ✓✗ 缓存失效input: 500k+cache read: ≈ 0ratio: ≈ 0xcache read ≈ 0每次全量重算 ✗
五、官方修复与时间线
这个问题在社区引起了广泛讨论。2025 年 4 月 23 日,Anthropic 发布了官方 Postmortem,承认了这个缓存 Bug 的存在和影响。
- 2025 年初:Claude Code v2.1.36 引入
x-anthropic-billing-header,Bug 潜伏
- 社区反馈期:大量第三方 API 用户报告 Token 消耗异常暴涨 10-20 倍
- 2025.04.23:Anthropic 发布官方 Postmortem,确认三个缓存相关问题
- 修复版本:Claude Code
v2.1.116+ 已修复,并重置受影响用户的用量
修复在客户端侧完成——稳定了请求前缀,不再让动态 Header 干扰缓存 Key 计算。第三方 API 供应商(如智谱 GLM)本身已兼容 Anthropic 的 Prompt Caching 协议(自动前缀匹配),只要客户端发送的前缀稳定,缓存就能正常工作。
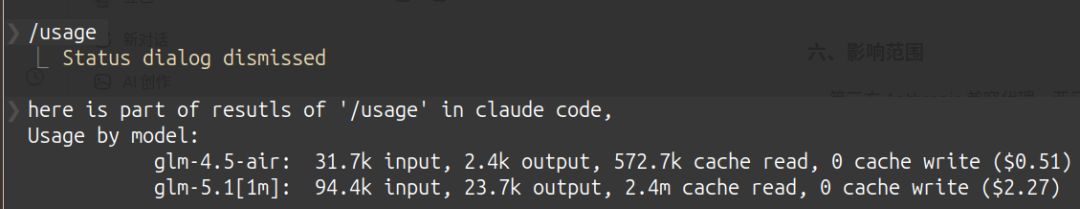
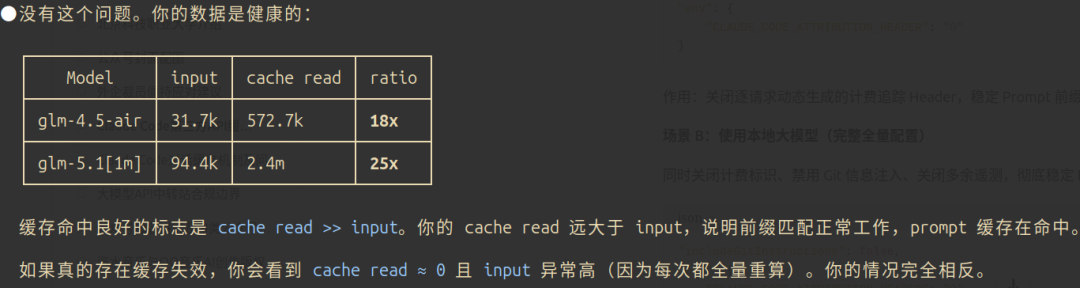
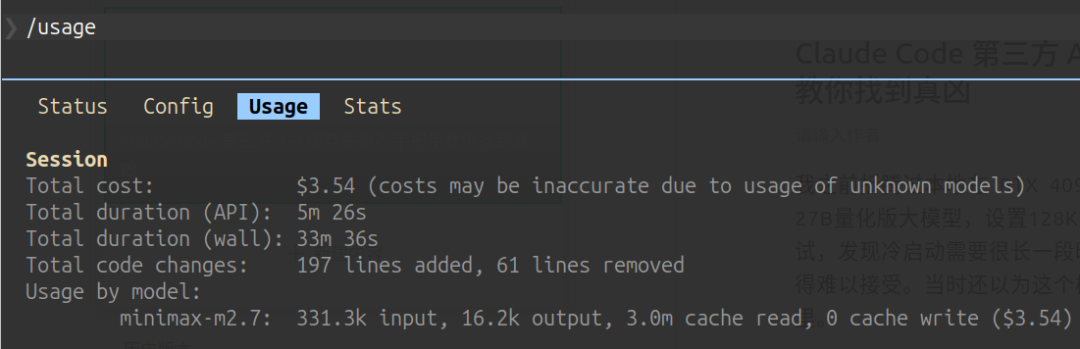
我在Claude Code v2.1.118上验证了 GLM5.1和Minimax 2.7, 都已经不存在这个问题了。
GLM tokens usage:
这是我叫Claude Code对上面结果进行验证的结论:
Minimax tokens usage:
六、如果你还在用旧版本怎么办?
最佳方案:升级 Claude Code 到 v2.1.116 或更高版本。
如果暂时无法升级,有一个临时 Workaround:
# 设置环境变量,固定 billing header 值 export CLAUDE_CODE_ATTRIBUTION_HEADER="static-value"这会阻止 cch 值随机变动,让缓存 Key 保持稳定。
另外,使用第三方路由代理(如 LiteLLM、claude-code-router)的方案也可以在中间层过滤掉这个动态 Header,保护缓存命中。
七、反思与启示
这个案例有几个值得深思的点:
1. 缓存是 AI 工具经济性的生命线。没有缓存,每次对话都要全量推理数万 Token。对于一个长对话的开发场景,这意味着成本可能高出 10-20 倍。
2. 第三方兼容的"暗坑"。协议兼容不等于行为兼容。官方服务有特殊处理逻辑来容忍自己客户端的不完美行为,但第三方没有。这类问题在官方文档中往往不会被提及。
3. 隐性 Bug 的危害。这个 Bug 不会报错、不会崩溃,只是默默地把你的账单乘以 10。如果你不主动对比 /usage 数据,可能永远不会发现。
4. 社区的力量。这个问题最终被暴露和修复,很大程度上得益于社区用户的主动排查和反馈。从 GitHub Issue 到 Reddit 帖子到技术博客,多层级的社区讨论推动了官方的重视和修复。
参考资料
- Anthropic 官方 Postmortem(2025.04.23)
- GitHub Issue #24168 — billing header bug
- 智谱 GLM Claude Code 官方文档
- Anthropic Prompt Caching 文档
欢迎交流与转载,注明出处即可。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-05-19,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号