26秋招前端面试题系列 | 计算机网络

26秋招前端面试题系列 | 计算机网络
爱学英语的程序媛
发布于 2026-09-15 11:15:48
发布于 2026-09-15 11:15:48
哈喽大家好,今天继续为大家分享最新的面试题,今天我们一起来看看计算机网络相关的内容。
一、浏览器机制
1、浏览器渲染流程(解析 HTML→生成 DOM 树→CSSOM 树→渲染树→布局→绘制→合成)
我们在日常的开发中,无非就两种架构方式:B/S和C/S架构,而对于一个B/S架构的系统来说,我们的页面主要是通过浏览器来渲染的。那浏览器具体是怎样选渲染页面的呢?主要分为以下几个阶段。
先来看一张图片:
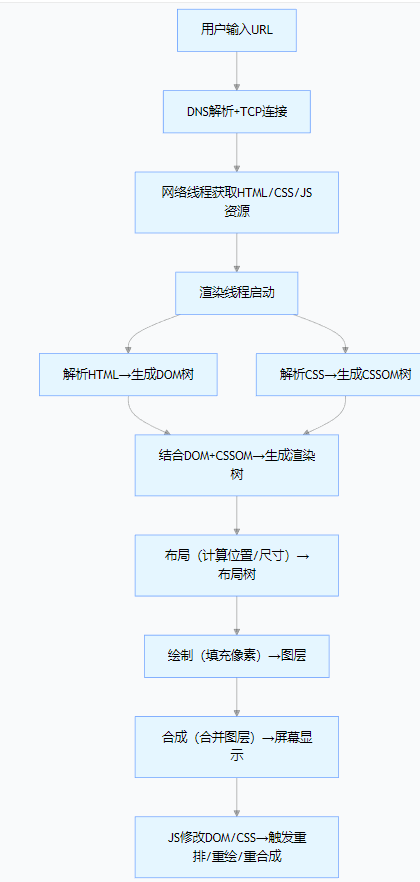
接下来听我解释:
浏览器渲染页面主要分为两个阶段:
第一阶段:渲染前资源加载:
- URL 解析与 DNS 寻址
- 用户输入 URL(如
https://www.example.com)后,浏览器先解析 URL 协议(HTTP/HTTPS)、域名(www.example.com)、端口(默认 80/443)和路径; - 通过 DNS 解析 将域名转化为服务器的 IP 地址(如
192.168.1.1),确定资源所在的服务器位置。
- 用户输入 URL(如
- 建立 TCP 连接(三次握手)
- 基于 IP 地址,浏览器与服务器通过 TCP 三次握手 建立可靠的传输连接(HTTPS 协议还会额外进行 TLS 握手,建立加密通道)。
- 发送 HTTP 请求与接收响应
- 浏览器向服务器发送 HTTP 请求(请求头包含资源类型、Cookie、缓存策略等信息),申请获取页面的核心资源 ——HTML 文件(页面的 “骨架”,优先加载);
- 服务器接收请求后,返回 HTTP 响应(响应头包含资源状态码、Content-Type 等,响应体为 HTML 文本);
- 浏览器接收 HTML 后,会立即开始解析,同时在解析过程中发现 HTML 中引用的其他资源(如 CSS、JS、图片、字体等),并由网络线程异步请求这些资源(注意:JS 资源默认会阻塞 HTML 解析,需特殊处理)。
第二阶段:渲染阶段:拿到数据之后展示在页面上
当我们的浏览器从服务器获取到 HTML、CSS 等核心资源后,会由 渲染线程 执行以下流程,最终将资源转化为用户可见的页面。这一阶段正是你提到的 “解析 HTML→生成 DOM 树→CSSOM 树→渲染树→布局→绘制→合成”,下面补充每个步骤的详细逻辑:
补充,这里提一个概念:服务端渲染。如果对它的原理感兴趣的小伙伴可以自己查阅资料了解一下。
1. 解析 HTML(HTML Parsing):生成 DOM 树
- 核心目标:将 HTML 文本(字符串)转化为浏览器可理解的 “文档对象模型”(DOM,Document Object Model),即树形结构的节点集合。
- 具体过程:
- 浏览器按 从上到下的顺序 读取 HTML 字符流,先进行 “词法分析”(将字符拆分为 HTML 标签、属性、文本等 “令牌”,如
<div>、class="box"、“Hello”);(补充:为什么HTML5提出了语义化的标签?) - 再进行 “语法分析”(将令牌按 HTML 语法规则组装成节点,如
<div>对应一个HTMLDivElement节点,文本对应Text节点); - 最后将所有节点按嵌套关系组织成 DOM 树(根节点为
document,子节点为<html>,再下为<head>和<body>,以此类推)。(补充:为什么vue3提出了虚拟DOM的概念?有哪些好处?)
- 浏览器按 从上到下的顺序 读取 HTML 字符流,先进行 “词法分析”(将字符拆分为 HTML 标签、属性、文本等 “令牌”,如
- 注意一下:
- 若解析过程中遇到 JS 脚本标签(如
<script src="app.js"></script>),默认会 暂停 HTML 解析(因为 JS 可能通过document.write()等操作修改 DOM,浏览器需先执行 JS,再继续解析); - 可通过
async或defer属性让 JS 异步执行,避免阻塞 HTML 解析(async加载完立即执行,defer等待 HTML 解析完再执行)。
- 若解析过程中遇到 JS 脚本标签(如
2. 解析 CSS(CSS Parsing):生成 CSSOM 树
- 核心目标:将 CSS 样式(包括内联样式、内部样式表、外部样式表)转化为浏览器可理解的 “CSS 对象模型”(CSSOM,CSS Object Model),即树形结构的样式规则集合。
- 具体过程:
- 浏览器读取 CSS 资源(外部 CSS 通过网络线程获取,内部 CSS 从 HTML 的
<style>标签读取,内联 CSS 从元素的style属性读取); - 对 CSS 进行 “词法分析”(拆分出选择器、属性、值,如
.box、color、red)和 “语法分析”(验证 CSS 语法合法性,忽略无效样式); - 将所有有效的 CSS 样式按 “选择器优先级”(!important > 内联样式 > ID 选择器 > 类 / 伪类选择器 > 元素选择器)组织成 CSSOM 树(结构与 DOM 树对应,每个 DOM 节点在 CSSOM 中都有对应的样式规则,未显式设置的样式会继承父节点或使用浏览器默认样式,如
<body>默认有margin: 8px)。
- 浏览器读取 CSS 资源(外部 CSS 通过网络线程获取,内部 CSS 从 HTML 的
- 注意:
- CSS 解析 不会阻塞 HTML 解析(因为 CSS 不修改 DOM),但会 阻塞渲染树生成(只有 DOM 和 CSSOM 都准备好,才能结合生成渲染树)。
3. 结合 DOM 与 CSSOM:生成渲染树(Render Tree)
- 核心目标:筛选出 “需要显示的节点”,并为每个节点绑定最终的样式,形成 “渲染树”(仅包含可见元素,不包含
<head>、display: none 的元素等)。
- 具体过程:
- 从 DOM 树的根节点开始,遍历所有可见的 DOM 节点(跳过不可见节点,如
<script>、<meta>、display: none的元素); - 为每个可见节点匹配 CSSOM 树中对应的样式规则(按优先级计算最终生效的样式,如
.box的color: red会覆盖元素默认的文本颜色); - 将 “节点 + 最终样式” 组合成 渲染树(Render Tree 的每个节点称为 “渲染对象”,对应页面上一个可见的元素区域)。
- 从 DOM 树的根节点开始,遍历所有可见的 DOM 节点(跳过不可见节点,如
- 示例:若 DOM 树中有一个
<div class="box">Hello</div>,CSSOM 中 .box { color: red; font-size: 16px; },则渲染树中该节点会绑定 “文本内容 Hello + 红色 16px 字体” 的样式。
4. 布局(Layout / Reflow):计算元素位置与大小
- 核心目标:根据渲染树和浏览器窗口尺寸,计算每个渲染对象的
精确位置(x/y 坐标) 和 尺寸(width/height),生成 “布局树”(Layout Tree,也叫 “盒模型树”)。
- 具体过程:
- 对于块级元素(如
<div>):计算其在父容器中的水平位置(margin-left/padding-left 等)、垂直位置(受前一个元素高度影响)、宽度(默认继承父容器宽度)、高度(由内容高度或height属性决定); - 对于行内元素(如
<span>):按文本流排列,计算其在一行中的位置和尺寸;
- 浏览器先确定 根容器尺寸(通常为浏览器窗口的可视区域大小,即
viewport尺寸); - 从渲染树的根节点开始,按 “流式布局”(默认)或其他布局模式(如 Flex、Grid),递归计算每个子节点的布局信息:
- 将计算好的布局信息(位置、尺寸)存储到布局树中,为后续 “绘制” 阶段提供依据。
- 对于块级元素(如
- 注意点:
- 布局是 “重计算” 过程,若后续 DOM 结构或样式发生变化(如修改
width、删除节点),会触发 重排(Reflow),即重新执行布局阶段,这会消耗较多性能(避免频繁触发重排,如批量修改样式、使用transform代替top/left)。
- 布局是 “重计算” 过程,若后续 DOM 结构或样式发生变化(如修改
5. 绘制(Painting / Repaint):填充像素到图层
- 核心目标:根据布局树和渲染树的样式信息,将每个渲染对象的 “视觉效果”(颜色、背景、边框、文本、图片等)绘制到
像素缓冲区(即 “图层”,Layer)中,生成 “像素图”。
- 具体过程:
- 绘制背景(背景色、背景图片);
- 绘制边框(边框颜色、宽度、样式);
- 绘制文本(文本颜色、字体、位置);
- 绘制图片(解码图片后,按布局尺寸绘制到指定位置);
- 浏览器为每个渲染对象分配一个 “绘制任务”,按 “从后到前” 的顺序(避免遮挡,如背景在文本下方绘制)执行:
- 绘制操作不直接操作屏幕,而是先绘制到 离屏缓冲区(Offscreen Buffer),避免屏幕闪烁。
- 关键注意点:
- 绘制是 “重绘制” 过程,若仅修改元素的 “视觉样式”(如
color、background-color,不影响位置和尺寸),会触发 重绘(Repaint),性能消耗比重排小,但仍需优化(如避免频繁修改颜色)。
- 绘制是 “重绘制” 过程,若仅修改元素的 “视觉样式”(如
6. 合成(Compositing):合并图层并显示到屏幕
- 核心目标:将多个 “绘制好的图层” 按正确的层级顺序合并(避免遮挡),并最终提交到
屏幕帧缓冲区,由显示器显示出来。
- 具体过程:
- 默认情况下,整个页面是一个合成图层;
- 某些元素会被提升为独立合成图层(如设置
transform: translateZ(0)、opacity < 1、有 CSS 动画的元素),目的是让这些元素的绘制 / 合成独立于其他元素,减少性能消耗;
- 浏览器会将页面拆分为多个 合成图层(Compositing Layers),而非单个图层:
- 合成线程(与渲染线程分离)将所有合成图层按 “Z 轴顺序”(层级顺序,如
z-index高的图层在上方)合并成一个 “最终帧”; - 将最终帧提交到屏幕帧缓冲区,显示器按 60Hz 的刷新率(约每 16.6ms 一次)读取缓冲区内容,将页面显示给用户。
- 关键优势:
- 若仅修改独立合成图层的样式(如通过
transform做动画),只需重新合成该图层,无需触发重排或重绘,这是 CSS 动画性能优化的核心原理(避免使用top/left做动画,改用transform)。
- 若仅修改独立合成图层的样式(如通过
2、本地存储(Cookie/LocalStorage/SessionStorage/indexedDB 对比);
具体内容请看下面这张表格:
特性 | Cookie | LocalStorage | SessionStorage | IndexedDB |
|---|---|---|---|---|
存储大小 | 4KB 左右 | 5-10MB | 5-10MB | 较大(一般无硬性限制) |
有效期 | 可设置过期时间 | 永久存储,除非手动清除 | 仅在当前会话有效,关闭标签页 / 浏览器后清除 | 永久存储,除非手动清除 |
存储位置 | 客户端和服务器端(每次请求自动携带) | 仅客户端 | 仅客户端 | 仅客户端 |
数据类型 | 仅字符串 | 仅字符串(需手动序列化对象) | 仅字符串(需手动序列化对象) | 结构化数据(支持多种数据类型) |
访问权限 | 遵循同源策略,可设置 domain 和 path 限制 | 严格遵循同源策略 | 不仅遵循同源策略,还限制在同一标签页 | 严格遵循同源策略 |
存储方式 | 键值对 | 键值对 | 键值对 | 事务型数据库,支持索引 |
API 复杂度 | 较简单(document.cookie) | 简单(setItem, getItem 等) | 简单(同 LocalStorage) | 较复杂(异步操作,事务处理) |
适用场景 | 身份认证、记住登录状态等小型数据 | 长期存储用户偏好设置、离线数据等 | 临时存储表单数据、页面间传递数据 | 存储大量结构化数据、离线应用数据 |
性能 | 每次请求都会携带,可能影响性能 | 同步操作,大量数据操作可能阻塞主线程 | 同步操作,仅当前会话有效 | 异步操作,适合大量数据处理,性能好 |
下面一起看看上述四种存储方式的适用场景:
- Cookie:适合存储需要与服务器交互的小型数据,如身份验证令牌、用户偏好设置等。
- LocalStorage:适合长期存储不常变动的数据,如用户配置、离线缓存的非敏感数据等。
- SessionStorage:适合存储仅在当前会话中需要的数据,如表单临时数据、单页应用的状态管理等。
- IndexedDB:适合存储大量结构化数据,如离线应用的本地数据库、需要复杂查询的数据等。
看完了上面的内容,那这里举个例子:我们的token一般存在哪?为什么要这么存?有什么风险?如何规避这种风险?
二、网络协议
1、HTTP 请求结构(请求行 / 头 / 体)
在回答这个问题之前,我们先来看一个完整的HTTP请求:
POST /api/users HTTP/1.1
Host: www.example.com
User-Agent: Mozilla/5.0
Content-Type: application/json
Content-Length: 36
{"name": "Alice", "age": 30, "email": "a@x.com"}
上面的请求中,第一行就是请求行,主要包含三个要素:请求方法,请求的URL地址和HTTP协议的版本。
常见的请求方法有四种,表示对资源的操作意图,有 GET(获取资源)、POST(提交数据)、PUT(更新资源)、DELETE(删除资源)等。那请求 的URL就指定请求的资源路径(相对路径或绝对路径),最后还有一个HTTP协议的版本,如 HTTP/1.1、HTTP/2 等。
接下来是请求头:它是一系列的键值对,用于描述请求的元信息(如客户端类型、接受的数据格式、认证信息等),每行一个键值对,格式为 Key: Value。
常见请求头示例:
Host: www.example.com:指定服务器域名和端口User-Agent: Mozilla/5.0 (Windows NT 10.0; ...):客户端浏览器 / 设备信息Accept: application/json:客户端可接受的数据格式Content-Type: application/x-www-form-urlencoded:请求体的数据格式Authorization: Bearer <token>:身份认证信息Cookie: name=value; sessionId=xxx:客户端存储的 Cookie 数据
请求头结束之后就是我们的请求体:
这一部分并不是每个HTTP请求中都有,只有在需要向服务器提交数据时使用(如 POST、PUT 方法)它来携带具体的数据内容。
请求体的格式由 Content-Type 头指定,常见类型:
application/x-www-form-urlencoded:表单数据(如name=John&age=20)multipart/form-data:文件上传或复杂表单数据application/json:JSON 格式数据(如{"name":"John","age":20})text/plain:纯文本数据
2、响应状态码(2xx/3xx/4xx/5xx 高频码含义,如 304 缓存、401 权限、403 禁止)
既然是浏览器和服务器之间的通信,而且中间要经过网络层,那我们就很难确保请求和响应一切正常,出现了问题我们怎么排查?为什么前端传递了参数,页面上却没有显示后端返回的内容?到底是前端的问题还是后端的问题还是网络的问题,那接下来这些状态码将会告诉我们问题究竟在哪里?
HTTP的响应状态码主要分为五类,分别如下:
1xx(信息性状态码)
表示服务器已接收请求,正在处理中(较少见)。
- 100 Continue:服务器已接收请求头,客户端可继续发送请求体。
2xx(成功状态码)
表示请求已被服务器成功接收、理解并处理。
- 200 OK:请求成功,响应体包含请求的资源(最常见)。
- 201 Created:请求成功且服务器创建了新资源(如 POST 新增数据)。
- 204 No Content:请求成功,但响应体无内容(如 DELETE 删除资源后)。
3xx(重定向状态码)
表示需要客户端进一步操作才能完成请求(通常是跳转)。
- 301 Moved Permanently:资源永久迁移到新 URL,浏览器会缓存新地址。
- 302 Found:资源临时迁移到新 URL,浏览器不会缓存新地址(历史上可能被滥用为临时跳转)。
- 304 Not Modified:资源未修改,客户端可直接使用本地缓存(配合缓存头
If-Modified-Since等使用,减少带宽消耗)。 - 307 Temporary Redirect:临时重定向,严格保持原请求方法(如 POST 请求重定向后仍用 POST)。
4xx(客户端错误状态码)
表示请求存在错误,服务器无法处理。
- 400 Bad Request:请求格式错误(如参数无效、JSON 格式错误)。
- 401 Unauthorized:请求需要身份认证(如未登录、Token 过期),通常会触发登录流程。
- 403 Forbidden:服务器拒绝请求(已认证,但无权限访问,如普通用户访问管理员接口)。
- 404 Not Found:请求的资源不存在(URL 错误或资源已删除)。
- 405 Method Not Allowed:请求方法不被允许(如用 POST 访问仅支持 GET 的接口)。
- 409 Conflict:请求与服务器当前状态冲突(如创建已存在的资源)。
5xx(服务器错误状态码)
表示服务器处理请求时发生内部错误。
- 500 Internal Server Error:服务器未知错误(如代码 Bug、数据库崩溃)。
- 502 Bad Gateway:服务器作为网关 / 代理时,收到上游服务器的无效响应(如反向代理后端服务故障)。
- 503 Service Unavailable:服务器暂时不可用(如维护中、负载过高),通常会包含
Retry-After头提示重试时间。 - 504 Gateway Timeout:服务器作为网关 / 代理时,上游服务器未及时响应。
3、HTTP 1.1/2.0/3.0 差异、HTTPS 工作原理(TLS 握手过程 + 加密方式);
这里由于篇幅原因,给大家整理了一张表格:
特性 | HTTP 1.1 | HTTP 2.0 | HTTP 3.0 |
|---|---|---|---|
发布时间 | 1999 年 | 2015 年 | 2022 年(标准化) |
底层协议 | TCP | TCP | QUIC(基于 UDP) |
连接方式 | 单连接,串行请求(需排队) | 单连接,多路复用(并行请求) | 单连接,多路复用(更高效) |
头部压缩 | 无(头部重复传输,冗余大) | HPACK 算法压缩 | QPACK 算法压缩(改进版) |
二进制协议 | 文本协议(易读但效率低) | 二进制协议(分帧传输,效率高) | 二进制协议 |
服务器推送 | 不支持 | 支持(主动推送关联资源) | 支持(更灵活的推送机制) |
队头阻塞问题 | 严重(一个请求阻塞后续所有请求) | 缓解(分帧避免连接级阻塞) | 解决(UDP 无队头阻塞特性) |
TLS 依赖 | 可选(HTTP 明文,HTTPS 加密) | 推荐但可选 | 强制加密(基于 TLS 1.3) |
典型性能场景 | 简单页面,请求量少 | 复杂页面,多资源并行加载 | 高延迟网络(如移动网络)、大并发 |
三、性能优化
1、浏览器缓存(强缓存 / 协商缓存机制 + 字段)
运行的好端端的系统突然出了bug,于是你去找到了技术大牛问怎么回事儿?他告诉你:要不清下缓存呢?
这里的缓存是什么意思,为什么清除了缓存就有可能让我们的系统重新跑起来?缓存中到底存了啥?
浏览器缓存其实是为了提升网页加载速度、减少服务器压力而采取的一种重要机制,主要分为强缓存和协商缓存两类,两者配合使用可最大化缓存效率。
接下来,一起来看看它俩的区别:
一、强缓存(本地缓存,不请求服务器)
强缓存由浏览器自主判断是否使用本地缓存,无需向服务器发送请求。若缓存有效,则直接使用本地资源(状态码 200 OK (from cache) 或 200 OK (from memory cache))。
控制字段(HTTP 响应头):
- Expires(HTTP 1.0)
- 格式:
Expires: Wed, 26 Sep 2025 12:00:00 GMT - 含义:指定缓存过期的绝对时间(服务器时间)。若客户端时间早于该时间,则缓存有效。
- 问题:依赖客户端时间(可能被篡改),已逐渐被
Cache-Control替代。
- 格式:
- Cache-Control(HTTP 1.1,优先级高于
Expires)常用值: 示例:Cache-Control: max-age=86400, public表示资源可被任何节点缓存,有效期 1 天。max-age=<seconds>:缓存有效时长(相对时间,如max-age=3600表示 1 小时)。public:允许任何节点(如 CDN、代理服务器)缓存。private:仅客户端可缓存(默认值,代理服务器不可缓存)。no-store:禁止任何缓存(每次都请求服务器,不存本地)。no-cache:不使用强缓存,需进入协商缓存(每次请求服务器验证)。
二、协商缓存(需请求服务器,验证缓存有效性)
当强缓存失效(过期或配置 no-cache)时,浏览器会携带缓存标识向服务器请求,由服务器判断是否使用缓存:
- 若缓存有效,服务器返回
304 Not Modified,浏览器使用本地缓存。 - 若缓存无效,服务器返回
200 OK和新资源,浏览器更新缓存。
控制字段(请求头 + 响应头):
- Last-Modified + If-Modified-Since(基于时间戳)
- 响应头
Last-Modified: Wed, 20 Sep 2025 10:00:00 GMT:服务器告知资源最后修改时间。 - 请求头
If-Modified-Since: Wed, 20 Sep 2025 10:00:00 GMT:浏览器携带上次的Last-Modified值,询问服务器 “该时间后资源是否修改过?”。 - 服务器判断:若未修改,返回
304;若已修改,返回新资源和新Last-Modified。 - 缺陷:时间戳精度为秒级,若资源在 1 秒内多次修改,无法识别;部分服务器修改时间会更新但内容未变,导致误判。
- 响应头
- ETag + If-None-Match(基于资源哈希,优先级高于时间戳)
- 响应头
ETag: "abc123":服务器对资源内容生成唯一哈希值(如 MD5),内容变则哈希变。 - 请求头
If-None-Match: "abc123":浏览器携带上次的ETag值,询问服务器 “当前资源哈希是否与该值一致?”。 - 服务器判断:若一致(未修改),返回
304;若不一致(已修改),返回新资源和新ETag。 - 优势:精度更高,能识别内容未变但修改时间变的情况。
- 响应头
三、缓存流程总结
- 浏览器请求资源时,先检查强缓存:
- 若
Cache-Control或Expires未过期,直接使用本地缓存(不发请求)。 - 若已过期或配置
no-cache,进入协商缓存。
- 若
- 协商缓存阶段:
- 浏览器携带
If-Modified-Since(时间戳)或If-None-Match(哈希)请求服务器。 - 服务器验证后,返回
304(用缓存)或200(更新缓存)。
- 浏览器携带
四、常见应用场景
- 强缓存:适用于静态资源(JS、CSS、图片),设置较长
max-age(如 1 年),配合文件名哈希(如 app.abc123.js)实现更新(哈希变则视为新资源)。
- 协商缓存:适用于频繁变动但需验证的资源(如 HTML 页面),用
ETag 确保内容准确性。
- 禁止缓存:适用于实时性要求极高的资源(如用户余额),设置
Cache-Control: no-store。
思考一下:我们怎么合理的配置缓存?哪些数据适合缓存,哪些数据不适合缓存?
2、首屏加载优化(压缩资源、懒加载、CDN 等)。
有一天,你写代码写着写着不想写了,你打算打开一个视频网站摸一会儿🐟,当你在浏览器输入url后按下了回车,页面在加载,过了三分钟,怎么还在加载?于是你默默的吐槽:谁tm写的垃圾玩意儿,一个首页加载了五分钟!
从刚刚的介绍中你应该也能感受到,首屏加载速度很影响用户的体验啊!
那遇到刚刚那种网站,我们不得优化优化,不要哪一天让用户真正骂到我们自己头上来了。。。。那怎么优化呢?我们可以从 “减少资源体积、优化加载顺序、提升加载效率”这些角度入手,也可以从网络传输、资源处理、渲染机制等多维度切入。
一、加载前:减少资源体积与请求数
首屏加载的核心瓶颈往往是 “资源过多、体积过大”,需从源头压缩请求成本。
1. 资源压缩与合并
- 代码压缩:
- JS:使用
Terser移除注释、空格、未使用代码(Tree-Shaking),避免冗余逻辑(如重复工具函数)。 - CSS:用
CSSNano压缩代码,配合PurgeCSS移除未使用样式(如引入 Bootstrap 但仅用 10% 样式)。 - HTML:用
html-minifier压缩标签、移除空格和注释(尤其静态页面)。
- JS:使用
- 资源合并(适度):
- 避免 “过度合并”(如将所有 JS 合并为一个大文件,导致首屏需加载非必要代码),优先合并首屏必需的小资源(如首屏 CSS、核心 JS)。
- 图片 / 媒体压缩:
- 图片:使用
Squoosh(在线工具)或Sharp(Node 库)压缩,保留视觉无损(如 JPG 压缩质量 80%,PNG 用optipng优化)。 - 媒体:视频用 H.265 编码(比 H.264 体积小 30%+),音频用 AAC 编码,避免首屏加载大体积媒体(可延迟加载或用封面图占位)。
- 图片:使用
2. 资源格式优化
- 图片格式选型:
- 小图标 / 透明图:用 SVG(矢量图,体积小、缩放不失真,可内联到 HTML 减少请求)。
- 照片 / 复杂图:用 WebP/AVIF(比 JPG/PNG 体积小 25%-50%,主流浏览器均支持,可降级为 JPG 兼容旧设备)。
- 动态图:用 WebP 动图替代 GIF(体积小 50%+,支持透明)。
- 字体优化:
- 仅加载首屏必需的字体子集(如仅包含中文常用字 3000 个,而非完整字体库),用
font-spider提取子集。 - 使用 WOFF2 格式(比 TTF 体积小 30%,浏览器支持率 95%+),配合
font-display: swap(先显示系统字体,字体加载完成后替换,避免文字闪烁)。
- 仅加载首屏必需的字体子集(如仅包含中文常用字 3000 个,而非完整字体库),用
二、加载中:优化加载顺序与优先级
首屏加载需遵循 “先关键、后非关键” 的原则,确保首屏核心内容(如标题、导航、主要文案)优先加载。
1. 关键资源优先加载
- CSS 优先级优化:
- 首屏 CSS 内联到 HTML 的
<head>中(避免 “外部 CSS 阻塞渲染”,减少 1 次网络请求),非首屏 CSS(如 footer 样式)用media="print"标记为 “非关键”,延迟加载。 - 避免
@import引入 CSS(会导致 CSS 串行加载,比<link>并行加载慢)。
- 首屏 CSS 内联到 HTML 的
- JS 优先级优化:
async:JS 加载完成后立即执行(顺序不保证,适合独立脚本如统计代码)。
defer:JS 加载完成后,等待 DOM 解析完成再执行(顺序保证,适合依赖 DOM 的脚本)。- 首屏核心 JS(如渲染首屏数据的逻辑)用
async或defer避免阻塞 DOM 解析: - 非首屏 JS(如弹窗、聊天组件)用 “动态加载”(如
document.createElement('script')),或在window.onload后加载。
- 首屏核心 JS(如渲染首屏数据的逻辑)用
- HTML 结构优化:
- 首屏内容放在 HTML 靠前位置(避免浏览器渲染时 “滚动加载”,优先解析关键内容),非首屏内容(如评论、推荐列表)用
<template>或动态插入,减少初始 DOM 解析量。
- 首屏内容放在 HTML 靠前位置(避免浏览器渲染时 “滚动加载”,优先解析关键内容),非首屏内容(如评论、推荐列表)用
2. 利用缓存减少重复请求
- 强缓存 + 协商缓存配置:
- 静态资源(JS、CSS、图片)设置长有效期的强缓存(如
Cache-Control: max-age=31536000,1 年),配合 “文件名哈希”(如app.abc123.js)—— 资源更新时哈希变化,自动触发重新加载。 - 首屏 HTML 用协商缓存(
Cache-Control: no-cache+ETag),确保每次请求验证是否更新,避免旧 HTML 导致资源引用错误。
- 静态资源(JS、CSS、图片)设置长有效期的强缓存(如
- CDN 加速:
- 将静态资源(JS、CSS、图片)部署到 CDN(如阿里云、Cloudflare),CDN 会将资源缓存到就近节点,减少用户与源服务器的网络延迟(尤其跨地域用户)。
- 开启 CDN 的 “静态资源预加载”(如提前缓存首屏图片),并配置 CDN 压缩(如 Gzip/Brotli)。
3. 减少网络延迟与请求开销
- 启用 HTTP/2 或 HTTP/3:
- 相比 HTTP/1.1,HTTP/2 支持 “多路复用”(单连接并行加载多个资源,避免队头阻塞)、“服务器推送”(提前推送首屏依赖资源,如 HTML 加载时推送首屏 CSS),HTTP/3 基于 UDP 进一步优化延迟,需服务器(如 Nginx、Apache)配置支持。
- 压缩传输(Gzip/Brotli):
- 对文本类资源(JS、CSS、HTML、JSON)启用 Brotli 压缩(比 Gzip 压缩率高 15%-20%,浏览器支持率 95%+),图片 / 媒体无需压缩(已预处理)。
- 服务器配置:Nginx 需添加
brotli on;模块,Apache 需启用mod_brotli。
- DNS 预解析与连接复用:
- 对首屏依赖的第三方域名(如 CDN 域名、接口域名)添加
dns-prefetch:<link rel="dns-prefetch" href="//cdn.example.com">,提前解析 DNS(减少 20-120ms 延迟)。 - 对 HTTPS 站点,启用
preconnect提前建立 TCP + TLS 连接:<link rel="preconnect" href="//api.example.com">,避免请求时的握手延迟。
- 对首屏依赖的第三方域名(如 CDN 域名、接口域名)添加
三、渲染时:避免阻塞渲染与优化交互
即使资源加载完成,若渲染过程存在阻塞(如 JS 执行过长、重排重绘),仍会导致首屏显示延迟。
1. 避免渲染阻塞
- 减少 JS 执行时间:
- 首屏 JS 逻辑拆分,避免 “长任务”(执行时间 > 50ms)—— 可将复杂计算(如数据格式化)拆分为微任务(
requestIdleCallback),在浏览器空闲时执行,不阻塞渲染。 - 避免在
DOMContentLoaded或load事件中执行大量同步代码,优先渲染 UI,再处理非关键逻辑。
- 首屏 JS 逻辑拆分,避免 “长任务”(执行时间 > 50ms)—— 可将复杂计算(如数据格式化)拆分为微任务(
- 优化 CSS 选择器:
- 避免复杂 CSS 选择器(如
div:nth-child(2).class),浏览器匹配选择器是 “从右到左”,简单选择器(如.class、#id)匹配更快,减少渲染耗时。
- 避免复杂 CSS 选择器(如
2. 减少重排与重绘
- 首屏 DOM 轻量化:
- 避免首屏存在大量 DOM 节点(如列表超过 100 项),可用 “虚拟列表”(仅渲染可视区域节点)或分页加载,减少初始渲染压力。
- 样式操作优化:
- 集中修改样式(如用
class切换样式,而非多次element.style操作),避免频繁触发重排(如改变width、height、top等属性)。 - 对动画元素,用
transform和opacity实现(仅触发复合层,不触发重排重绘),避免用left、margin等属性。
- 集中修改样式(如用
3. 骨架屏与加载状态优化
- 首屏骨架屏:
- 在首屏内容加载完成前,显示 “骨架屏”(低体积的占位 UI,如灰色块模拟标题、图片位置),替代空白页,减少用户 “等待感”。
- 骨架屏优先内联到 HTML 中(无需额外请求),内容加载完成后自动替换。
- 加载状态反馈:
- 对首屏关键资源(如接口数据),添加加载动画(如小 spinner),避免用户误以为页面卡住;加载失败时显示重试按钮,提升容错性。
四、进阶优化:技术方案选型
1. 服务端渲染(SSR)/ 静态站点生成(SSG)
- 适用场景:首屏依赖动态数据(如首页推荐列表)、SEO 需求高的站点(如博客、电商首页)。
- 原理:
- SSR:服务器端提前渲染首屏 HTML(包含动态数据),直接返回给客户端,客户端无需等待 JS 执行即可看到首屏(减少 “白屏时间”)。
- SSG:构建时预渲染首屏 HTML(如 VuePress、Next.js 的静态导出),首屏加载时直接返回静态 HTML,性能接近纯静态页面。
- 优势:首屏渲染速度快(TTFB 短),SEO 友好;劣势:服务器压力大(SSR)、动态内容更新需重新构建(SSG)。
2. 懒加载(Lazy Loading)
- 非首屏资源延迟加载:
- 图片 / 视频:用
loading="lazy"属性(浏览器原生支持),或 Intersection Observer 监听元素是否进入视口,再加载资源(避免首屏加载下方图片)。 - 组件:Vue/React 中用 “异步组件”(如
React.lazy(() => import('./Component'))),非首屏组件(如弹窗、详情页)仅在需要时加载。
- 图片 / 视频:用
3. 预加载(Preloading)与预连接(Preconnect)
- 预加载首屏关键资源:
- 对首屏必需但延迟发现的资源(如首屏 JS 依赖的某个模块),用
<link rel="preload" href="critical.js" as="script">强制提前加载,避免 “关键资源加载延迟”。
- 对首屏必需但延迟发现的资源(如首屏 JS 依赖的某个模块),用
- 预连接第三方域名:
- 对首屏依赖的第三方服务(如支付接口、地图 API),用
<link rel="preconnect" href="//third-party.com">提前建立连接,减少后续请求的握手延迟。
- 对首屏依赖的第三方服务(如支付接口、地图 API),用
五、优化效果验证
优化后需通过工具量化效果,确保首屏加载速度达标:
- 核心指标:
- 首屏加载时间(FCP,First Contentful Paint):目标 < 1.8s(移动端)、< 1.2s(桌面端)。
- 最大内容绘制(LCP,Largest Contentful Paint):目标 < 2.5s(优秀)、< 4s(需优化)。
- 首次输入延迟(FID):目标 < 100ms(衡量交互响应速度)。
- 工具:
- 浏览器 DevTools(Network 面板看资源加载顺序,Performance 面板分析渲染瓶颈)。
- 在线工具:Google PageSpeed Insights(评分 + 优化建议)、Lighthouse(全面性能报告)、WebPageTest(多地区 / 设备加载测试)。
扩展:
1、介绍一下 TCP 握手过程
由于篇幅原因,这里请大家看下面的表格:
步骤 | 发送方 | 接收方 | 数据包内容(核心字段) | 目的 |
|---|---|---|---|---|
1 | 客户端 | 服务器 | SYN = 1,Seq = x(初始序列号) | 客户端向服务器 “请求建立连接”:1. SYN=1 表示这是 “同步请求包”(发起连接);2. Seq=x 是客户端生成的随机初始序列号(后续客户端发送数据会从 x+1 开始)。 |
2 | 服务器 | 客户端 | SYN = 1,ACK = x+1,Seq = y | 服务器 “响应连接请求,并同步自身信息”:1. SYN=1 表示服务器也向客户端发起同步(确认双方都要建立连接);2. ACK=x+1 表示 “已收到客户端的 Seq=x,下一次期待接收 x+1”(验证客户端接收能力);3. Seq=y 是服务器生成的随机初始序列号(后续服务器发送数据从 y+1 开始)。 |
3 | 客户端 | 服务器 | ACK = y+1 | 客户端 “确认收到服务器响应,连接正式建立”:1. ACK=y+1 表示 “已收到服务器的 Seq=y,下一次期待接收 y+1”(验证服务器接收能力);2. 此时双方都确认对方能收发数据,TCP 连接建立完成,后续可进入 TLS 握手阶段。 |
为什么需要三次,而不是两次呢?
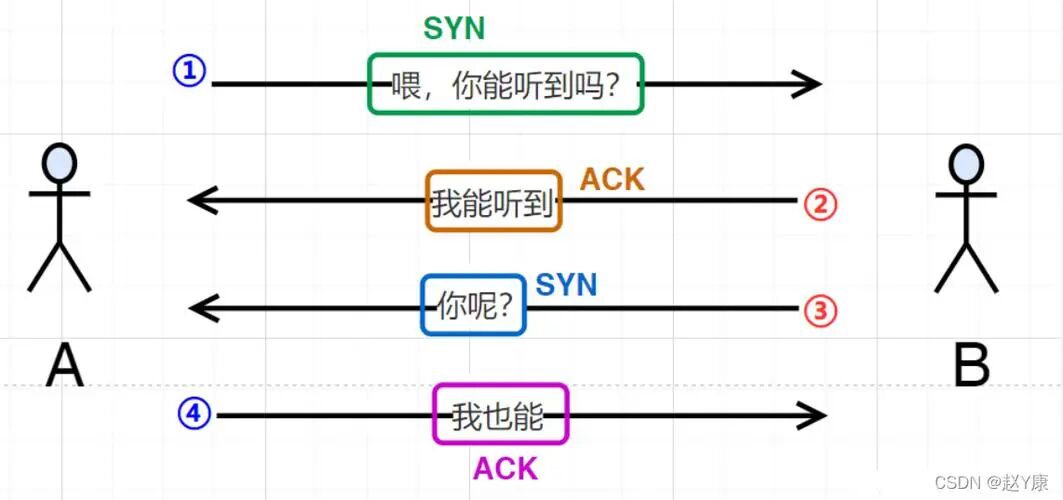
因为两次握手无法验证 “服务器的接收能力”:若客户端发送的 SYN 包超时后到达服务器,服务器回复 SYN+ACK 但客户端已失效,服务器会一直等待客户端的 ACK,导致资源浪费(“半连接队列” 堆积)。
三次握手通过 “客户端最后一次 ACK”,确保服务器知道 “客户端能收到自己的响应”,避免无效连接,同时完成双向序列号协商,为后续可靠传输打下基础。
紧接着,我们来看看四次挥手的详细过程
步骤 | 发送方 | 接收方 | 数据包内容(核心字段) | 目的 |
|---|---|---|---|---|
1 | 客户端 | 服务器 | FIN = 1,ACK = z | 客户端 “请求关闭自身发送数据的方向”(半关闭):1. FIN=1 表示 “终结连接请求”(客户端不再向服务器发数据);2. ACK=z 是对服务器之前发送数据的确认(确保之前的数据已接收完成);3. 此时客户端进入 FIN_WAIT_1 状态,等待服务器响应。 |
2 | 服务器 | 客户端 | ACK = w+1 | 服务器 “确认收到客户端的关闭请求”:1. ACK=w+1 表示 “已收到客户端的 FIN 包,下一次期待接收 w+1”(w 是客户端 FIN 包的序列号);2. 此时服务器进入 CLOSE_WAIT 状态,客户端进入 FIN_WAIT_2 状态;3. 注意:服务器此时仍可向客户端发送未完成的数据(如剩余的响应内容)。 |
3 | 服务器 | 客户端 | FIN = 1,ACK = w+1,Seq = v | 服务器 “完成数据发送,请求关闭自身发送数据的方向”:1. FIN=1 表示 “服务器不再向客户端发数据”;2. ACK=w+1 再次确认客户端的 FIN 包(避免丢失);3. Seq=v 是服务器最后发送数据的序列号;4. 此时服务器进入 LAST_ACK 状态,等待客户端确认。 |
4 | 客户端 | 服务器 | ACK = v+1 | 客户端 “确认收到服务器的关闭请求,进入等待期”:1. ACK=v+1 表示 “已收到服务器的 FIN 包,下一次期待接收 v+1”;2. 客户端不立即关闭,而是进入 TIME_WAIT 状态(等待 2*MSL,MSL 是报文段最大生命周期,通常为 1-2 分钟);3. 服务器收到 ACK 后,立即关闭连接(进入 CLOSED 状态);4. 客户端等待 TIME_WAIT 结束后,确认服务器已关闭,再关闭连接(避免服务器未收到 ACK 而重发 FIN 包)。 |
那为什么断开连接需要四次挥手呢?而不是三次?
- 关键原因是 “全双工通信的双向关闭”:三次握手时,服务器的 SYN 和 ACK 可以合并为一个包(因为服务器在确认客户端连接的同时,也需要同步自身序列号,无需额外等待);但四次挥手时,服务器收到客户端的 FIN 后,可能仍有未发送完的数据(如服务器正在处理最后一段响应),因此必须先回复 ACK(确认关闭请求),待数据发送完成后再发送 FIN(请求关闭自身方向),这两个步骤无法合并,因此需要 4 个数据包。
好啦 ,本期文章就到这里,我相信很少有人会读到最后,感谢大家的阅读,我们下期再见啦~
下一期文章我们会推送vue相关的八股文和场景题,节前预计会推送两期,一期vue,一期react,内容目前已经整理了一大半了,可谓是干货满满呀!详细内容大家敬请期待哦~
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-09-26,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号