细节拉满:Claude Code 上下文压缩流水线与 Prompt Cache 优化思路

细节拉满:Claude Code 上下文压缩流水线与 Prompt Cache 优化思路
乐小野
发布于 2026-06-15 14:44:01
发布于 2026-06-15 14:44:01
📌 一句话讲明白 Claude Code的代码库里,模型决策逻辑只占1.6%。剩下98.4%全是Operational Harness,权限系统、五层context压缩、工具路由、安全护栏、生命周期钩子。 这套东西是2026年AI工程圈最热的概念之一。Anthropic把它叫Agentic Harness,社区把围绕它的工程实践叫Harness Engineering。这篇从Claude Code的实际实现出发,拆它的六层结构、五层压缩、七级权限,以及一个最小可行harness怎么搭。
这篇跟之前的「动态工作流」那篇有一个关键区别。上一篇聚焦的是Claude Code的while循环和模型如何做决策。这篇反过来,聚焦的是循环之外那98.4%,那些确定性的、不依赖模型判断的工程机制。
为什么要单独写? 因为2026年以来,行业逐渐形成了一个共识,决定一个AI agent能否可靠产出的,不是模型本身,而是包裹在模型外面的那层东西。
LangChain团队做过一个实验,同一个模型(GPT-4),仅修改harness(不换模型),任务完成率从52.8%提升到66.5%。提升了近14个百分点。模型没变,变的是环境。
这就是Harness Engineering的核心主张。
🧭 从Prompt到Context到Harness,三代演进
先把术语的演进理一遍。这三个概念不是互相替代的,是层层包含的关系:
Harness Engineering (最外)Context EngineeringPrompt Engineering单次输入优化System Prompt + Tools + Memory + 对话历史权限系统 / Hooks / 压缩流水线 / Sandbox / 工具路由 / 多Agent编排代际 | 名称 | 关注点 | 代表实践 |
|---|---|---|---|
第一代 | Prompt Engineering | 单次input的措辞 | few-shot、chain-of-thought、system prompt |
第二代 | Context Engineering | 模型在session中能看到的全部信息 | RAG、tool definitions、memory注入、compaction |
第三代 | Harness Engineering | context之外的确定性执行环境 | Hooks、permission gates、sandbox、verification loops |
Anthropic在2025年9月发了一篇「Effective Context Engineering for AI Agents」,把context engineering正式提出来。然后Martin Fowler在2026年2月进一步提出,对于agentic系统,需要关注的不只是context(模型能看到什么),还包括harness(模型周围的机械执行环境)。
💡 工程要点 Context Engineering是Harness的一个子集。Harness包含context管理,但还额外包含那些context看不到但确实在运行的东西,hooks在工具调用前后执行的脚本、permission gate决定是否放行、sandbox限制文件系统访问范围。这些不在模型的context里出现,但会直接影响执行结果。
🧱 Claude Code的六层Harness架构
Anthropic的设计空间论文(arxiv 2604.14228)和社区分析综合起来,Claude Code的harness可以拆成六层:

每一层解决一个独立的问题:
层 | 解决的问题 | 关键机制 |
|---|---|---|
Loop | 模型怎么持续运行 | ReAct循环,调模型→执行工具→追加结果→再调模型 |
Tools | 模型能做什么 | 5大类内置工具 + MCP外部工具 + 子agent委托 |
Context | 模型能看到什么 | 五层压缩、CLAUDE.md层级、path-scoped rules、auto memory |
Persistence | 信息怎么跨session存活 | JSONL transcript、checkpoints、memory目录、session resume |
Verification | 怎么确认结果正确 | Stop hooks阻止提前结束、/goal持续检测、交叉验证 |
Constraints | 怎么防止出格 | deny-first权限、PreToolUse拦截、sandbox文件系统隔离 |
🎯 真正的takeaway 模型的推理再强,如果Layer 3(context)管理不好,它看到的信息越来越差;如果Layer 5(verification)缺失,它输出的质量无人检验;如果Layer 6(constraints)没有,它可能执行危险操作。Harness的价值在于让每一层都稳定,模型才能在这个稳定的环境里发挥最大能力。
⚙️ 五层Context压缩,拆到最细
Context层是harness里最精密的部分。每次调用模型前,有一个五层顺序执行的压缩流水线:
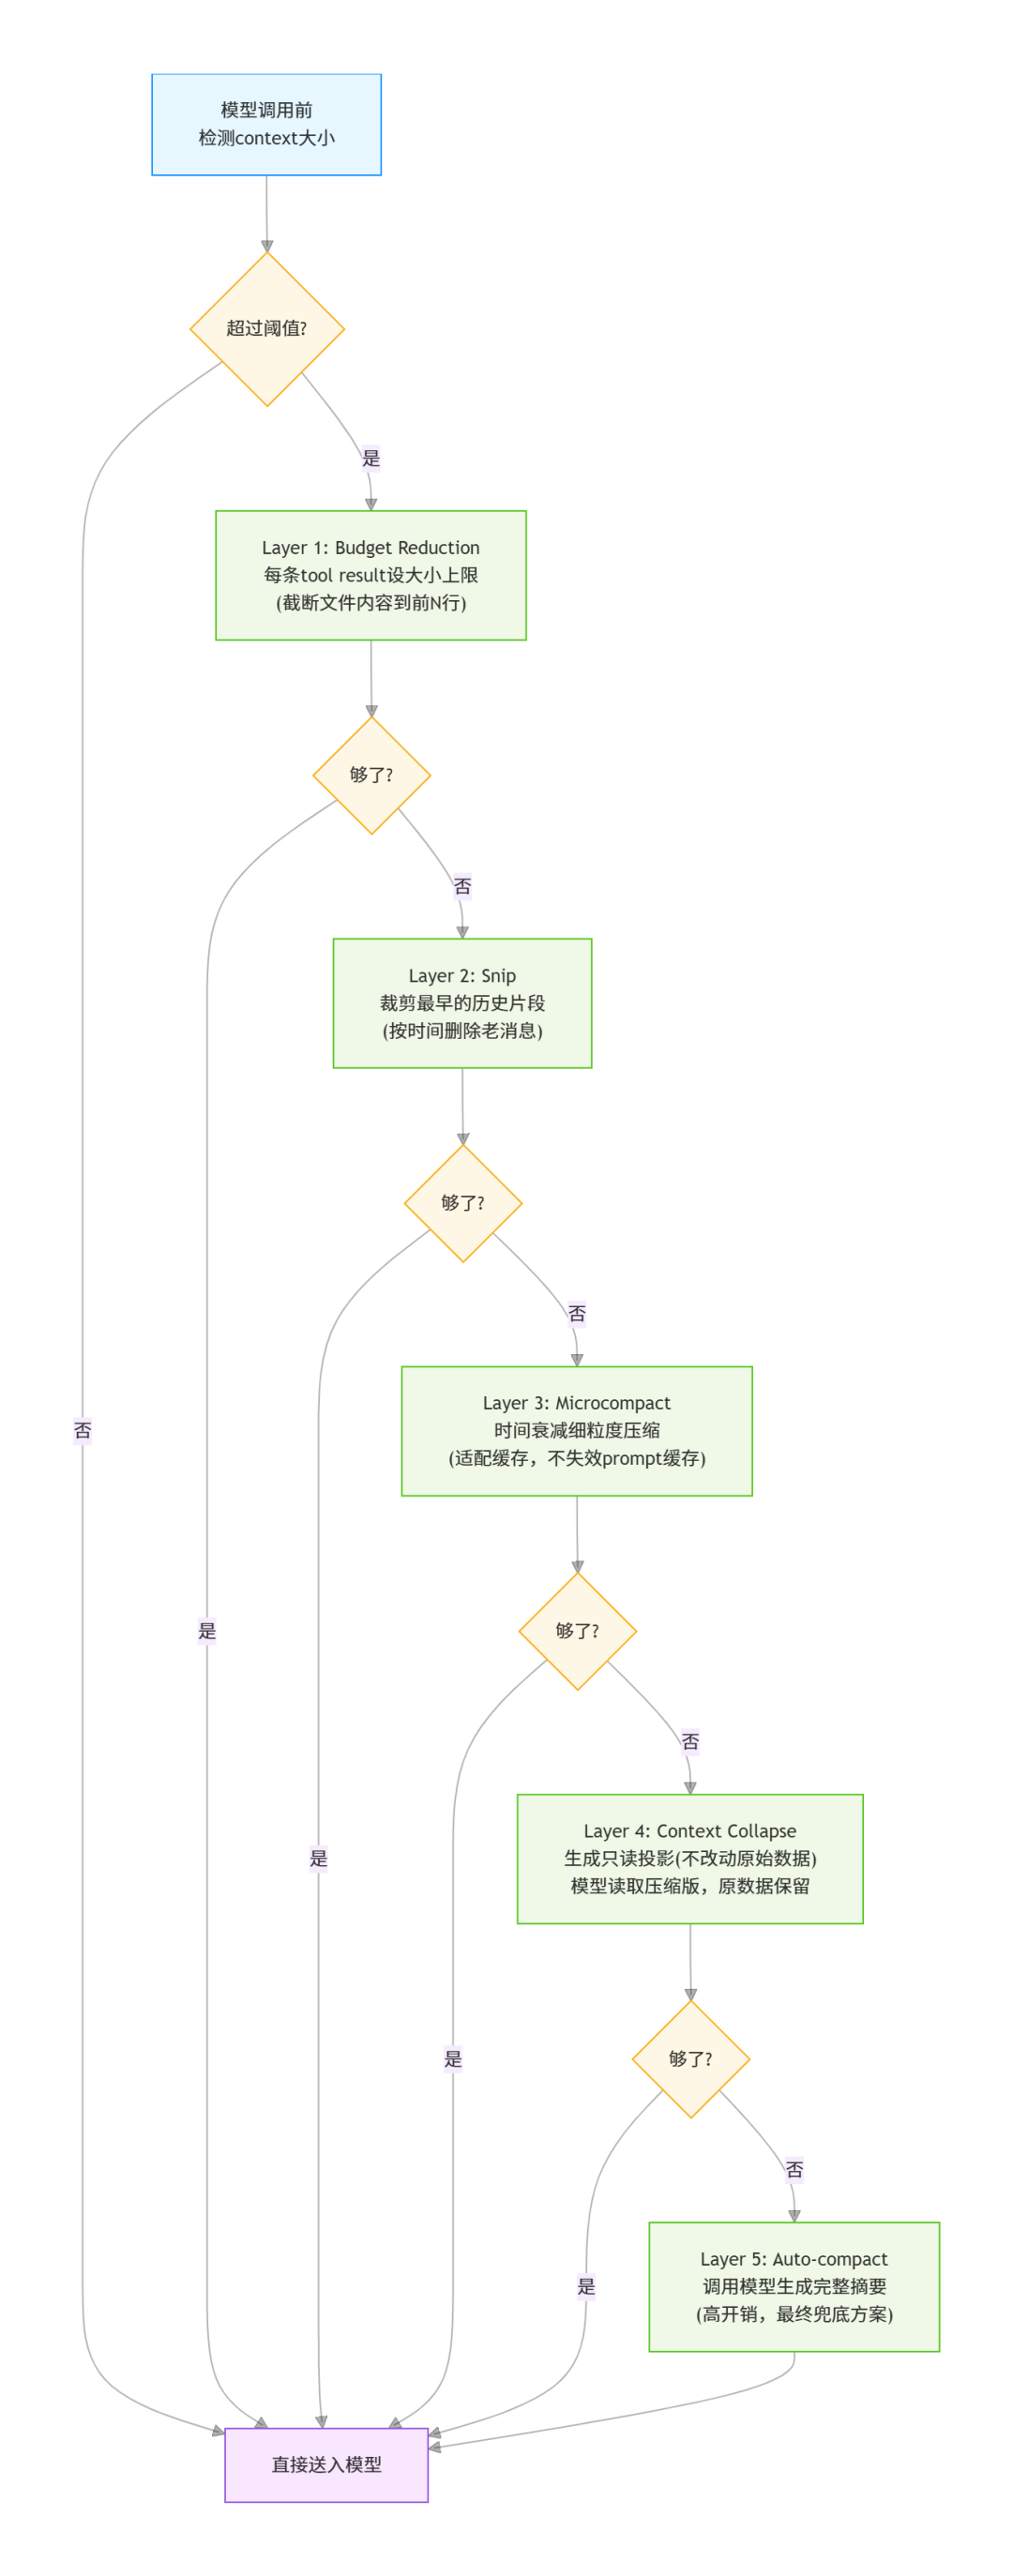
几个关键设计决策:
Layer 1 Budget Reduction — 不是「删」,是「截断」。一个3000行的文件只取前N行进入context,但原始读取结果仍然存储在JSONL里。这样模型如果需要后半部分,可以再次read。
Layer 3 Microcompact — 这一层特别考虑了prompt cache的影响。Anthropic的API有prompt caching机制,前缀不变的请求可以复用cache。如果压缩改动了靠前的内容,会导致cache miss。Microcompact优先压缩靠后的内容,保护cache prefix。
Layer 4 Context Collapse — 最精妙的一层。它生成一个「只读投影」给模型看,但不修改底层的JSONL存储。实际效果是,模型看到的context变小了(性能恢复),但你随时可以/rewind到任何历史checkpoint,因为原始数据还在。
⚠️ 限制 Auto-compact(Layer 5)之后,路径特定的rules和子目录CLAUDE.md会丢失,直到Claude再次读到对应文件才会重新加载。如果某条指令必须在compact后存活,要么放在项目根CLAUDE.md里,要么在compact时用
/compact focus on XXX显式指定保留。
🔒 七级权限光谱,deny-first的安全层
Constraints层是harness的最外层防线。Claude Code不是用「规则列表」来管权限,而是设计了一个七级渐进信任光谱:
Plan\n(只读)Default\n(每次确认)Accept Edits\n(文件自动通过)Auto\n(ML分类器评估)Don't Ask\n(自动拒绝需确认的)Bypass\n(跳过所有)Ultracode\n(全力以赴)评估逻辑的核心原则是deny-first with human escalation:
- 1. 先检查deny规则(如果命中,直接拒绝,模型永远看不到这个工具)
- 2. 再检查allow规则(如果命中,自动放行)
- 3. 都没命中,根据当前permission mode决定(问用户/ML分类器评估/自动拒绝)
一个实际数据,Claude Code用户93%的权限请求被approve。这说明deny-first的设计非常精准,它拦截的都是真正需要拦的,绝大多数正常操作都自动通过了。
💡 工程要点 deny规则永远覆盖allow规则,跟防火墙一样。你在settings.json里配了
permissions.deny: ["Bash(rm *)"],即使模型在auto mode下也绝对跑不了rm。这是harness的「硬保证」,不依赖模型的判断力。
🪝 Hooks,harness的可编程接口
如果六层结构是harness的骨架,Hooks就是它开放给你的编程接口。通过hooks,你可以在循环的任意生命周期节点插入自定义逻辑:
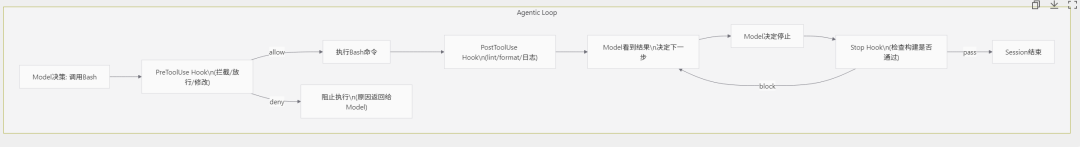
最佳实践场景:
场景 | Hook类型 | 实现 |
|---|---|---|
每次文件编辑后自动format | PostToolUse(Write|Edit) | 跑prettier/ruff |
阻止删除关键文件 | PreToolUse(Bash) | 检测rm命令,exit 2拒绝 |
防止agent修改linter配置 | PreToolUse(Write|Edit) | 检测目标路径是否为.eslintrc |
确保构建通过才能停下 | Stop | 跑build,失败则block |
子agent启动时注入额外context | SubagentStart | 返回additionalContext |
一个关键细节,hook的stdout在exit 0时不进入model的context。只有通过hookSpecificOutput.additionalContext字段返回的JSON才会被model看到。这是刻意的token节省设计。如果你想让hook的结果驱动model的下一步行动,必须走additionalContext。
实际配置示例:
{
  "hooks":{
    "PostToolUse":[
      {
        "matcher":"Write|Edit|MultiEdit",
        "hooks":[
          {
            "type":"command",
            "command":"bash .claude/hooks/post-edit-lint.sh"
          }
        ]
      }
    ],
    "PreToolUse":[
      {
        "matcher":"Bash",
        "hooks":[
          {
            "type":"command",
            "command":"bash .claude/hooks/block-dangerous-commands.sh"
          }
        ]
      }
    ]
}
}
🔬 Verification层,让agent自证正确
这一段值得专门讲。很多人用Claude Code的模式是「让它干完活,然后自己review」。但harness的verification层提供了一种更高效的方式,让系统本身来验证结果。
四种验证机制,从轻到重:
1. 内联验证(在prompt里要求)
修复这个bug,写一个失败测试先复现,然后修复它,跑测试确认通过。最轻量,但依赖model记住去做。
2. /goal 持续条件
/goal 所有测试通过且lint零错误设一个目标条件,每个turn结束后由独立evaluator检测是否满足。不满足就继续工作。
3. Stop Hook(确定性gate)
在.claude/settings.json里配一个Stop hook,跑构建/测试脚本,不通过就block停止:
{
  "hooks":{
    "Stop":[
      {
        "hooks":[
          {
            "type":"command",
            "command":"npm test && npm run build"
          }
        ]
      }
    ]
}
}
Claude Code会在hook连续block 8次后强制终止(防止无限循环)。
4. 对抗性子agent(最重) spawn一个独立子agent,它看不到主agent的推理过程,只能看到diff结果和验证标准。因为context隔离,它提供的是真正独立的second opinion:
用一个子agent review刚才的改动,对照PLAN.md检查每个需求是否实现,
只报告影响正确性的gap,不报风格问题。
Dynamic Workflows在verification层有一个精妙设计,编排脚本可以让Phase 1的agent做研究,Phase 2的另一组agent独立审查Phase 1的结论(因为不同agent有独立context,审查者看不到研究者的推理)。这是系统级的对抗性验证。
🏭 最小可行Harness,从零开始搭
讲了这么多机制,实际操作从哪里开始? 社区里有一个「Minimum Viable Harness」(MVH)的概念,不需要一次性搭完六层,按优先级逐步叠加:
Week 1 — 基础层
- 1. 创建
CLAUDE.md,控制在50行以内。只放「Claude不可能从代码推断出来的东西」:- • 构建命令、测试命令
- • 代码风格里跟默认不同的规则
- • 分支命名/PR惯例
- 2. 配一个PostToolUse hook做自动format:
{
  "hooks":{
    "PostToolUse":[
      {
        "matcher":"Write|Edit",
        "hooks":[{"type":"command","command":"npx prettier --write $TOOL_INPUT_FILE"}]
      }
    ]
}
}- 3. pre-commit hooks(husky/lint-staged)兜底
Month 2 — 安全层
- 4. 用PreToolUse hook拦截危险操作:
- • 阻止
rm -rf - • 阻止修改linter配置文件
- • 阻止直接push到main
- • 阻止
- 5. 自定义linter规则,每条规则带修复指令:
ERROR: 使用了deprecated的fetchUser API
WHY: 该API在v3后不再支持,会导致运行时错误
FIX: 改用getUserById,签名为getUserById(id: string): Promise<User>
EXAMPLE: const user = await getUserById(req.params.id)
Month 3 — 验证层
- 6. Stop hook检查构建状态
- 7. 配置verification子agent做code review
- 8. 考虑引入Dynamic Workflows做大规模任务的交叉验证
📅 同期对照 nyosegawa.com的实践总结有一句话很精准,「Add one linter rule and every session from here on out avoids that mistake.」Harness的投入是复合收益的。每加一条规则,所有未来的session都受益。这跟prompt不一样,prompt是一次性的,harness是永久的。
🆚 Harness vs Framework,为什么不用LangGraph
这是一个社区里争论很多的话题。既然harness这么重要,为什么Claude Code不用LangGraph或者CrewAI这种agent framework?
核心区别:
维度 | Framework (LangGraph等) | Harness (Claude Code等) |
|---|---|---|
决策者 | 图结构定义路径 + 模型填充节点 | 模型全权决策,harness只管执行环境 |
灵活性 | 有限(图的边决定了可能的路径) | 无限(模型想怎么走就怎么走) |
可预测性 | 高(路径是预定义的) | 低(每次执行路径可能不同) |
开发成本 | 高(需要设计图结构) | 低(只需要配环境) |
对模型的要求 | 低(图已经约束了它) | 高(模型必须足够强才能自主决策) |
适用场景 | 步骤固定的workflow | 开放式agent任务 |
Anthropic在re:Invent 2025的分享里直接说了:
"Teams should avoid overly opinionated frameworks that hide underlying mechanics."
他们的观点是,当模型足够强时,预设的图结构反而是束缚。你应该做的不是告诉模型「走A→B→C」,而是给它一个安全的、工具齐全的环境,让它自己决定怎么走。
这不是说framework没有价值。对于那些步骤确实固定的流水线(CI/CD、数据ETL),static workflow更合适。但对于coding agent这种每次任务路径都不同的场景,harness是更好的架构选择。
❓ 几个还没看清楚的点
- 1. Harness的调试难度。当你有hooks + permission rules + compaction策略 + multiple CLAUDE.md层级全部叠在一起时,出了问题很难判断是哪一层的影响。目前Claude Code提供了
/doctor和debug log,但观测性仍然不够。 - 2. Harness本身的「配置即代码」管理。
.claude/settings.json+.claude/hooks/+.claude/agents/+.claude/rules/+CLAUDE.md,一个项目的harness配置散落在很多地方。目前没有一个统一的「harness配置dashboard」。 - 3. 跨tool的harness标准化。你在Claude Code上搭好的harness(hooks、settings、CLAUDE.md),切到Cursor或Codex就全部失效。社区有人在推AGENTS.md作为通用标准,但目前各工具的harness接口完全不同。
- 4. Harness的复杂度上限。当hooks和rules越来越多,harness本身变成了一个需要维护的系统。什么时候harness的维护成本超过了它带来的收益? 目前没有明确的benchmark。
✍️ 写在最后
如果只记一件事,Harness Engineering的核心主张是「用机制强制质量,不要用prompt请求质量」。
Prompt是软约束,模型可能遵循,可能忘记,context满了之后大概率丢失。Harness是硬保证,hooks必定执行,permission gate必定检查,linter规则必定触发。把质量保障从prompt层迁移到harness层,是2026年AI工程最重要的范式转移之一。
References
- 1. VILA-Lab, "Dive into Claude Code: The Design Space of Today's and Future AI Agent Systems", arXiv 2604.14228, April 2025, https://arxiv.org/abs/2604.14228
- 2. Anthropic, "How Claude Code works - The agentic loop", 2025, https://code.claude.com/docs/en/how-claude-code-works
- 3. Anthropic, "Effective context engineering for AI agents", September 2025, https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- 4. Anthropic, "Building Effective AI Agents", December 2024, https://www.anthropic.com/research/building-effective-agents
- 5. Anthropic, "Context engineering: memory, compaction, and tool clearing", 2026, https://platform.claude.com/cookbook/tool-use-context-engineering-context-engineering-tools
- 6. Nyosegawa, "Harness Engineering Best Practices for Claude Code / Codex Users", 2026, https://nyosegawa.com/en/posts/harness-engineering-best-practices-2026/
- 7. Yu Wenhao, "Agent Harness: What Actually Determines Whether AI Delivers", 2025, https://yu-wenhao.com/en/blog/ai-harness/
- 8. AWS re:Invent 2025, "What Anthropic Learned Building AI Agents in 2025 (AIM277)", https://dev.to/kazuya_dev/aws-reinvent-2025-what-anthropic-learned-building-ai-agents-in-2025-aim277-16lc
- 9. Roan Monteiro, "Harness Engineering: why this term matters more than framework in 2026", Medium, 2026, https://medium.com/@roanmonteiro/harness-engineering-why-this-term-matters-more-than-framework-in-2026-ba96a6313268
- 10. Li et al., "Code as Agent Harness: Toward Executable, Verifiable, and Stateful AI Agent Systems", arXiv 2605.18747, May 2025, https://arxiv.org/abs/2605.18747
- 11. Anthropic, "Hooks - Programmable lifecycle events", 2025, https://code.claude.com/docs/en/hooks
- 12. Anthropic, "Orchestrate subagents at scale with dynamic workflows", 2025, https://code.claude.com/docs/en/workflows
- 13. Anthropic, "Permission modes", 2025, https://code.claude.com/docs/en/permission-modes
- 14. Martin Fowler, "Harness Engineering - Designing execution loops for agentic systems", February 2026
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-06-12,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号