DINOv2太可怕了,零样本实现多种视觉下游任务

DINOv2太可怕了,零样本实现多种视觉下游任务
OpenCV学堂
发布于 2026-04-02 19:59:33
发布于 2026-04-02 19:59:33
Facebook AI推出的DINO视觉模型,是一个全新的自监督系统,能够从无标签数据中学习惊人的表征。预训练的DINO模型是在公开数据集上使用不同的Vision Transformers(ViT)架构进行训练的。该模型能够自动学习特定类别的特征,从而实现了准确的非监督物体分割。填补了SAM下游视觉任务的处理空白。
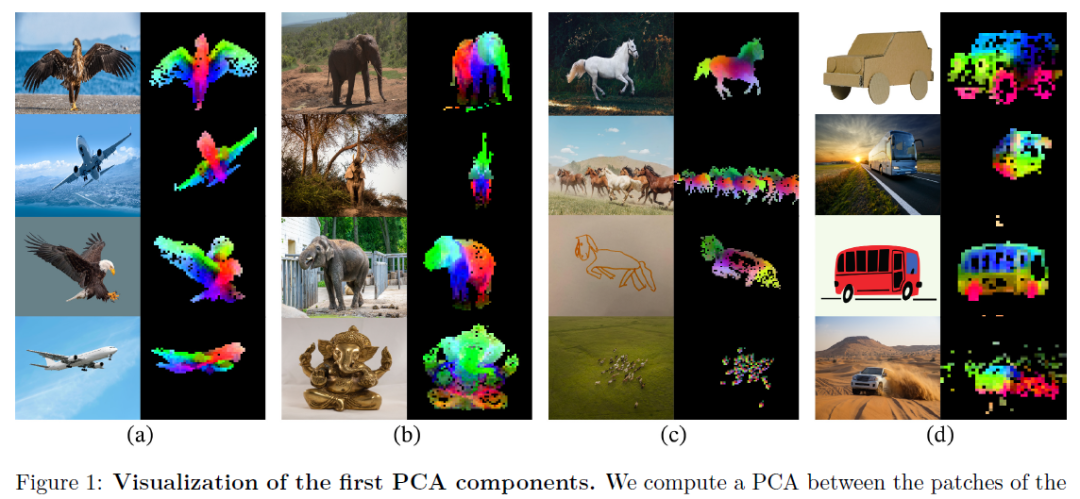
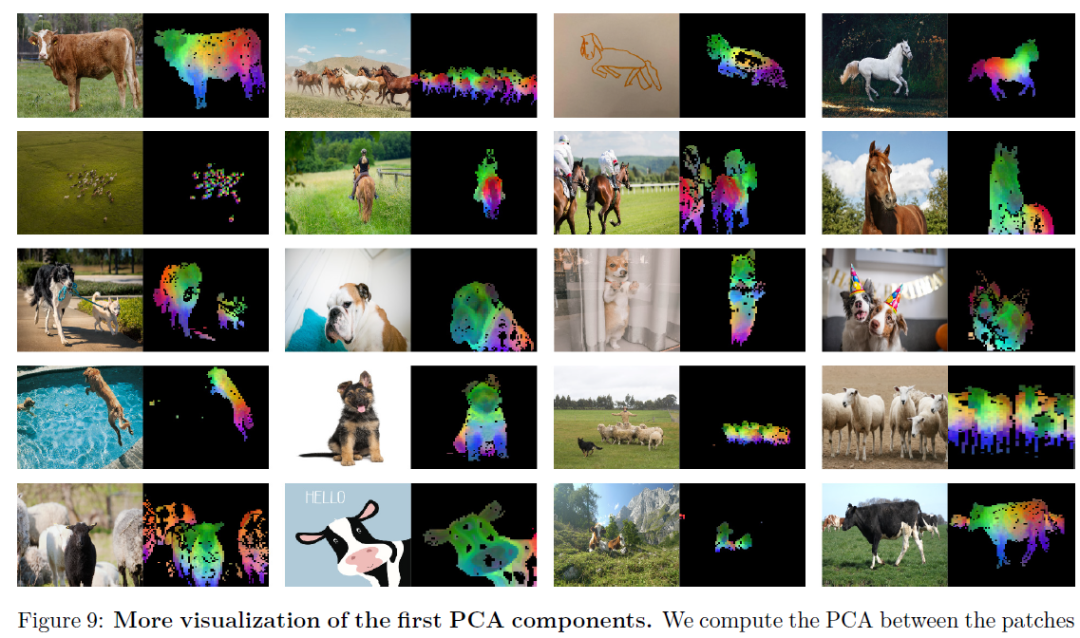
DINOv2是DINO系列模型的改进版本,facebook在各种计算机视觉基准测试中验证了DINOv2的质量,无论是图像级别还是像素级别,DINOv2都是很好实现零样本自动提取图像特征、自动分析图像主要特征分别以Patch形式呈现,这些特征与最优秀的公开可用各种监督模型相当,可以说是非常牛逼。论文中的基于DINOv2实现的PCA分析图示如下:
DINOv2是自监督学习集大成者,基于无标签完成模型训练,它的数据处理流程如下:
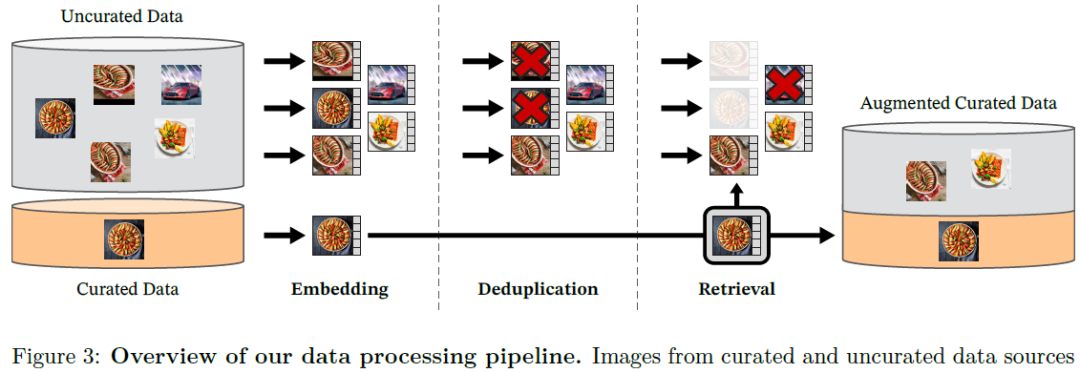
首先,从精选和非精选数据源获取的图像被映射到嵌入。然后,未经筛选的图像是去重处理后与精选图像进行匹配的。这种结果组合通过自监督检索系统增强了初始数据集。
DINO网络
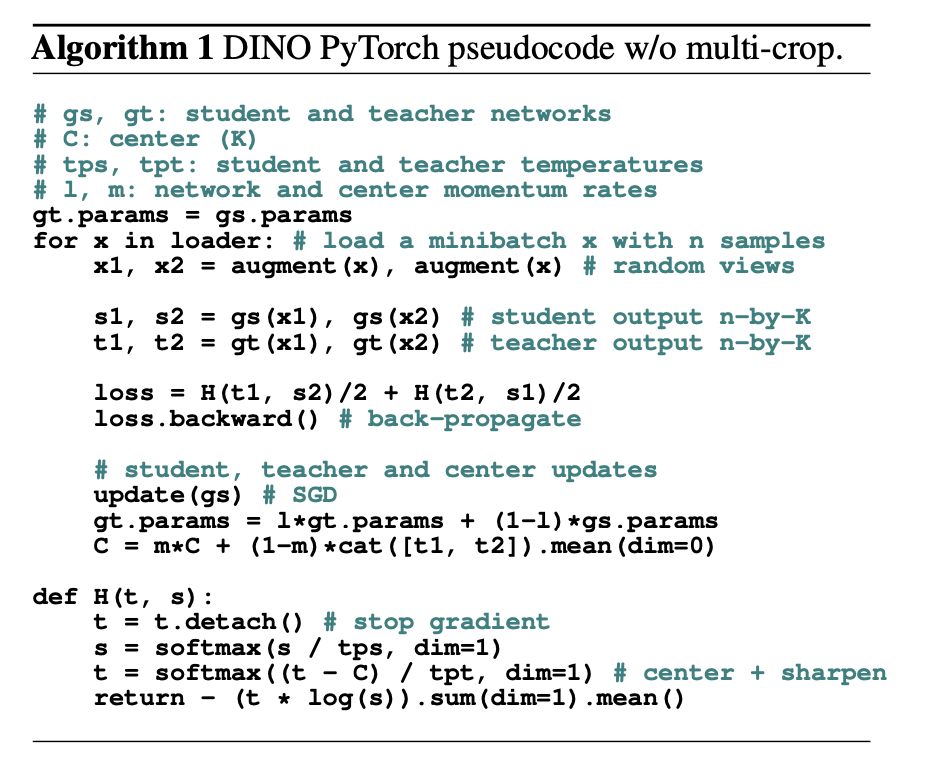
DINO网络通过一种被称为“自蒸馏”的过程进行学习。教师和学生网络都具有相同的架构,即Vision Transformer(ViT)。教师的权重是学生权重的指数加权平均值。在训练过程中为了避免因为网络结构与输出相同,导致输出相同的内容而产生模式崩塌,因此采用了动量教师的概念,目的是在教师和学生相同且输出相同嵌入的情况下防止模式崩溃,而无论输入是什么。它们之间的损失计算如下:
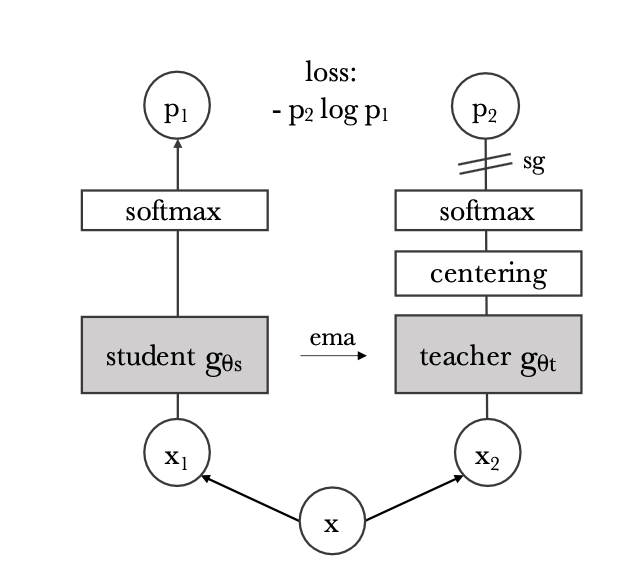
论文中给出的DINO伪代码
不同视觉任务上与其他模型的效果对比:
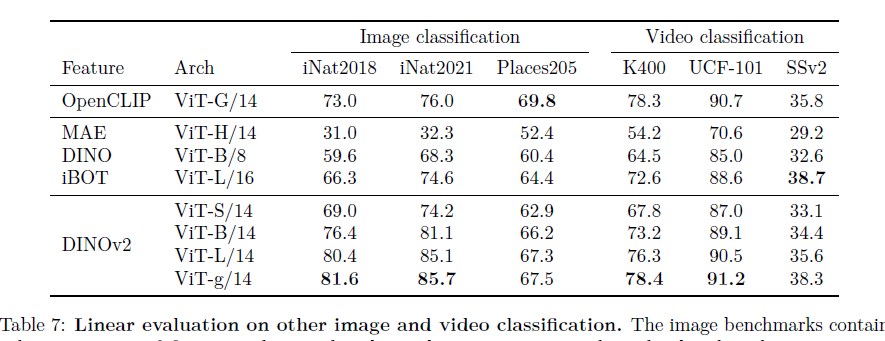
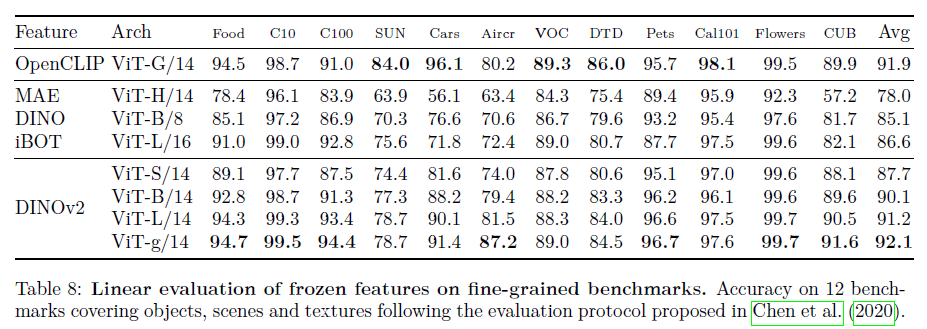
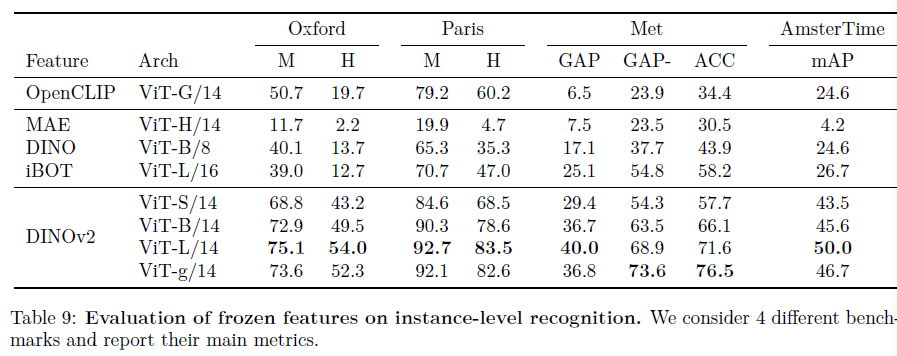
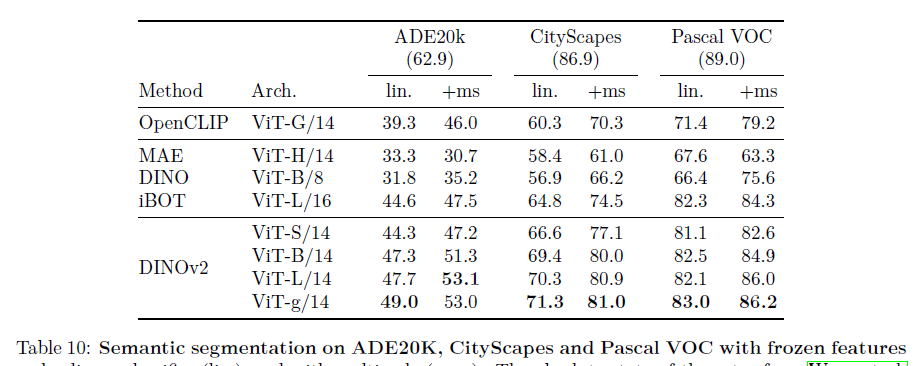
无论是在分类、图像细粒度特征提取、实例分割、语义分割等方面都表现超过其他同类模型。这些都不算,最可怕的它还可以支持直接从单张图像中生成深度信息
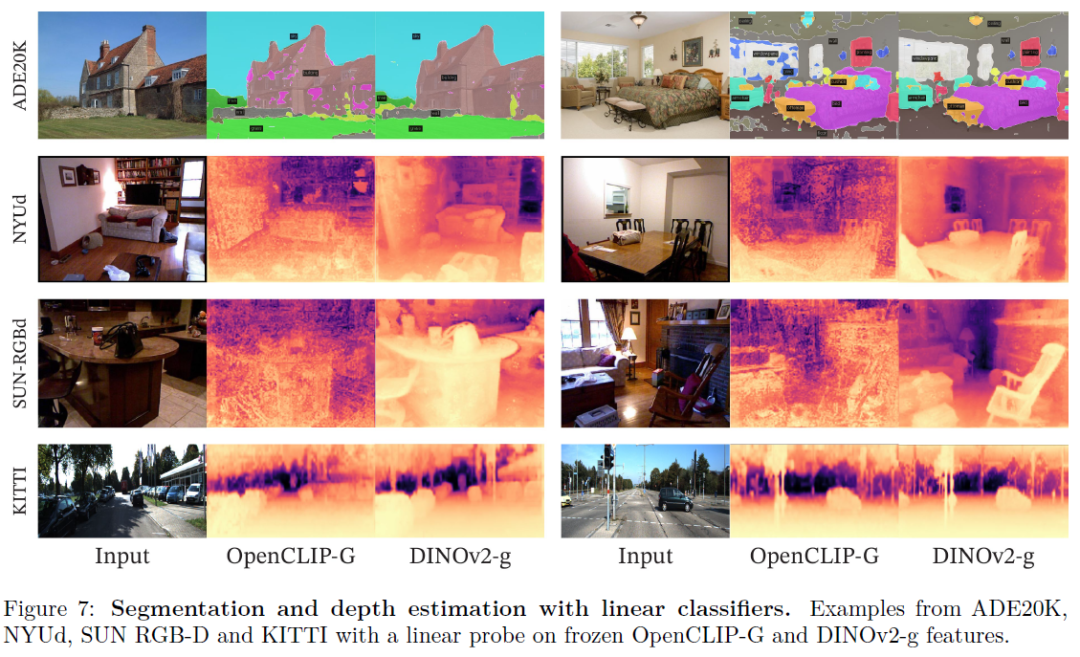
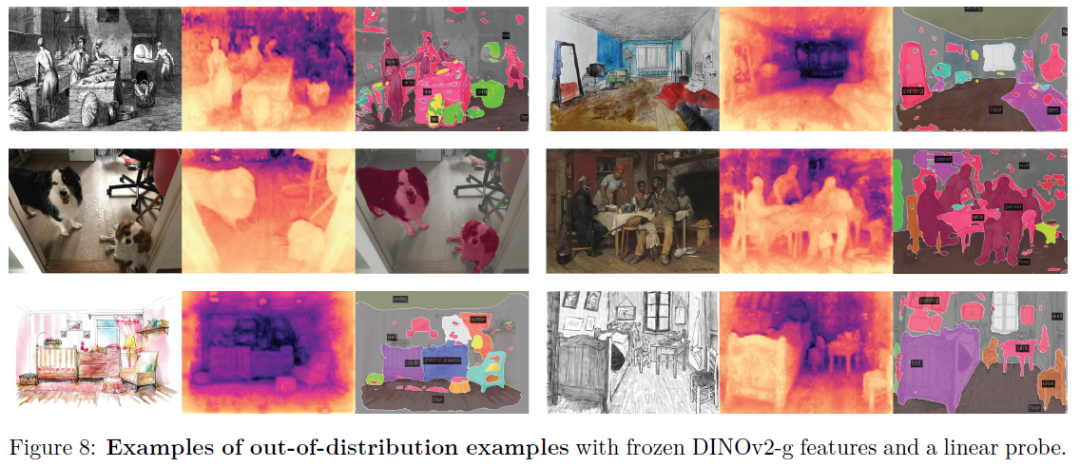
可视化的PCA特征分析
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-07-18,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号