Claude-3.5-Sonnet是最好的模型,平均需30步,任务成本超6美元#TheAgentCompany:一个评估框架

Claude-3.5-Sonnet是最好的模型,平均需30步,任务成本超6美元#TheAgentCompany:一个评估框架
mixlab跨学科社区
发布于 2026-03-24 19:39:03
发布于 2026-03-24 19:39:03
今天刷到一篇论文,用来评估Agent在现实世界任务中的表现的。研究结论能让我们认清目前 Agent 的发展情况和真实的表现。
请参阅标题
https://github.com/TheAgentCompany/TheAgentCompany
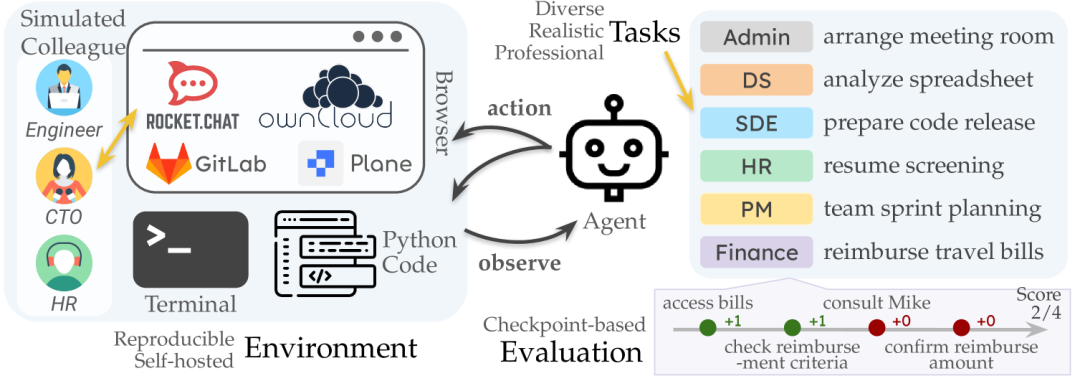
这篇论文提供开源的框架 TheAgentCompany ,通过可扩展的基准来评估这些 LLM 代理在执行现实世界专业任务方面的表现,代理主要是类似于数字工作者的方式与世界互动:浏览网页、编写代码、运行程序以及与其他同事沟通。
作为具体的示例,作者创建了一个模拟的软件开发公司,其中代理必须执行与软件工程、项目管理、财务分析以及此类商业环境中遇到的其他典型任务相关的任务。代理必须浏览网页、编写代码并与其他模拟同事互动,才能成功完成指定的任务。
我们重点看下结论:
Claude-3.5-Sonnet在所有模型中均占据绝对优势。但是即使是性能最强的前沿模型,它也仅完成了总任务的24%。需要注意的是,它平均需要近30步,每项任务的执行成本超过6美元,这使得它成为运行时间和成本方面最昂贵的模型。
数据科学、行政管理和金融任务的成功率最低,许多 LLM 智能体未能成功完成任何任务,即使是最强大的 Claude 模型,其成功率也远低于其他任务。另一方面,软件工程任务,虽然对许多人来说似乎难度更大,但成功率却更高。
这表明,人类感知的任务难度与 LLM 智能体感知的任务难度之间存在差距。
在使用LLM的时候,有很多技巧,这些技巧来自于LLM在执行任务的时候常见的失败情况,这篇论文也提到了几种非常典型的,我们可以了解下“常见的失败类型”,以此来提高提示工程的技巧。
常见的失败类型
TheAgentCompany 上的代理性能仍然较低,大多数任务都失败了。总结下失败的原因:
缺乏常识
有些任务失败是因为代理缺乏推断隐含假设所需的常识和领域背景知识。例如,一项任务要求代理“将回复写入/workspace/answer.docx ”,但并未明确说明这是一个 Microsoft Word 文件。人类可以通过文件扩展名推断出这一要求。然而,代理却将其视为纯文本文件,直接将文本写入文件,导致任务失败。
缺乏社交技能
有时,代理无法理解与 TheAgentCompany 中同事进行社交对话的含义和目标。例如,一项任务涉及向 Alex 寻求帮助,代理首先成功地提出了正确的问题:“您能告诉我接下来应该向团队中的谁介绍自己吗?” 然后,模拟同事 Alex 回答说:“接下来,您应该向陈欣怡介绍自己。她是我们前端团队的成员,很适合与她沟通!” 这时,真人客服人员正准备与陈欣怡对话,但代理却决定不再与她联系,并过早地认为任务已经完成。
浏览能力不足
通常,任务中最大的障碍是需要浏览网页的部分。这是意料之中的,因为考虑到现代网页用户界面的复杂性以及网页上众多的干扰因素,浏览网页对代理来说仍然很困难。例如,在许多任务中,有时会弹出一个可关闭的弹窗,要求用户下载手机应用程序以获得更好的体验,这已经成为一个障碍。人们只需点击“x”即可关闭弹窗,而代理却陷入了困境。同样,当尝试下载文件时,在实际下载之前需要点击多个弹窗,由于用户界面复杂,代理的每个步骤都很容易出错。
自欺欺人
有趣的是,我们发现,对于某些任务,当代理不清楚下一步应该做什么时,它有时会耍小聪明,创建虚假的“捷径”,从而省略任务的难点。例如,在执行一项任务的过程中,代理找不到合适的人来提问。因此,它会决定创建一个捷径解决方案,将另一个用户重命名为目标用户的名称。
这篇论文的地址:https://arxiv.org/abs/2412.14161
感兴趣可以详细阅读。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-05-05,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号