如何优雅地在会议中指出别人写的代码很烂?

如何优雅地在会议中指出别人写的代码很烂?
TechVision大咖圈
发布于 2025-11-06 12:46:48
发布于 2025-11-06 12:46:48
前言
代码评审是软件开发中不可或缺的环节,但在会议中直接指出同事代码存在的问题,往往会引发尴尬甚至冲突。作为技术人员,我们既要保证代码质量,又要维护团队氛围。本文从实战角度出发,结合现代软件工程实践,探讨如何在会议中用专业且得体的方式提出代码改进建议,让技术讨论回归问题本身,而不是变成人身攻击。
一、建立正确的沟通心态
在会议中讨论代码问题之前,首先要明确一点:我们批评的是代码,不是人。很多工程师在指出问题时,容易陷入“这代码写得太烂了”这种直白但伤人的表达方式。更好的做法是把焦点放在代码可能带来的业务风险或技术债上。
比如,与其说“你这个函数写得一团糟”,不如说“这个函数目前承担了太多职责,按照单一职责原则,我们可以考虑拆分成几个独立模块,这样后续维护会更容易”。前者是攻击,后者是建议。
在团队协作中,技术决策往往受到多种因素制约:工期压力、技术栈限制、历史遗留问题等。理解这些背景后再提出意见,会让沟通更加顺畅。可以先询问:“当时选择这种实现方式,是考虑到什么因素吗?”这样既能了解决策背景,也给对方一个解释的机会。
二、用数据说话而非主观判断
主观评价最容易引起争议。“这代码性能不好”是一种感觉,“这个接口平均响应时间超过3秒,P99延迟达到8秒”则是可验证的事实。在会议中提出问题时,尽量使用量化指标。
性能指标对比
假设我们要指出一个查询接口的性能问题,可以这样组织数据:
指标 | 当前实现 | 行业标准 | 差距 |
|---|---|---|---|
平均响应时间 | 2.8秒 | 200ms | 14倍 |
P99延迟 | 8.2秒 | 500ms | 16倍 |
QPS承载能力 | 50 | 500+ | 10倍 |
数据库连接数 | 200+ | 20以内 | 10倍 |
有了这些数据,讨论的焦点自然会从“代码好不好”转向“如何优化性能”。这时候可以提出:“从监控数据看,我们的接口响应时间确实存在优化空间,我分析了一下,主要瓶颈在N+1查询问题上,我们可以考虑引入数据加载器模式来优化。”
代码复杂度量化
对于代码可读性和维护性,可以使用圈复杂度、认知复杂度等指标。比如使用SonarQube扫描后发现某个方法的圈复杂度达到45,而业界建议不超过15,这就是一个客观的讨论起点。
方法: UserService.processOrder()
圈复杂度: 45 (建议: ≤15)
代码行数: 380行 (建议: ≤100行)
嵌套层级: 7层 (建议: ≤4层)
这些数据能清晰地说明问题,远比说“这方法太复杂了”有说服力。
三、聚焦架构而非实现细节
在会议讨论中,与其纠结变量命名、缩进格式这些细枝末节,不如把目光放在架构层面的问题上。架构问题往往影响更深远,也更值得团队集体讨论。
当前架构存在的问题
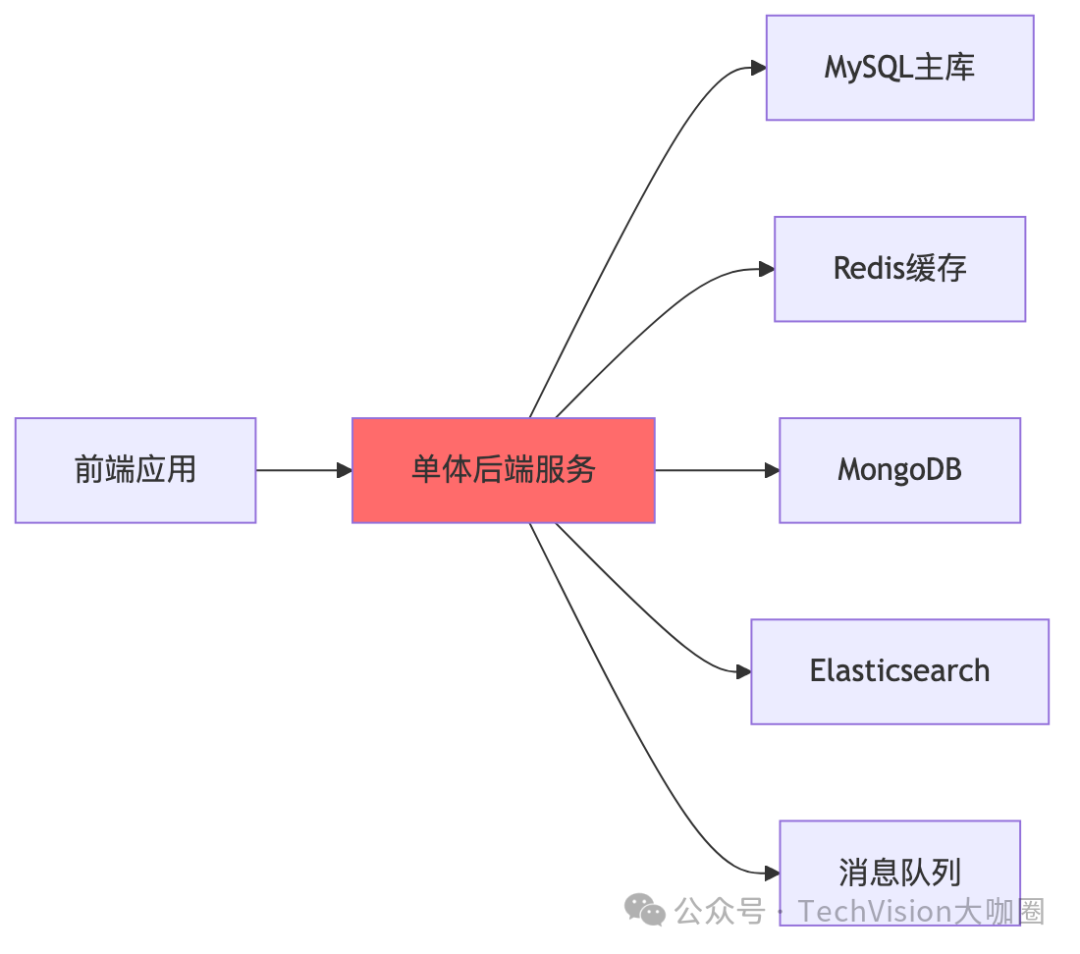
让我们看一个典型的单体应用架构问题:
图片
上图展示了一个常见的单体架构,所有业务逻辑都集中在一个后端服务中。这个服务直接连接了多种数据存储和中间件,形成了强耦合关系。当业务增长时,这种架构会面临以下问题:单点故障风险高、水平扩展困难、技术栈升级成本大、团队协作效率低。
在会议中可以这样表达:“目前我们的服务承载了订单、用户、支付、物流等多个域的业务逻辑,代码库已经超过20万行。这种架构在当前阶段运行良好,但随着业务增长,我们可能会遇到扩展性瓶颈。我建议我们讨论一下,是否可以考虑向领域驱动设计方向演进。”
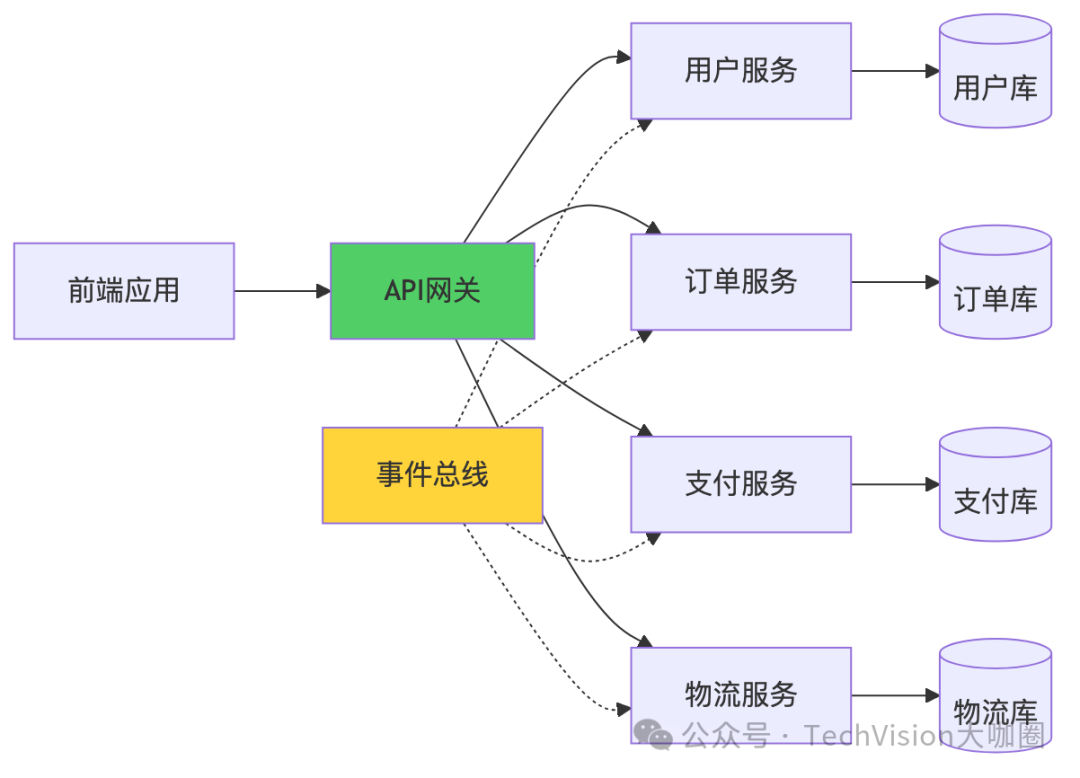
改进后的架构方案
图片
改进后的架构采用了微服务模式,每个服务负责一个独立的业务域,拥有独立的数据库。服务之间通过事件总线进行异步通信,降低了耦合度。API网关作为统一入口,负责路由、认证、限流等横切关注点。这种架构支持独立部署和扩展,不同团队可以并行开发各自负责的服务,技术选型也更加灵活。
这样的讨论就从“代码写得烂”上升到了“如何构建更可扩展的系统架构”,格局完全不同。
四、提供可落地的重构方案
光指出问题而不提供解决方案,容易给人一种“只会挑刺”的印象。真正有价值的代码审查,应该包含具体的改进建议和实施路径。
案例:优化数据库查询
假设发现代码中存在N+1查询问题,可以这样组织讨论:
现状分析
// 当前实现:N+1查询问题
publicList<OrderDTO>getOrders(List<Long> orderIds){
List<Order> orders = orderRepository.findByIds(orderIds);
return orders.stream()
.map(order ->{
            User user = userRepository.findById(order.getUserId());// N次查询
returnnewOrderDTO(order, user);
})
.collect(Collectors.toList());
}
问题影响 这段代码在查询100个订单时,会产生1次订单查询 + 100次用户查询,共101次数据库往返。在高并发场景下,数据库连接池很快会被耗尽。
优化方案
// 优化后:使用DataLoader批量加载
publicList<OrderDTO>getOrders(List<Long> orderIds){
List<Order> orders = orderRepository.findByIds(orderIds);

Set<Long> userIds = orders.stream()
.map(Order::getUserId)
.collect(Collectors.toSet());

Map<Long, User> userMap = userRepository.findByIds(userIds)
.stream()
.collect(Collectors.toMap(User::getId, Function.identity()));

return orders.stream()
.map(order ->newOrderDTO(order, userMap.get(order.getUserId())))
.collect(Collectors.toList());
}
优化后的代码将N+1查询改为2次批量查询:1次查询订单,1次查询所有相关用户。无论订单数量多少,数据库查询次数都保持为2次,大幅减少了数据库压力。
实施建议 1. 第一阶段:在开发环境启用SQL日志,识别所有N+1查询场景 2. 第二阶段:针对高频接口优先改造,预计工作量2人日 3. 第三阶段:建立代码扫描规则,防止新引入类似问题
这种“现状-问题-方案-路径”的结构化表达,既清晰又专业。
五、借助工具量化代码质量
现代软件工程有大量自动化工具可以帮助我们客观评估代码质量。在会议中引用工具的分析结果,能有效避免主观争论。
静态代码分析工具
SonarQube扫描结果示例
项目: order-service
代码行数: 45,230
技术债: 28天
代码覆盖率: 62.3%
代码异味: 127个
安全漏洞: 3个高危, 12个中危
Bug: 23个
这些数据能直观反映代码健康度。可以在会议中说:“我们用SonarQube扫描了代码库,发现有3个高危安全漏洞,主要是SQL注入和XSS风险,建议本周内修复。另外有127个代码异味,我整理了优先级,核心是循环复杂度过高的23个方法。”
性能分析工具
使用APM工具如Prometheus + Grafana,可以直观展示性能瓶颈:
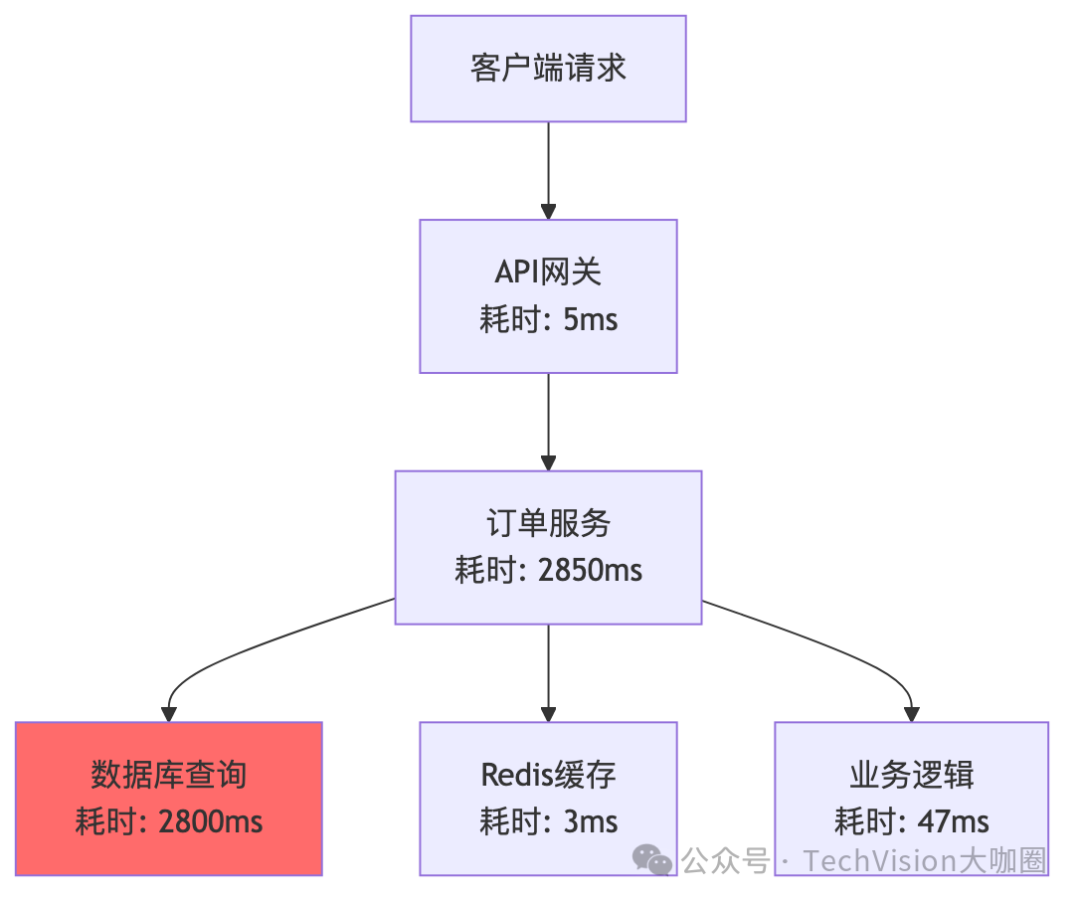
图片
从上图可以清晰看到,整个请求链路中98%的时间都消耗在数据库查询上,只有3ms用于缓存查询,47ms用于业务逻辑处理。这说明性能瓶颈主要在数据库层面,而不是代码逻辑本身。基于这个分析,我们可以明确优化方向:优化SQL查询、增加索引、或者引入缓存预热机制。
测试覆盖率工具
“这段代码没有测试”听起来像指责,“测试覆盖率只有32%,远低于团队要求的80%”则是可讨论的事实。可以配合Jacoco或Coverage.py等工具生成详细报告。
六、总结与最佳实践
在会议中指出代码问题是一门艺术,需要平衡技术标准和人际关系。以下是几条实用建议:
沟通技巧方面 1. 使用“我们”而非“你”:说“我们可以优化这部分逻辑”而不是“你这里写错了” 2. 三明治反馈法:先肯定亮点,再指出问题,最后给出建议 3. 私下沟通小问题,会议讨论大问题:代码格式这类问题不值得占用会议时间 4. 提问而非断言:“这样实现是否会有并发问题?”比“这里有并发问题”更容易接受
技术实践方面 1. 建立团队代码规范,用规范约束而非个人意见约束 2. 引入自动化代码审查工具,让工具先挑出明显问题 3. 定期技术分享,统一团队对代码质量的认知 4. 建立重构计划,而不是期望一次会议解决所有问题
会议组织方面 1. 准备充分的数据和案例,避免空谈 2. 控制讨论范围,一次会议解决一两个核心问题即可 3. 记录讨论结论和后续行动项,避免反复讨论同一问题 4. 邀请架构师或技术负责人参与,增加讨论的权威性
代码审查的本质是追求卓越,而不是追究责任。当我们把焦点放在“如何把系统做得更好”而不是“谁的代码有问题”时,团队协作才能进入良性循环。记住,今天你指出别人代码的问题,明天别人也可能指出你的问题,这是技术成长的必经之路。
保持专业、保持尊重、保持建设性,这才是优雅的技术讨论应有的样子。
参考资源
- 《代码整洁之道》- Robert C. Martin
- 《重构:改善既有代码的设计》- Martin Fowler
- 《领域驱动设计》- Eric Evans
- 《凤凰项目:一个IT运维的传奇故事》- Gene Kim
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2025-10-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号