【愚公系列】《Python网络爬虫从入门到精通》030-DataFrame数据的清洗
原创
【愚公系列】《Python网络爬虫从入门到精通》030-DataFrame数据的清洗
原创
愚公搬代码
发布于 2025-09-16 00:58:14
发布于 2025-09-16 00:58:14
在这里插入图片描述
💎【行业认证·权威头衔】
✔ 华为云天团核心成员:特约编辑/云享专家/开发者专家/产品云测专家
✔ 开发者社区全满贯:CSDN博客&商业化双料专家/阿里云签约作者/腾讯云内容共创官/掘金&亚马逊&51CTO顶级博主
✔ 技术生态共建先锋:横跨鸿蒙、云计算、AI等前沿领域的技术布道者
🏆【荣誉殿堂】
🎖 连续三年蝉联"华为云十佳博主"(2022-2024)
🎖 双冠加冕CSDN"年度博客之星TOP2"(2022&2023)
🎖 十余个技术社区年度杰出贡献奖得主
📚【知识宝库】
覆盖全栈技术矩阵:
◾ 编程语言:.NET/Java/Python/Go/Node...
◾ 移动生态:HarmonyOS/iOS/Android/小程序
◾ 前沿领域:物联网/网络安全/大数据/AI/元宇宙
◾ 游戏开发:Unity3D引擎深度解析
🚀前言
在数据分析的过程中,数据清洗往往是最重要也是最耗时的环节之一。原始数据往往会包含缺失值、重复项、异常值等各种问题,这些问题如果不加以处理,可能会影响后续分析的准确性和可靠性。Pandas库中的DataFrame对象为我们提供了强大的数据清洗功能,使得这一过程变得更加高效和便捷。
本文将深入探讨DataFrame数据清洗的基本方法和技巧,包括处理缺失数据、去除重复项、转换数据类型以及应对异常值等常见问题。通过具体示例,我们将帮助你掌握如何利用Pandas对数据进行有效的清洗,从而为后续的数据分析打下坚实的基础。
🚀一、DataFrame数据的清洗
数据清洗是数据分析的关键步骤,主要包括处理缺失值(NaN)和去除重复数据。
🔎1.NaN数据处理
🦋1.1 修改元素为NaN
使用 numpy.nan 将指定元素标记为缺失值:
import pandas as pd
import numpy as np

data = {'A': [1, 2, 3, 4, 5], 'B': [6, 7, 8, 9, 10], 'C': [11, 12, 13, 14, 15]}
df = pd.DataFrame(data)
df.loc[0, 'A'] = np.nan  # 将第1行A列设为NaN
print(df)
输出:
     A  B   C
0  NaN  6  11
1  2.0  7  12
2  3.0  8  13
3  4.0  9  14
4  5.0 10  15
🦋1.2 统计NaN数据
isnull():识别NaN(返回布尔值表格)。notnull():识别非NaN(返回布尔值表格)。
print('每列NaN数量:\n', df.isnull().sum())
print('每列非NaN数量:\n', df.notnull().sum())
输出:
每列NaN数量:
A    1
B    0
C    0
dtype: int64

每列非NaN数量:
A    4
B    5
C    5
dtype: int64
🦋1.3 筛选NaN元素
使用 dropna() 删除包含NaN的行或列:
# 删除包含NaN的行(默认axis=0)
df.dropna(inplace=True)
print(df)

# 删除所有元素均为NaN的列(axis=1, how='all')
df.dropna(axis=1, how='all', inplace=True)
输出:
     A  B   C
1  2.0  7  12
2  3.0  8  13
3  4.0  9  14
4  5.0 10  15
🦋1.4 替换NaN元素
使用 fillna() 替换NaN为指定值:
# 全局替换为0
df.fillna(0, inplace=True)

# 按列替换(A列替换为0,B列替换为1,C列替换为2)
replace_dict = {'A': 0, 'B': 1, 'C': 2}
df.fillna(replace_dict, inplace=True)
替换前:
     A  B   C
0  NaN  6  11
1  2.0  7  12
2  3.0  8  13
3  4.0  9  14
4  5.0 10  15
替换后:
     A  B   C
0  0.0  6  11
1  2.0  7  12
2  3.0  8  13
3  4.0  9  14
4  5.0 10  15
🔎2.去除重复数据
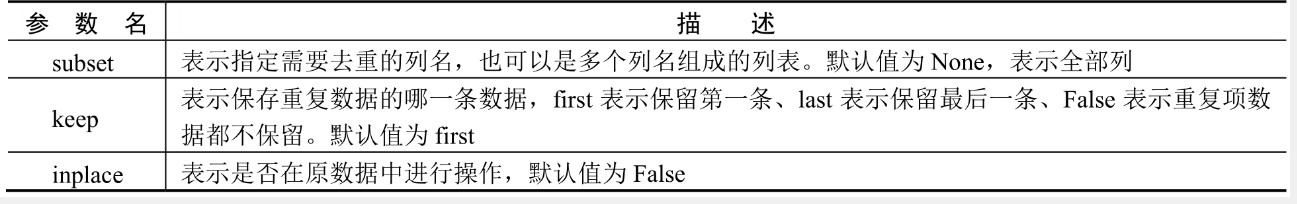
使用 drop_duplicates() 方法去除重复行。

在这里插入图片描述
在这里插入图片描述
🦋2.1 去除单列重复
data = {'A': ['A1', 'A1', 'A3'], 'B': ['B1', 'B2', 'B1']}
df = pd.DataFrame(data)
df.drop_duplicates(subset='A', inplace=True)  # 保留A列第一条重复数据
print(df)
输出:
    A   B
0  A1  B1
2  A3  B1
🦋2.2 去除多列重复
data = {'A': ['A1', 'A1', 'A1', 'A2', 'A2'],
        'B': ['B1', 'B1', 'B3', 'B4', 'B5'],
        'C': ['C1', 'C2', 'C3', 'C4', 'C5']}
df = pd.DataFrame(data)
df.drop_duplicates(subset=['A', 'B'], inplace=True)  # 保留A+B列组合第一条重复数据
print(df)
输出:
    A   B   C
0  A1  B1  C1
2  A1  B3  C3
3  A2  B4  C4
4  A2  B5  C5
🦋2.3 删除所有重复行
data = {'A': ['A1', 'A1', 'A1', 'A1', 'A2'],
        'B': ['B1', 'B1', 'B3', 'B3', 'B5'],
        'C': ['C1', 'C1', 'C3', 'C3', 'C5']}
df = pd.DataFrame(data)
df = df.drop_duplicates()  # 删除所有完全重复的行
print(df)
输出:
    A   B   C
0  A1  B1  C1
2  A1  B3  C3
4  A2  B5  C5
🦋2.4 关键参数说明
subset:指定去重的列(默认所有列)。keep:保留策略(first保留第一条,last保留最后一条,False删除所有重复)。inplace:是否直接修改原数据(默认False返回新对象)。
🔎3.总结
- NaN处理:通过标记、删除或替换处理缺失值,确保数据完整性。
- 去重操作:根据业务需求选择单列或多列去重,避免冗余数据影响分析结果。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号