从数据字典来看,数据治理该怎么做?
原创
从数据字典来看,数据治理该怎么做?
原创
帆软BI
发布于 2025-08-18 10:58:30
发布于 2025-08-18 10:58:30
凌晨两点,数据团队还在为“用户活跃度”吵得不可开交。
分析师说:“活跃用户就是7天内登录过的人”,
后端开发翻出数据库表结构怼回去:“登录日志表只存最近30天的记录,你说的7天逻辑根本跑不了”。
运营同事插了句嘴:“我们后台算活跃用户,还得加上消费行为呢,你们技术文档里怎么没写?”
估计90%的数据团队都遇到过这种事。表面看是大家对指标的理解不一样,其实是数据字典没起作用——这个被大家叫做“数据库说明书”的东西,早就跟不上业务变化了。
数据治理喊了这么多年,为啥总在执行上卡壳?
说白了,很多人光盯着ETL流程、数据质量监控这些看得见的活儿,却忘了最底层的“数据语言”。数据字典才是数据治理的根基,所有治理动作都得从这儿开始。
一、数据字典到底是啥?
要搞懂数据字典的价值,得先看看它是怎么来的:
20年前,
- 企业用Excel管数据,字段名可能是“A001”“客户姓名”;
- 上了ERP系统,表结构变成“CUST_NAME”“LAST_LOGIN_DT”;
- 后来数据中台上线,又多了“用户分群标签”“行为事件编码”……
说白了,数据字典就是为了解决“数据语言不通”的问题:
- 技术人员用“DT”表示日期类型,业务人员得知道这对应“交易日期”;
- 后端存的是“USER_LEVEL=3”,前端得明确这是“黄金会员”。
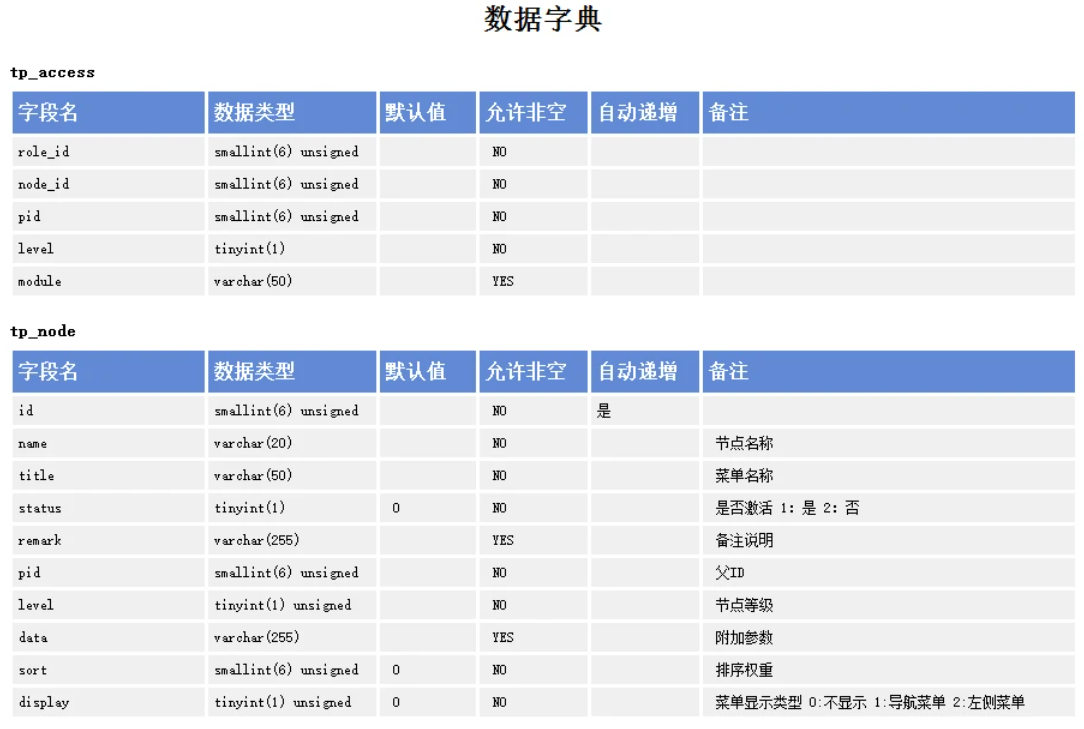
但现实中,很多企业的数据字典成了“摆设”:
- 技术团队写字段注释,就只写“用户标识”,但不说明这到底是手机号、设备ID还是会员ID;
- 业务团队新增了“高净值客户”标签,却不更新到字典里,分析师取数时只能瞎猜;
- 跨部门协作更头疼,销售说的“订单金额”含税费,财务说的“订单金额”不含税费,但字典里就写个“订单总金额”,谁也不知道该按哪个来。
数据治理的核心问题,从来不是技术不够强,而是业务和技术对“数据到底是啥”没达成一致。
所以我总说,数据字典不是单纯的技术文档,是双方的“约定”:
- 技术团队按约定存数据,
- 业务团队按约定用数据,
治理的所有动作,都得围绕“守住这个约定”来做。
二、数据字典的四个核心部分
一份能用的数据字典,至少得包含四个核心部分:
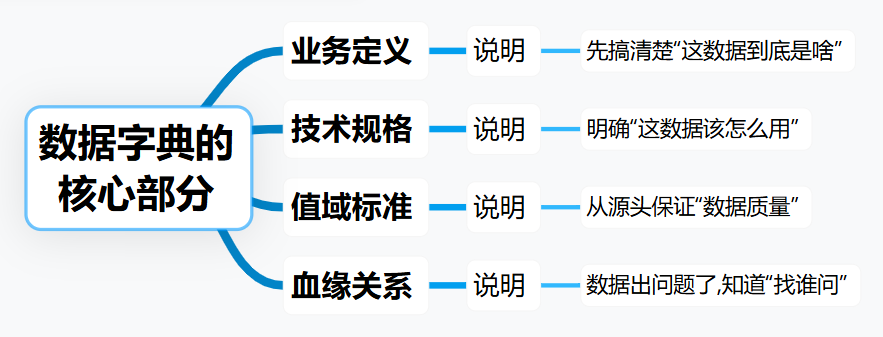
哪部分缺了或者说不清楚,数据治理肯定推不下去。
下面,咱们一个个说:
1. 业务定义:先搞清楚“这数据到底是啥”
之前找我咨询的一家零售企业,“复购率”指标总出错,后来一查才发现:
- 业务部门说“复购是90天内买2次以上”;
- 技术团队按“30天内买2次以上”开发的;
- 数据字典里就写了“复购率=复购用户数/总用户数”,没说清楚时间多久、买几次才算。
这就是典型的“业务定义没说透”。
所以数据字典里的业务定义,必须说清三个事:
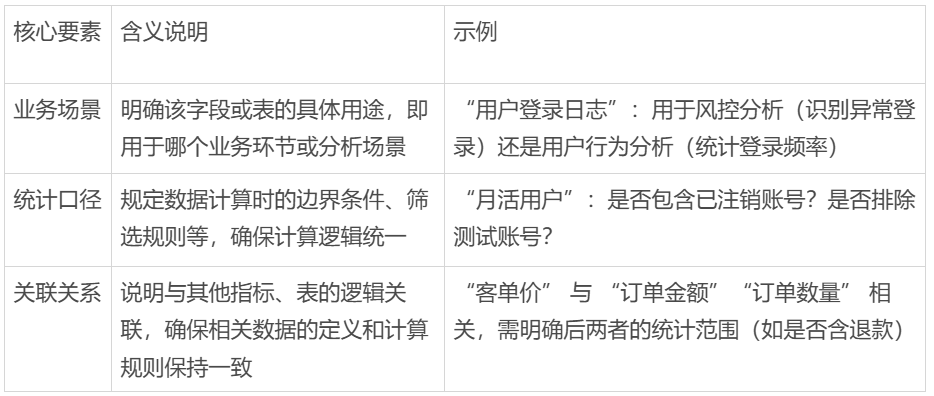
治理的时候,就得建个“业务术语库”:
每个数据字段都得关联具体业务场景,让业务负责人和技术负责人一起确认口径。
2. 技术规格:明确“这数据该怎么用”
技术规格这部分,最容易被忽略,但直接影响数据能不能用。
它必须说清楚这些:
- 数据类型:字段是字符串(VARCHAR)、数值(INT)还是日期(DATE)?
- 长度/精度:字符串最多能存多少字符?数值保留几位小数?比如“手机号”得是11位,“金额”得保留2位小数,这些都得明确;
- 存储方式:是分区表还是全量表?是增量更新还是全量覆盖?比如日志表按天分区,订单表按小时增量,这些规则也得写清楚。
治理的时候,就得在元数据管理工具(比如Apache Atlas、阿里DataWorks)里,强制要求填技术规格。
而且开发人员建表时:
必须选好字段类型、长度这些,别等到数据乱了再治理,那可就麻烦了。
具体怎么做?
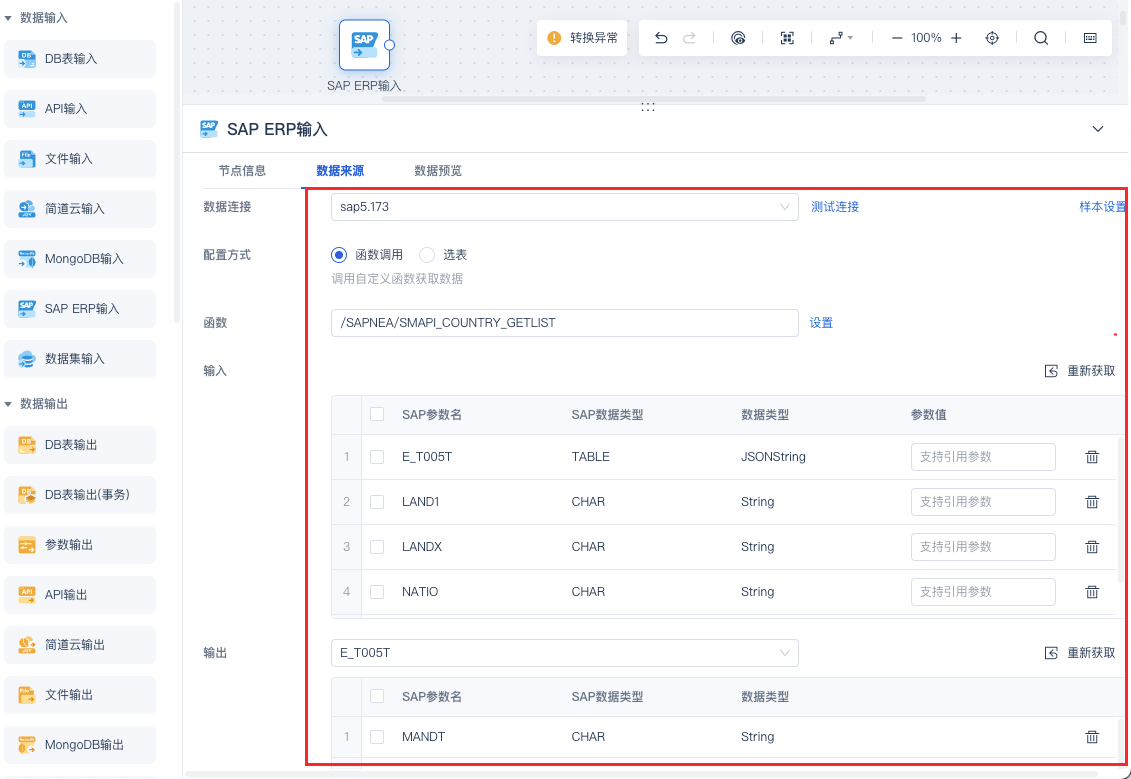
可以借助数据集成与治理工具FineDataLink,通过 RFC 接口调用 SAP 系统内已经开发好的函数、「选表」,将数据取出。取出后的数据进行数据开发后落库,可以使用「数据转换」中的「SAP ERP输入」。也可以直接落库,使用「数据同步」即可。
3. 值域标准:从源头保证“数据质量”
值域标准其实是数据质量的第一道关口,得说清楚:
- 枚举值列表:这个字段能填哪些值?比如“性别”,只能是'M'/'F'/'未知',不能填'先生'/'女士';
- 校验规则:数值有没有范围限制?比如“年龄”,得在0到150之间,总不能出现负数或者几百岁吧;
- 默认值定义:没输入的时候用啥填充?比如“注册渠道”没填,就默认写'未知',别空着。
治理的时候,就得建“值域字典表”:
用数据库约束(比如CHECK约束)或者ETL规则,把不合规的值拦下来。
就拿电商的“商品类目”来说:
必须关联到一级、二级类目编码,不能让大家随便输入,不然肯定乱。
4. 血缘关系:数据出问题了,知道“找谁问”
血缘关系就像数据的“家谱”,得说清楚:
- 上游依赖:这个表的字段来自哪些库表?比如“用户标签表”里的“消费频次”,是从“订单表”的“订单时间”和“用户ID”算出来的;
- 下游应用:这个表被哪些场景用了?比如“会员等级表”,营销系统、客服系统、数据分析平台都在用;
- 变更影响:改了字段名或者类型,会影响哪些下游?比如删了“用户手机号”字段,短信营销任务可能就全废了。
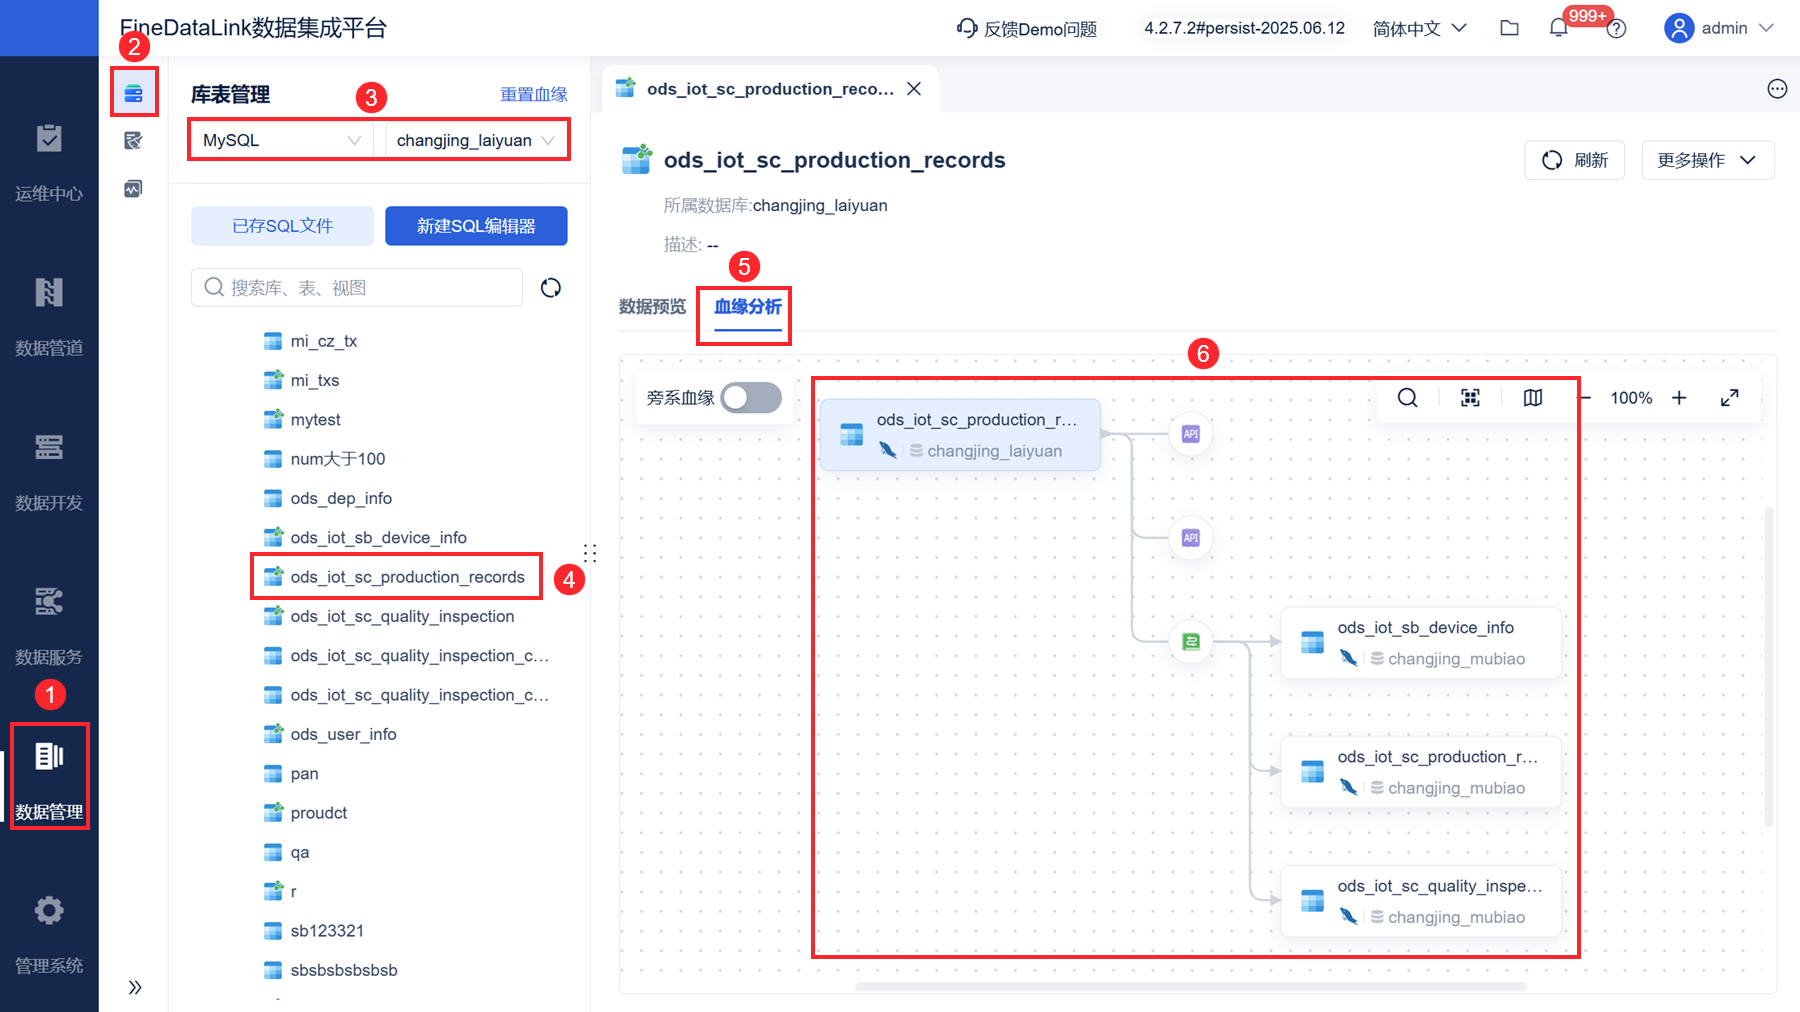
治理的时候,通过FineDataLink可以通过解析SQL日志、ETL任务配置等,自动采集血缘关系,并且可视化展示出来。
这样数据出问题时:
能快速找到“问题字段→影响表→下游应用”的链路,把排查时间从几小时缩到几分钟。
三、从数据字典到数据治理,三步就能落地
数据字典不是建一次就完事的,得跟着业务变,一直维护。用过来人的经验告诉你,数据治理的落地可以分三个阶段:
1. 先“扫雷”:把数据字典的基础补全
如果企业数据基础比较差,第一步就得“抢救式”梳理现有数据:
- 用元数据扫描工具,自动把数据库表结构、字段注释这些信息采出来;
- 组织业务、技术、运营一起开会,把GMV、DAU这些常用指标的业务定义和技术规格对齐;
- 对那些值域乱的字段(比如“用户等级”“商品类目”),赶紧定统一的编码规范,比如一级类目用2位数字,二级用4位。
关键是得设个“数据字典管理员”:
可以让数据治理专员兼任,他负责审核新增或修改的条目,确保符合规范。
2. 再“固化”:让数据字典融入日常工作
数据治理做得好的企业,都是让规范成了习惯。把数据字典放进数据生产的全流程,就能从“被动维护”变成“主动治理”:
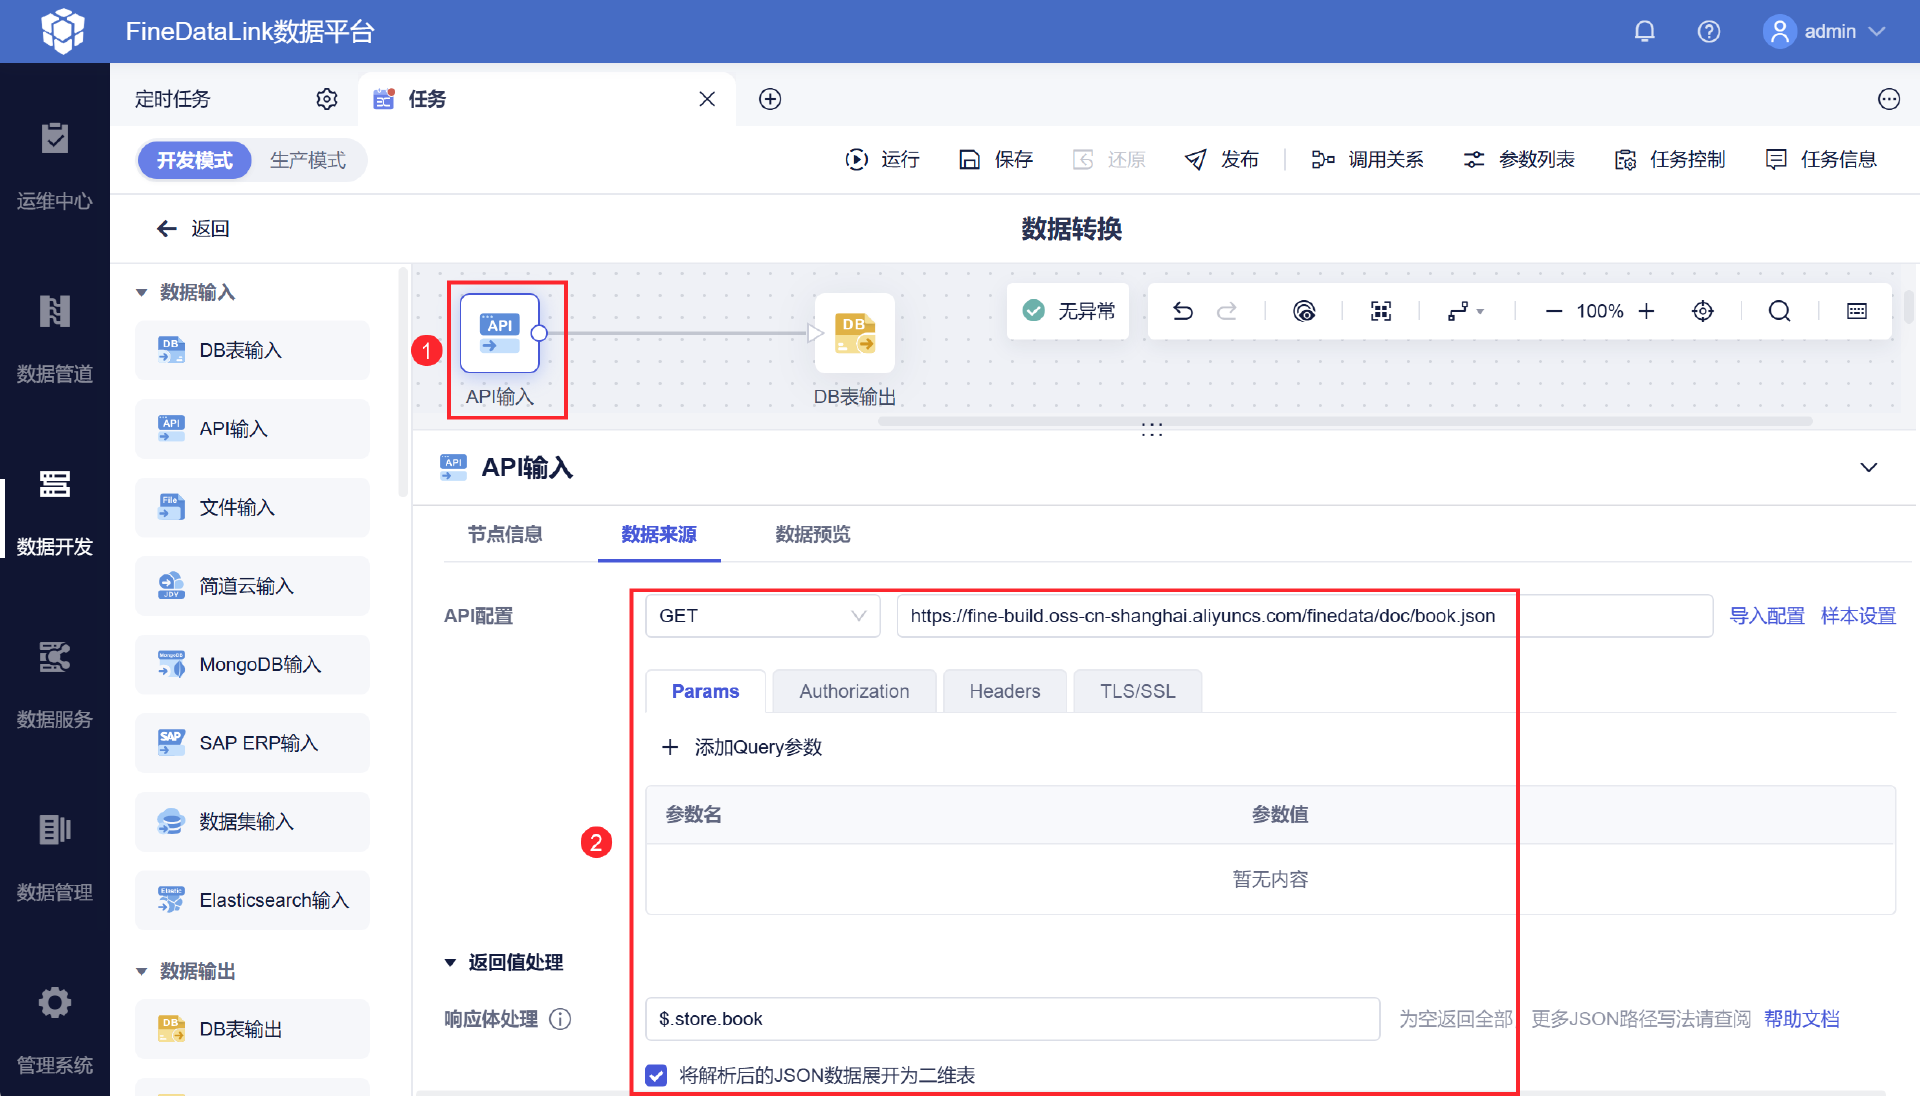
- 开发阶段:建表时必须填业务定义、技术规格,不然ETL任务提交不了;
- 变更阶段:要改字段名、类型,得写清楚“为啥改”“会影响哪些下游”,还得走审批,通知相关的人;
- 使用阶段:分析师取数前,必须看数据字典确认字段口径,不然算出来的结果不认。
关键是在数据开发平台里,加“数据字典校验”的规则。没填必要信息的任务就不让运行,从技术上逼着大家按规范来。
3. 最后“增值”:让数据字典帮企业盘活数据资产
等数据字典完善了,它就不只是“治理工具”了,还能变成“资产工具”:
- 数据搜索:业务人员搜“高净值用户”,就能直接找到对应的字段(比如'user_level=3')和技术表(比如'customer_info');
- 数据定价:根据数据字典里的血缘关系和值域复杂度,评估数据值多少钱。比如经常用的核心指标表,肯定比临时日志表值钱;
- 数据创新:看看数据字典里哪些字段被调用最多、哪些表经常一起查,找到有价值的数据链路,指导后面开发数据产品。
关键是把数据字典和数据资产目录打通:
- 业务人员能通过“业务术语”找数据,
- 技术人员能通过“技术规格”定位表结构,
真正做到“找数不难、用数不乱”。
总结
回到开头对“活跃用户”的争吵,问题根本不在技术,而在这几点:
- 业务方觉得“活跃”是“有行为”,技术方觉得是“登录过”;
- 运营加了“消费”这个条件,却没写到数据字典里;
- 跨部门干活,没有统一的“数据语言”。
说白了,数据治理的本质,就是通过完善数据字典,让全公司对数据有共识。
——技术知道业务要啥,业务知道数据从哪来,所有人都用同一套“数据语言”协作。
所以真别把数据字典当成“应付检查的文档”。
它是数据治理的起点,是业务和技术的约定,更是企业数据资产的底子。你把数据字典写清楚、用起来、管到位了,数据治理的那些麻烦事儿,自然就少了。
毕竟,再复杂的技术问题,最后都是“人”的共识问题——而数据字典,就是解决这个问题最实在的工具。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号