流处理 or 批处理?大数据架构还需要流批一体吗?
原创
流处理 or 批处理?大数据架构还需要流批一体吗?
原创
帆软BI
发布于 2025-08-13 12:55:59
发布于 2025-08-13 12:55:59
流处理(处理实时数据流)和批处理(处理历史数据集),曾经是支撑我们实时监控和深度分析的两大支柱。
但日子久了,问题也来了:它们数据不通、代码不通、资源不通。
为了同时满足“秒级响应”和“深度分析”,不得不同时维护两套系统、写两套代码、存两份数据。成本高、效率低,还容易出错。
如今,业务对数据的要求越来越高:
- 报表要从“T+1”变成“分钟级”,
- 实时数据要立刻用于模型训练,
- 离线规则要马上生效于实时风控
这种分离的架构,越来越力不从心。于是,“流批一体”被推到了台前。
它喊出的口号是:告别重复劳动,一套代码搞定实时和离线!
但它真能解决我们的痛点吗?还是只是听起来很美?大数据架构真的到了必须拥抱流批一体的时候了吗?看完这篇你就明白了!
一、流处理和批处理是什么?
要回答「是否需要流批一体」,首先得弄清楚流处理和批处理分别是什么。
它们是两种完全不同的数据处理思路,很多企业最初选择分开流批,是因为两者的技术特性差异:
- 流处理擅长处理无界、实时的数据流,强调低延迟;
- 批处理则针对有界、静态的历史数据集,追求高吞吐。
这种「术业有专攻」的分工,在早期确实降低了技术复杂度。
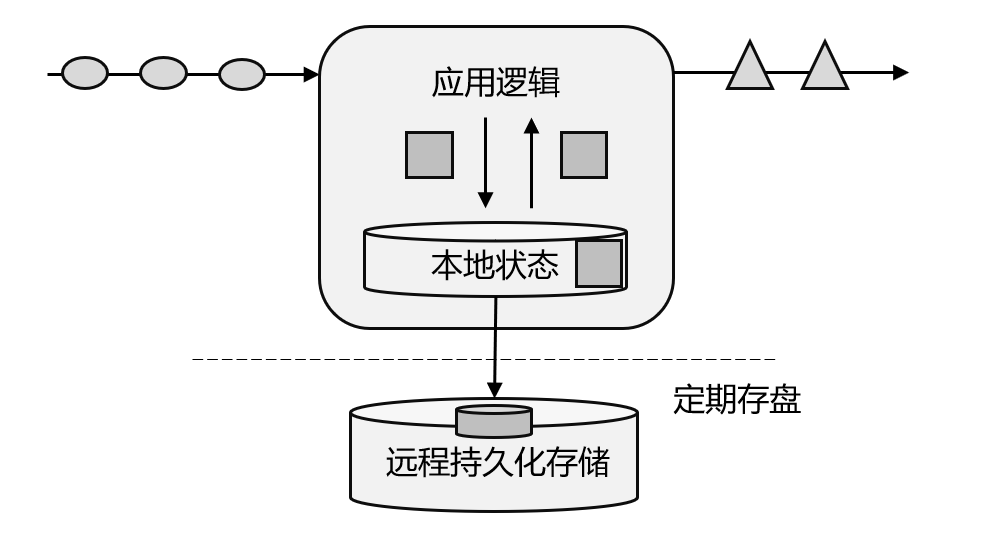
1. 流处理:处理那些不停产生的实时数据
流处理的核心是:
处理那些源源不断、没有终点的数据,而且得快。
具体来说:
- 一是无界,数据来了就停不下来。
- 二是实时,数据刚产生,系统就得马上处理,延迟通常在秒级甚至毫秒级。
举个实际的例子:
外卖平台的骑手实时位置追踪功能,每秒要接收几千个骑手的GPS坐标。
流处理系统要:
立刻算出每个骑手离用户多远、大概多久能送到,然后把结果推到用户手机上。
这里最关键的就是快——如果处理慢了,超过5秒,用户看到的位置可能就不准了,体验肯定受影响。
流处理设计的时候就盯着这几个目标:
- 低延迟
- 高并发
- 容错性强
2. 批处理:处理那些固定时间段的历史数据
批处理正好相反,它处理的是有明确范围、相对静态的数据集。
具体来说:
- 一是有界,数据有头有尾,比如一天的所有订单记录、一个月的用户行为日志;
- 二是静态,系统可以对这些数据做深入、复杂的计算,不用担心新数据一直进来打扰。
这种处理对时间要求不高:
延迟几小时甚至一天都没关系,只要能在次月1号上午前弄完就行。
但有一点必须保证:
结果绝对准确,不能漏算任何一笔订单。
批处理设计目标很明确:
- 高吞吐
- 强一致性
- 计算精确
3. 传统架构为什么要分开
早期大数据架构选择让流处理和批处理分开,说白了就是让合适的工具干合适的事:
- 流处理擅长快速响应,适合监控、报警、实时推荐这些场景;
- 批处理擅长深入分析,适合做报表、训练模型、复盘历史数据。
这样一来:
在业务主要靠T+1分析的年代,这种分工效率很高,企业不用为了实时性花太多钱。
二、流批一体到底是什么?
要说流批一体,得先说说流批割裂的问题。传统架构里,流处理和批处理是两套完全独立的系统:
- 数据在流处理这边存在Kafka,在批处理那边存在HDFS,两边都得存一份;
- 业务逻辑也得写两遍,流任务用Flink SQL,批任务用Hive SQL。
结果呢?
- 一个是增量累加,一个是全量扫描,经常因为计算方式不一样而对不上;
- 运维也得分开,两拨人各管一摊。
而流批一体,本质上是通过重构技术架构,让流处理和批处理在逻辑、存储、资源这三个层面实现统一。
最终目的是:
让企业不用再纠结用流还是用批,而是根据业务场景选最合适的处理方式。
具体怎么实现?
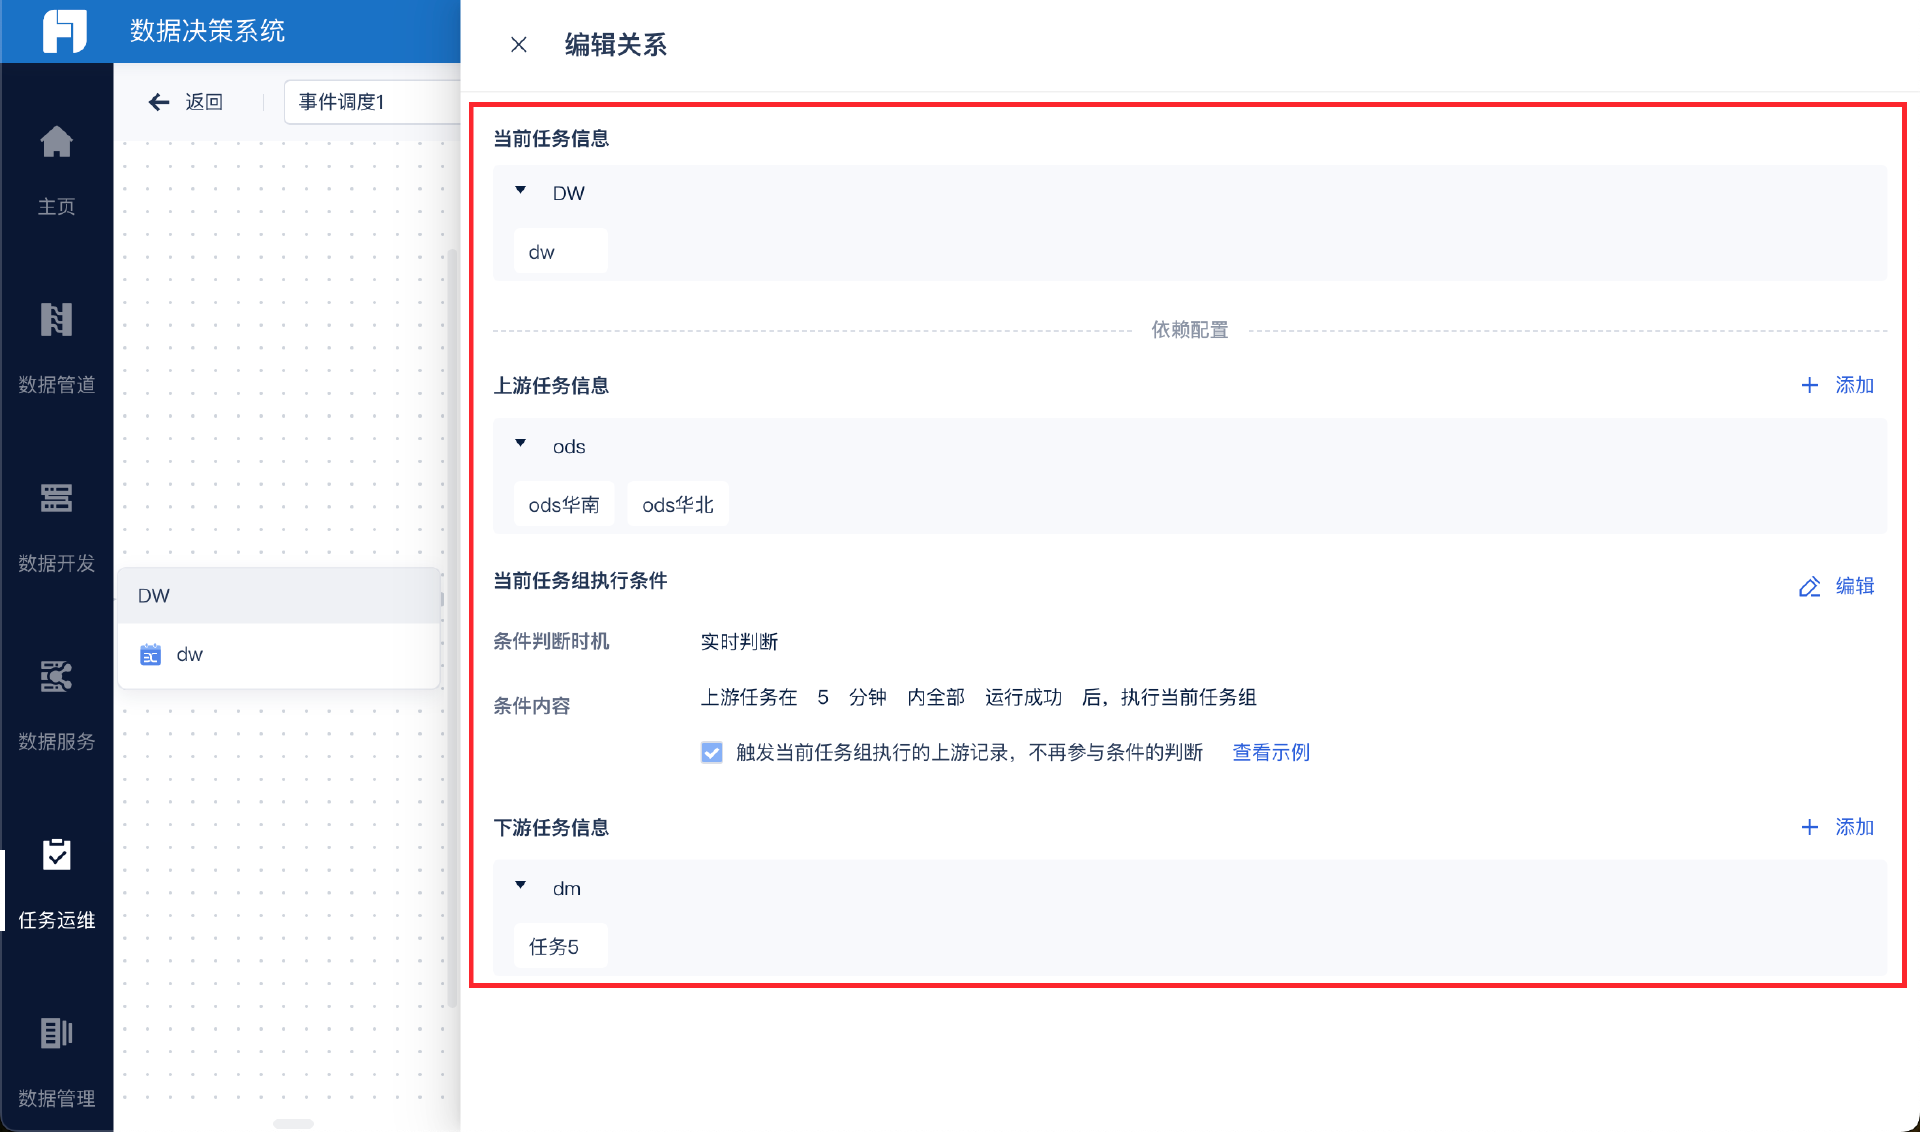
可以借助ETL工具FineDataLink,它提供了简单易用的交互界面,通过拖拽等方式轻松实现数据抽取、数据清洗、数据转换、数据整合、数据加载等多个环节,大大提高了数据处理效率和准确性。
具体来说,流批一体有这么三个关键统一:
1. 逻辑统一:一套代码,既能处理实时数据也能处理历史数据
流批一体最核心的是逻辑能复用。
传统架构里,算个GMV:
- 实时的得写一套Flink SQL,基于增量消息一点点加;
- 离线的又得写一套Hive SQL,扫全量表来算。
结果呢?
这两套逻辑很容易因为过滤条件、关联方式不一样,导致结果差得远。
但在流批一体架构里:企业可以用同一套SQL或者代码定义计算逻辑。
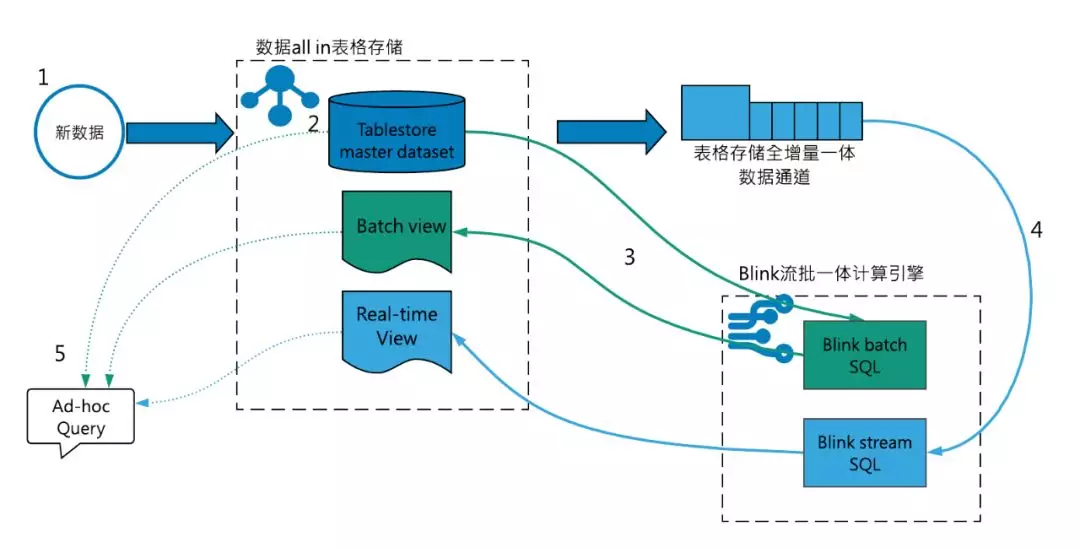
这样一来:
- 不管是处理刚产生的实时数据(秒级延迟),
- 还是回溯过去的历史数据(小时或天级延迟),
逻辑都是一样的,结果自然也能对得上。
2. 存储统一:一个数据湖或数据仓,同时满足实时和离线需求
传统架构里:
- 流数据存在Kafka,虽然实时性好,但不好长期存,分析起来也麻烦;
- 批数据存在HDFS,虽然稳定,但更新起来不方便。
两边的数据要同步,还得靠ETL任务。这样一来,数据的时效性和完整性很难同时保证。
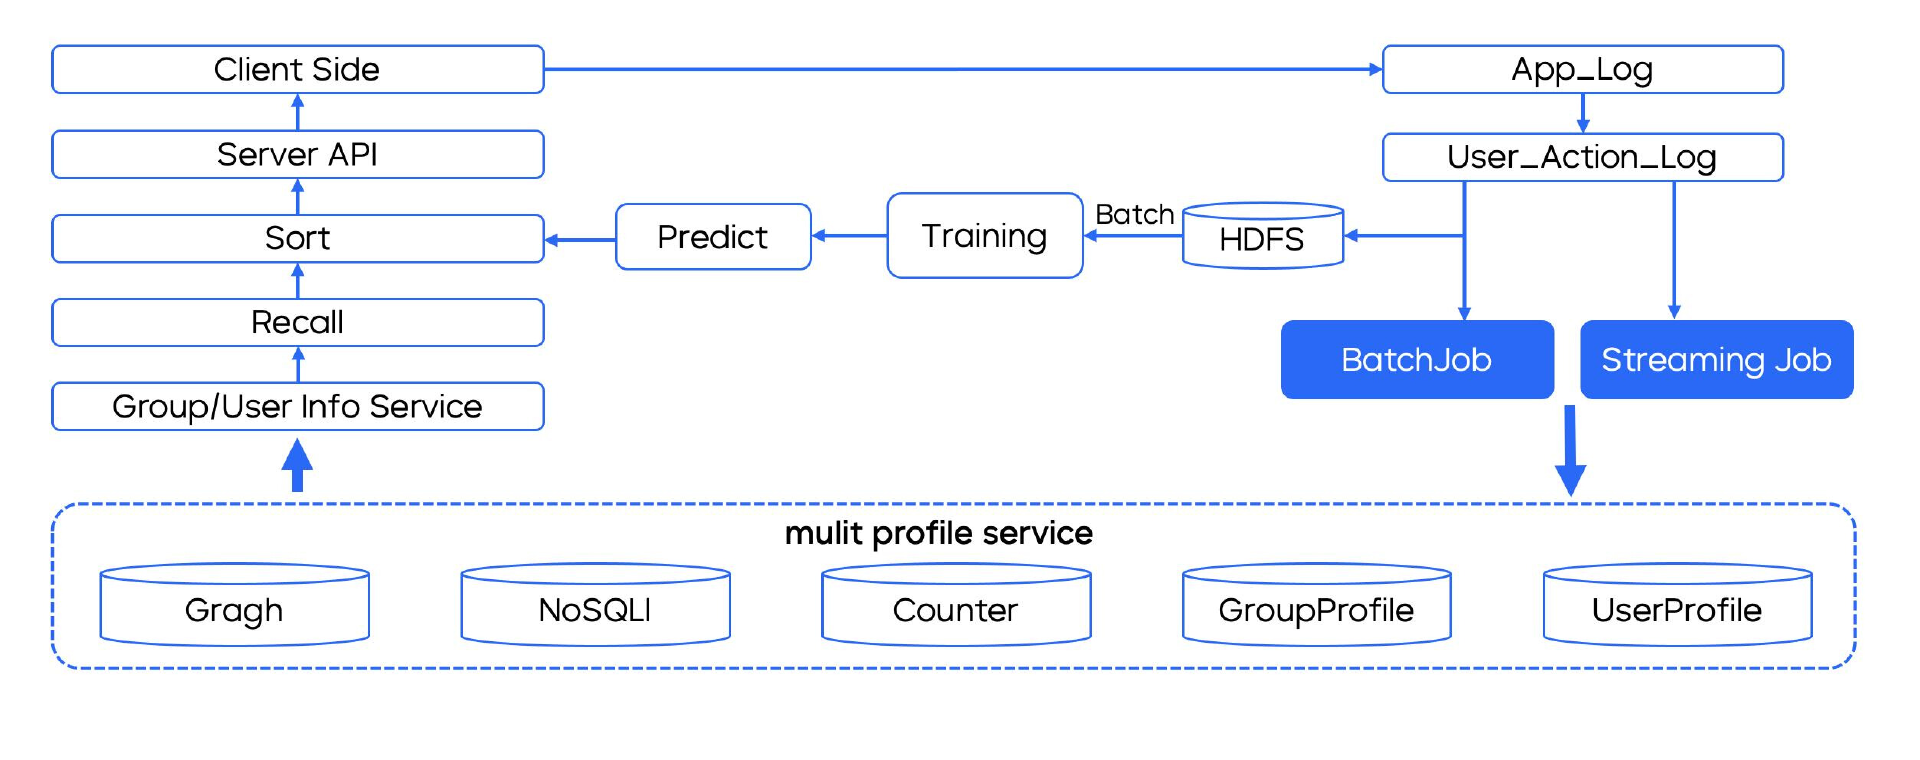
流批一体架构一般会用湖仓一体的存储方案:
- 实时数据会以增量日志的形式写到湖仓里,批处理任务直接读这些实时增量就行,不用再做传统的ETL;
- 流处理任务想查历史数据,也能直接从湖仓里调,不用再依赖Kafka长期存数据。
这样一来,存储就统一了,数据流转也更顺畅。
3. 资源统一:弹性调度,让计算资源跟着需求走
流批分离的时候:
- 得给实时任务预留固定的计算资源,怕延迟太高;
- 还得给批任务留些弹性资源,应对大促这种高峰期,结果就是资源浪费不少。
而流批一体架构靠的是统一计算引擎加弹性调度,打破这种资源分割。
就拿基于Flink的流批一体来说,同一个集群里既能跑流任务也能跑批任务:
- 大促高峰期,调度器自动把更多资源分给实时任务;
- 到了夜间低谷期,批处理任务就能用流任务空闲的资源,资源利用率一下子就提上来了。
三、流批一体的三个常见误区
流批一体听着是好,但别为了统一而统一。要是盲目推进,很容易掉坑里。用过来人的经验告诉你,落地的时候得避开这三个陷阱:
1. 误区一:换个能同时支持流批的工具≠实现了流批一体
有些企业觉得,只要把技术栈换成Flink这种能同时跑流和批的工具,就算实现流批一体了。
但实际上:
这只是把流批任务从两套工具搬到了一套工具上,根本没解决逻辑不一致的问题。
真正的流批一体,得从三个层面融合:
- 数据模型层面,比如统一管理元数据;
- 计算逻辑层面,比如用同一套SQL或代码;
- 运维体系层面,比如统一监控告警。
2. 误区二:没必要分实时优先还是批处理优先
流批一体不是说用流处理代替批处理,也不是反过来,而是看场景选最合适的:
- 比如实时风控,必须要毫秒级的延迟,那肯定得用流处理;
- 但年度财务审计,需要全量数据算得精准,这时候批处理的稳定性就更靠谱。
所以说:
别跟工具较劲,跟业务场景匹配才最重要。
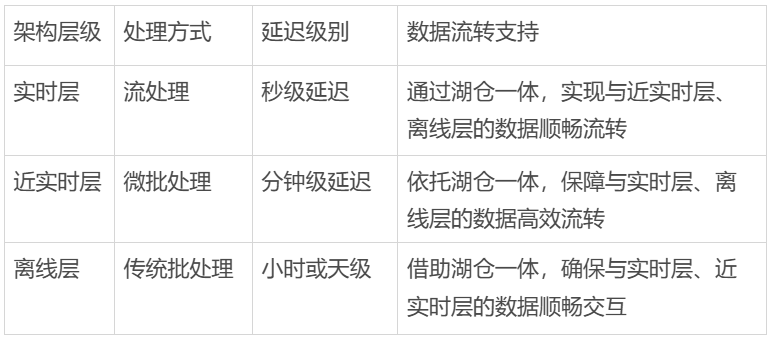
3. 误区三:没考虑数据时效性分层的需求
企业的数据,不是所有都得实时处理:
- 最近1小时的数据,可能对实时决策很关键,比如促销活动里的用户点击;
- 最近7天的数据,可能更适合做趋势分析,比如预测商品销量;
- 超过30天的数据,可能更多用来做长期建模,比如分析用户生命周期。
流批一体架构得支持这种分层处理:
四、大数据架构真的需要流批一体吗?
回到开头的问题:大数据架构真的需要流批一体吗?我的答案是,不仅需要,而且会是未来3-5年企业数据架构的核心发展方向。
为啥这么说?
因为流批一体不是技术上的妥协,而是业务真的需要:
- 现在企业的业务,已经从过去的事后分析,转向了实时决策;
- 数据也从原来的支撑工具,变成了核心生产要素。
这时候:
流批分离的架构就成了瓶颈,制约企业的竞争力。
流批一体的价值不在于用一套技术代替另一套,而在于:
通过逻辑、存储、资源的统一,让数据从产生、处理到应用的全链路里,既能保持一致,又能高效流转,最终把数据的价值充分发挥出来。
总结
对企业来说,落地流批一体别为了统一而统一,要选最合适的处理方式,让技术真正服务于业务目标。
我一直觉得,技术的价值从来不是说用了多先进的工具,而是解决了多少实际问题。
流批一体的本质,就是通过技术融合,让数据能更高效地驱动业务增长。这一点,相信正在做大数据的你,感受会越来越深。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号