[yolov11改进系列]基于yolov11引入双卷积DualConv用于轻量化网络的python源码+训练源码

[yolov11改进系列]基于yolov11引入双卷积DualConv用于轻量化网络的python源码+训练源码
git clone firc-dataset
发布于 2025-07-18 15:56:49
发布于 2025-07-18 15:56:49
【双卷积DualConv介绍】
CNN架构通常对内存和计算资源的要求较高,这使得它们在硬件资源有限的嵌入式系统中难以实现。我们提出了一种用于构建轻量级深度神经网络的双卷积核(DualConv)方法。DualConv结合了3 \times 3和1 \times 1的卷积核,同时处理相同的输入特征图通道,并利用组卷积技术高效地排列卷积滤波器。DualConv可以应用于任何CNN模型,例如用于图像分类的VGG-16和ResNet-50,用于目标检测的YOLO和R-CNN,或用于语义分割的FCN。在本文中,我们广泛测试了DualConv在分类任务中的表现,因为这些网络架构构成了许多其他任务的骨干。我们还测试了DualConv在YOLO-V3上的图像检测性能。实验结果表明,结合我们的结构创新,DualConv显著减少了深度神经网络的计算成本和参数数量,同时在某些情况下,令人惊讶地实现了比原始模型稍高的准确性。我们使用DualConv进一步减少了轻量级MobileNetV2的参数数量54%,在CIFAR-100数据集上仅下降了0.68%的准确性。当参数数量不是问题时,DualConv在相同数据集上将MobileNetV1的准确性提高了4.11%。此外,DualConv显著提升了YOLO-V3的目标检测速度,并在PASCAL VOC数据集上将其准确性提高了4.4%。
基本原理
DualConv是一种创新的深度神经网络技术,旨在构建轻量级的深度神经网络。
双重卷积核结构 :
DualConv结合了3x3和1x1卷积核,同时处理相同的输入特征图通道。通过这种结合,DualConv能够在保持准确性的同时降低网络的计算成本和参数数量。
- 3x3卷积核的作用:
- 3x3卷积核通常用于捕获局部特征和空间信息,有助于提取输入特征图的细粒度特征。
- 在双重卷积核结构中,3x3卷积核负责处理输入特征图的通道维度,从而实现对特征的深度提取和表征。
- 1x1卷积核的作用:
- 1x1卷积核通常用于减少特征图的通道数量,降低计算成本和参数数量,同时有助于特征的融合和压缩。
- 在双重卷积核结构中,1x1卷积核与3x3卷积核结合使用,可以在保持准确性的同时实现参数的有效压缩和计算的高效性。
- 同时处理的优势:
- 双重卷积核结构使得3x3和1x1卷积核能够同时处理相同的输入特征图通道,从而加快计算速度,提高网络的效率和性能。
- 同时处理不同类型的卷积核有助于网络在不同尺度上捕获特征信息,并有效地融合这些信息,提高网络的表征能力和泛化能力。
- 参数减少与性能提升:
- 双重卷积核结构通过结合3x3和1x1卷积核,实现了在轻量级深度神经网络中提高准确性、降低计算成本和参数数量的目标。
- 这种结构的设计使得网络在保持高准确性的同时,具有更高的计算效率和更少的参数量,适合在资源受限的环境中部署和应用。
总的来说,双重卷积核结构的技术原理在于充分利用3x3和1x1卷积核的优势,同时处理输入特征图通道,实现了在深度神经网络中提高效率、准确性和泛化能力的目标。
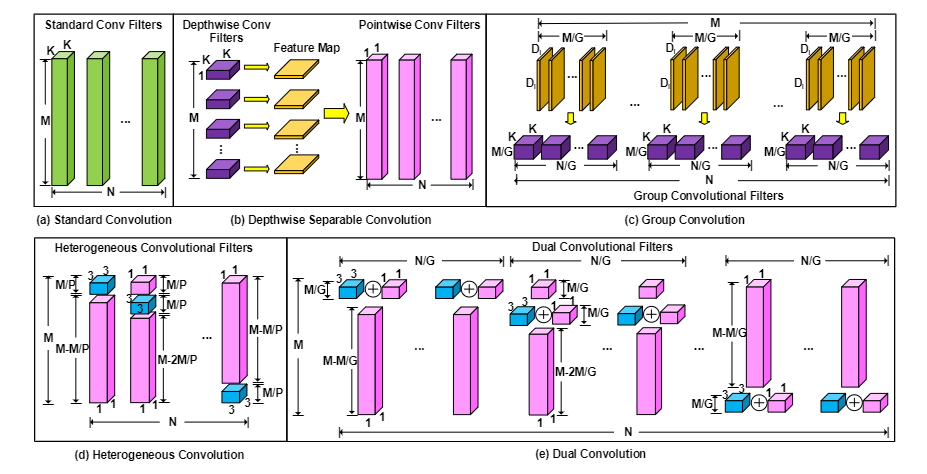
image-20240605170130004
【yolov11框架介绍】
2024 年 9 月 30 日,Ultralytics 在其活动 YOLOVision 中正式发布了 YOLOv11。YOLOv11 是 YOLO 的最新版本,由美国和西班牙的 Ultralytics 团队开发。YOLO 是一种用于基于图像的人工智能的计算机模
Ultralytics YOLO11 概述
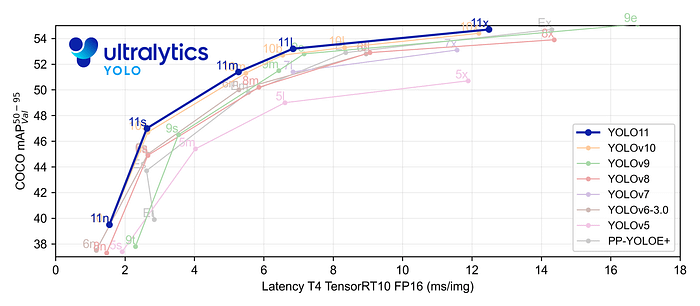
YOLO11 是Ultralytics YOLO 系列实时物体检测器的最新版本,以尖端的精度、速度和效率重新定义了可能性。基于先前 YOLO 版本的令人印象深刻的进步,YOLO11 在架构和训练方法方面引入了重大改进,使其成为各种计算机视觉任务的多功能选择。
Key Features 主要特点
- 增强的特征提取:YOLO11采用改进的主干和颈部架构,增强了特征提取能力,以实现更精确的目标检测和复杂任务性能。
- 针对效率和速度进行优化:YOLO11 引入了精致的架构设计和优化的训练管道,提供更快的处理速度并保持准确性和性能之间的最佳平衡。
- 使用更少的参数获得更高的精度:随着模型设计的进步,YOLO11m 在 COCO 数据集上实现了更高的平均精度(mAP),同时使用的参数比 YOLOv8m 少 22%,从而在不影响精度的情况下提高计算效率。
- 跨环境适应性:YOLO11可以无缝部署在各种环境中,包括边缘设备、云平台以及支持NVIDIA GPU的系统,确保最大的灵活性。
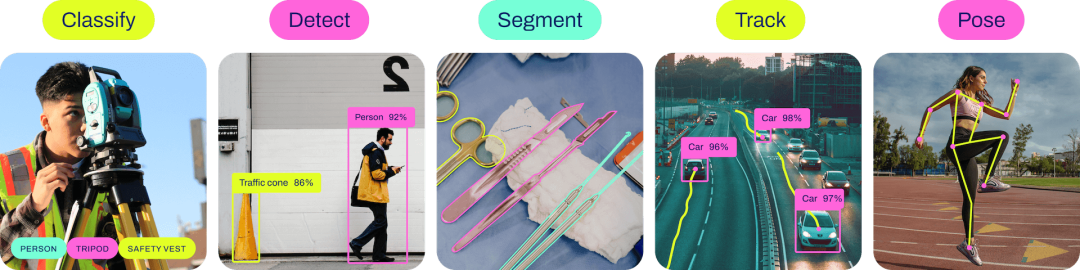
- 支持的任务范围广泛:无论是对象检测、实例分割、图像分类、姿态估计还是定向对象检测 (OBB),YOLO11 旨在应对各种计算机视觉挑战。
与之前的版本相比,Ultralytics YOLO11 有哪些关键改进?
Ultralytics YOLO11 与其前身相比引入了多项重大进步。主要改进包括:
- 增强的特征提取:YOLO11采用改进的主干和颈部架构,增强了特征提取能力,以实现更精确的目标检测。
- 优化的效率和速度:精细的架构设计和优化的训练管道可提供更快的处理速度,同时保持准确性和性能之间的平衡。
- 使用更少的参数获得更高的精度:YOLO11m 在 COCO 数据集上实现了更高的平均精度(mAP),参数比 YOLOv8m 少 22%,从而在不影响精度的情况下提高计算效率。
- 跨环境适应性:YOLO11可以跨各种环境部署,包括边缘设备、云平台和支持NVIDIA GPU的系统。
- 支持的任务范围广泛:YOLO11 支持多种计算机视觉任务,例如对象检测、实例分割、图像分类、姿态估计和定向对象检测 (OBB)
【测试环境】
windows10 x64
ultralytics==8.3.0
torch==2.3.1
【改进流程】
1. 新增DualConv.py实现模块(代码太多,核心模块源码请参考改进步骤.docx)然后在同级目录下面创建一个__init___.py文件写代码
from .DualConv. import *
2. 文件修改步骤
修改tasks.py文件
创建模型配置文件
yolo11-C3k2-DualConv-1.yaml内容如下:
# Ultralytics YOLO 🚀, AGPL-3.0 license
# YOLO11 object detection model with P3-P5 outputs. For Usage examples see https://docs.ultralytics.com/tasks/detect

# Parameters
nc: 80 # number of classes
scales: # model compound scaling constants, i.e. 'model=yolo11n.yaml' will call yolo11.yaml with scale 'n'
  # [depth, width, max_channels]
  n: [0.50, 0.25, 1024] # summary: 319 layers, 2624080 parameters, 2624064 gradients, 6.6 GFLOPs
  s: [0.50, 0.50, 1024] # summary: 319 layers, 9458752 parameters, 9458736 gradients, 21.7 GFLOPs
  m: [0.50, 1.00, 512] # summary: 409 layers, 20114688 parameters, 20114672 gradients, 68.5 GFLOPs
  l: [1.00, 1.00, 512] # summary: 631 layers, 25372160 parameters, 25372144 gradients, 87.6 GFLOPs
  x: [1.00, 1.50, 512] # summary: 631 layers, 56966176 parameters, 56966160 gradients, 196.0 GFLOPs

# YOLO11n backbone
backbone:
  # [from, repeats, module, args]
  - [-1, 1, Conv, [64, 3, 2]] # 0-P1/2
  - [-1, 1, Conv, [128, 3, 2]] # 1-P2/4
  - [-1, 2, C3k2_DualConv1, [256, False, 0.25]]
  - [-1, 1, Conv, [256, 3, 2]] # 3-P3/8
  - [-1, 2, C3k2_DualConv1, [512, False, 0.25]]
  - [-1, 1, Conv, [512, 3, 2]] # 5-P4/16
  - [-1, 2, C3k2_DualConv1, [512, True]]
  - [-1, 1, Conv, [1024, 3, 2]] # 7-P5/32
  - [-1, 2, C3k2_DualConv1, [1024, True]]
  - [-1, 1, SPPF, [1024, 5]] # 9
  - [-1, 2, C2PSA, [1024]] # 10

# YOLO11n head
head:
  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 6], 1, Concat, [1]] # cat backbone P4
  - [-1, 2, C3k2_DualConv1, [512, False]] # 13

  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 4], 1, Concat, [1]] # cat backbone P3
  - [-1, 2, C3k2_DualConv1, [256, False]] # 16 (P3/8-small)

  - [-1, 1, Conv, [256, 3, 2]]
  - [[-1, 13], 1, Concat, [1]] # cat head P4
  - [-1, 2, C3k2_DualConv1, [512, False]] # 19 (P4/16-medium)

  - [-1, 1, Conv, [512, 3, 2]]
  - [[-1, 10], 1, Concat, [1]] # cat head P5
  - [-1, 2, C3k2_DualConv1, [1024, True]] # 22 (P5/32-large)

  - [[16, 19, 22], 1, Detect, [nc]] # Detect(P3, P4, P5)
3. 验证集成
使用新建的yaml配置文件启动训练任务:
from ultralytics import YOLO

if __name__ == '__main__':
    model = YOLO('yolo11-C3k2-DualConv-1.yaml')  # build from YAML and transfer weights
        # Train the model
    results = model.train(data='coco128.yaml',epochs=100, imgsz=640, batch=8, device=0, workers=1, save=True,resume=False)
成功集成后,训练日志中将显示DualConv.模块的初始化信息,表明已正确加载到模型中。

【训练说明】
第一步:首先安装好yolov11必要模块,可以参考yolov11框架安装流程,然后卸载官方版本pip uninstall ultralytics,最后安装改进的源码pip install . 第二步:将自己数据集按照dataset文件夹摆放,要求文件夹名字都不要改变 第三步:分别打开train.py,coco128.yaml和模型参数yaml文件修改必要的参数,最后执行python train.py即可训练
【提供文件】
├── [官方源码]ultralytics-8.3.0.zip
├── train/
│   ├── coco128.yaml
│   ├── dataset/
│   │   ├── train/
│   │   │   ├── images/
│   │   │   │   ├── firc_pic_1.jpg
│   │   │   │   ├── firc_pic_10.jpg
│   │   │   │   ├── firc_pic_11.jpg
│   │   │   │   ├── firc_pic_12.jpg
│   │   │   │   ├── firc_pic_13.jpg
│   │   │   ├── labels/
│   │   │   │   ├── classes.txt
│   │   │   │   ├── firc_pic_1.txt
│   │   │   │   ├── firc_pic_10.txt
│   │   │   │   ├── firc_pic_11.txt
│   │   │   │   ├── firc_pic_12.txt
│   │   │   │   ├── firc_pic_13.txt
│   │   └── val/
│   │       ├── images/
│   │       │   ├── firc_pic_100.jpg
│   │       │   ├── firc_pic_81.jpg
│   │       │   ├── firc_pic_82.jpg
│   │       │   ├── firc_pic_83.jpg
│   │       │   ├── firc_pic_84.jpg
│   │       ├── labels/
│   │       │   ├── firc_pic_100.txt
│   │       │   ├── firc_pic_81.txt
│   │       │   ├── firc_pic_82.txt
│   │       │   ├── firc_pic_83.txt
│   │       │   ├── firc_pic_84.txt
│   ├── train.py
│   ├── yolo11-C3k2-DualConv-1.yaml
│   ├── yolo11-C3k2-DualConv-2.yaml
│   └── 训练说明.txt
├── [改进源码]ultralytics-8.3.0.zip
├── 改进原理.docx
└── 改进流程.docx
【常见问题汇总】 问:为什么我训练的模型epoch显示的map都是0或者map精度很低? 回答:由于源码改进过,因此不能直接从官方模型微调,而是从头训练,这样学习特征能力会很弱,需要训练很多epoch才能出现效果。此外由于改进的源码框架并不一定能够保证会超过官方精度,而且也有可能会存在远远不如官方效果,甚至精度会很低。这说明改进的框架并不能取得很好效果。所以说对于框架改进只是提供一种可行方案,至于改进后能不能取得很好map还需要结合实际训练情况确认,当然也不排除数据集存在问题,比如数据集比较单一,样本分布不均衡,泛化场景少,标注框不太贴合标注质量差,检测目标很小等等原因 【重要说明】 我们只提供改进框架一种方案,并不保证能够取得很好训练精度,甚至超过官方模型精度。因为改进框架,实际是一种比较复杂流程,包括框架原理可行性,训练数据集是否合适,训练需要反正验证以及同类框架训练结果参数比较,这个是十分复杂且漫长的过程。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2025-05-29,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号