二、Python爬取网页动态数据
原创
二、Python爬取网页动态数据
原创
Crystal_JJL
修改于 2025-07-03 15:58:42
修改于 2025-07-03 15:58:42
Step1 判断需要爬取的数据是静态还是动态数据
如何判断是静态数据还是动态数据?
右键点击【显示网页源代码】再输入command+F,搜索网页上文字能找到的就是静态数据,不能找到的就是动态数据。
Step2 动态数据爬取
Problem1 检查工具的使用
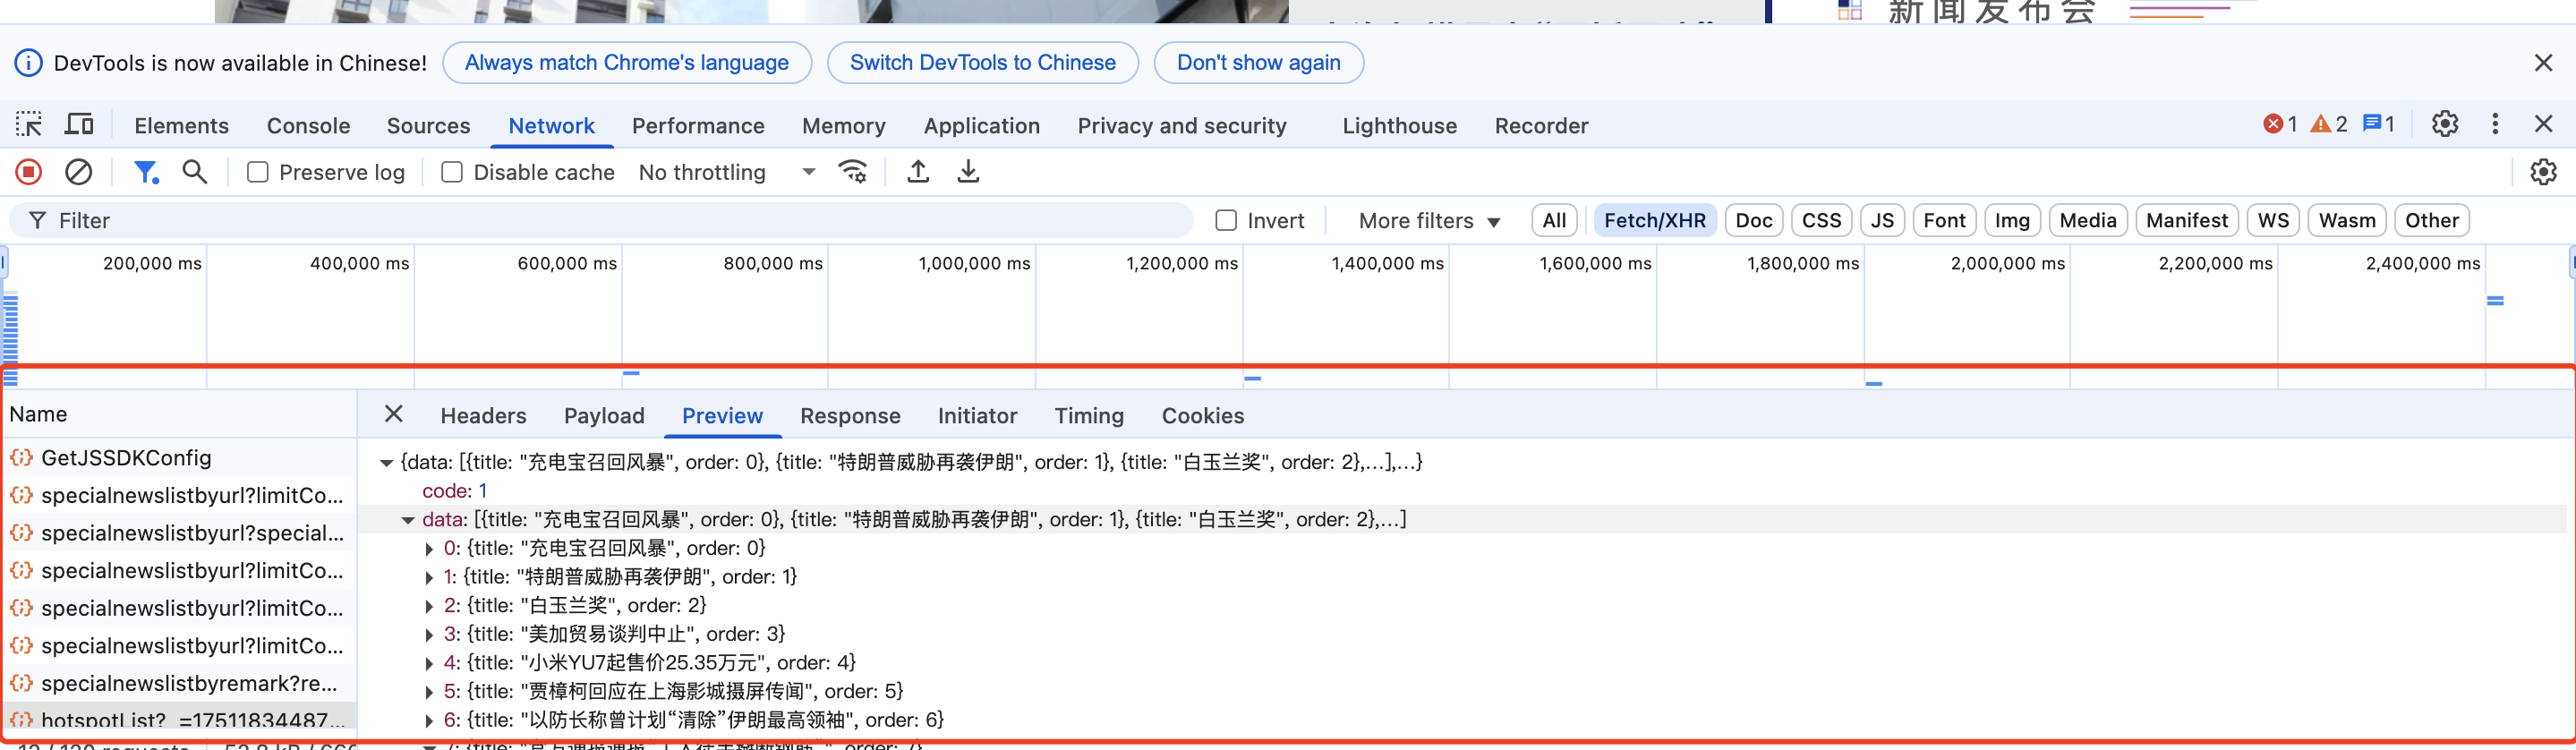
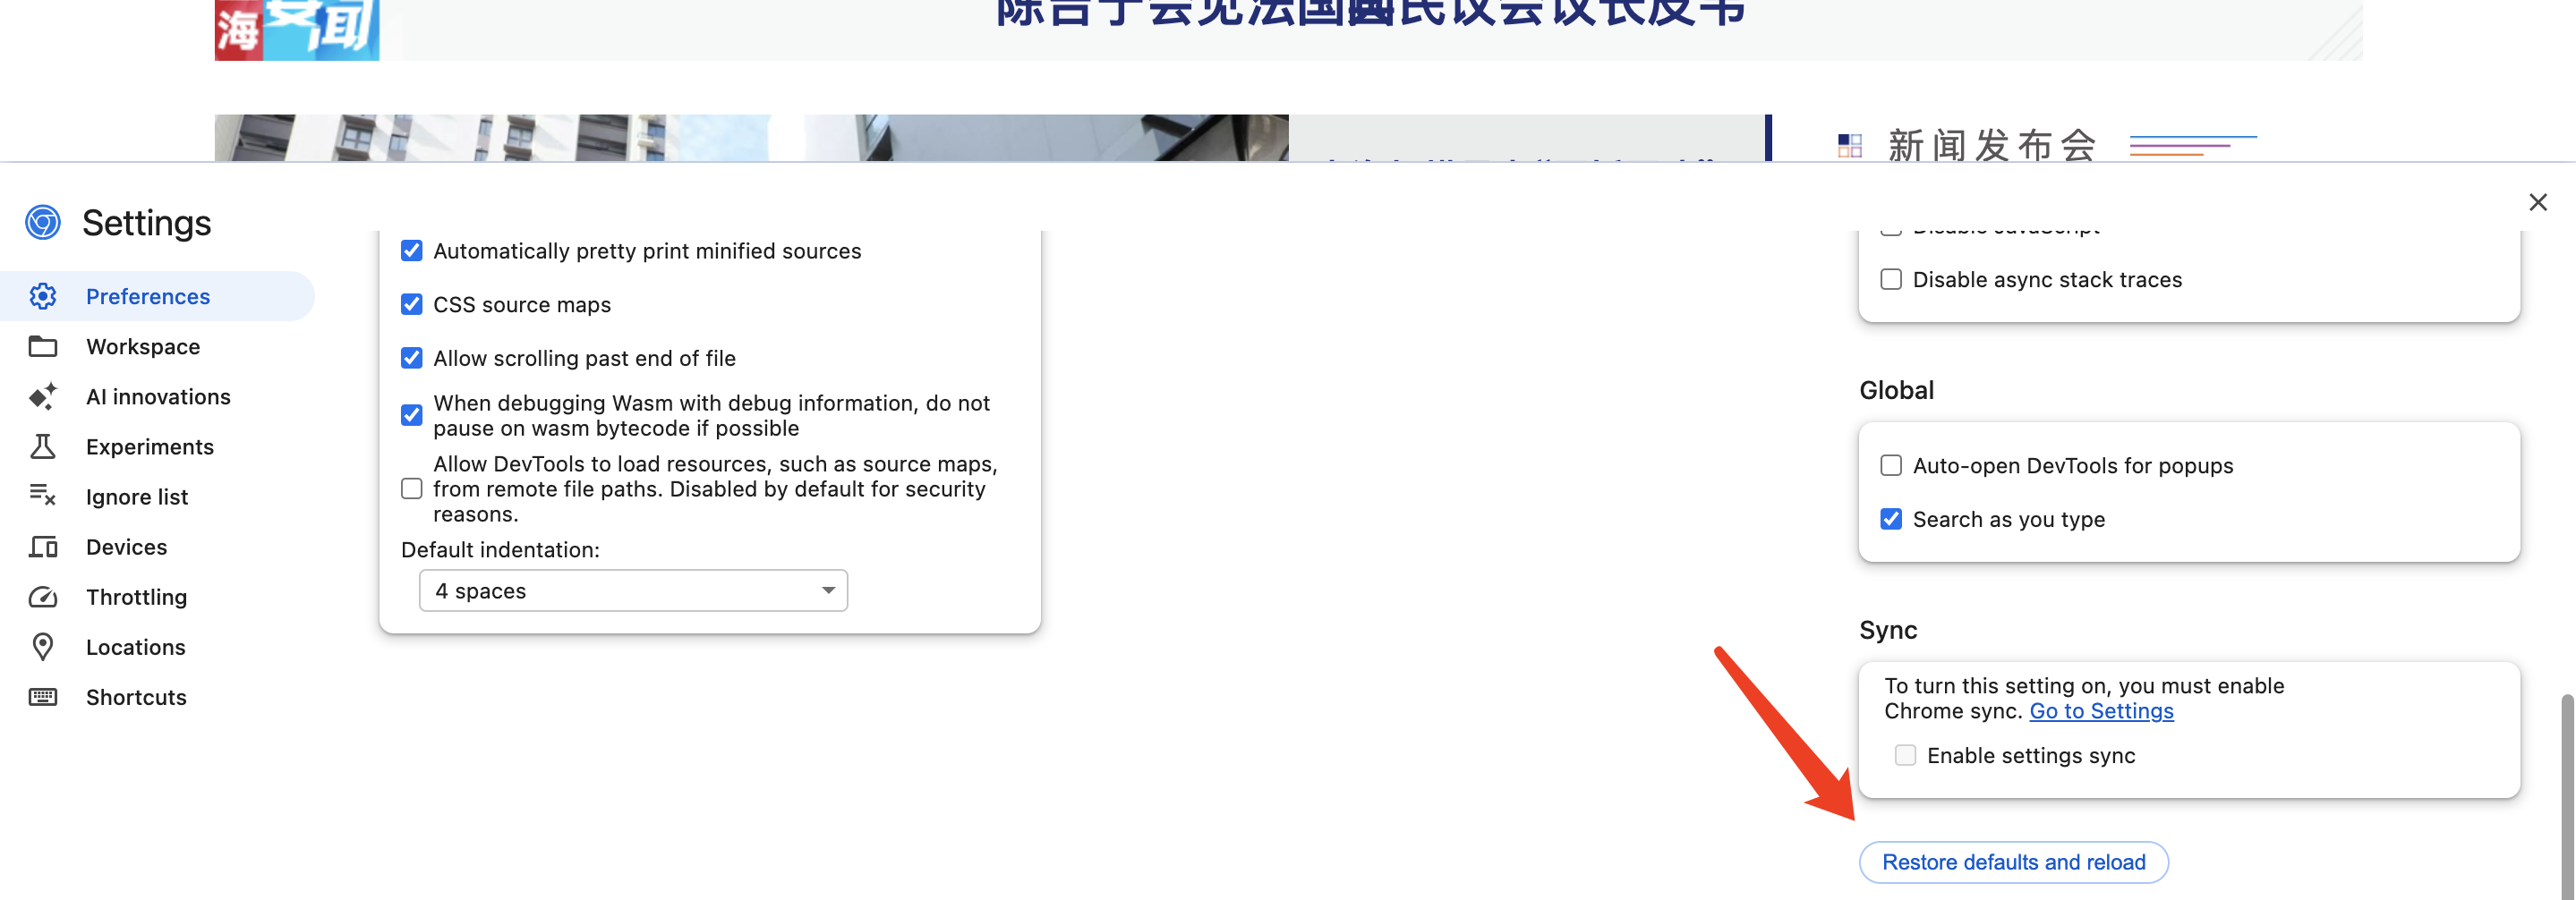
开始使用检查工具时遇到了中没有任何数据的问题,路径:【检查】-【network】-【Fetch/XHR】-【Name】,后面采用了进入设置中恢复默认设置的方法解决了。
Problem2 Get和Post
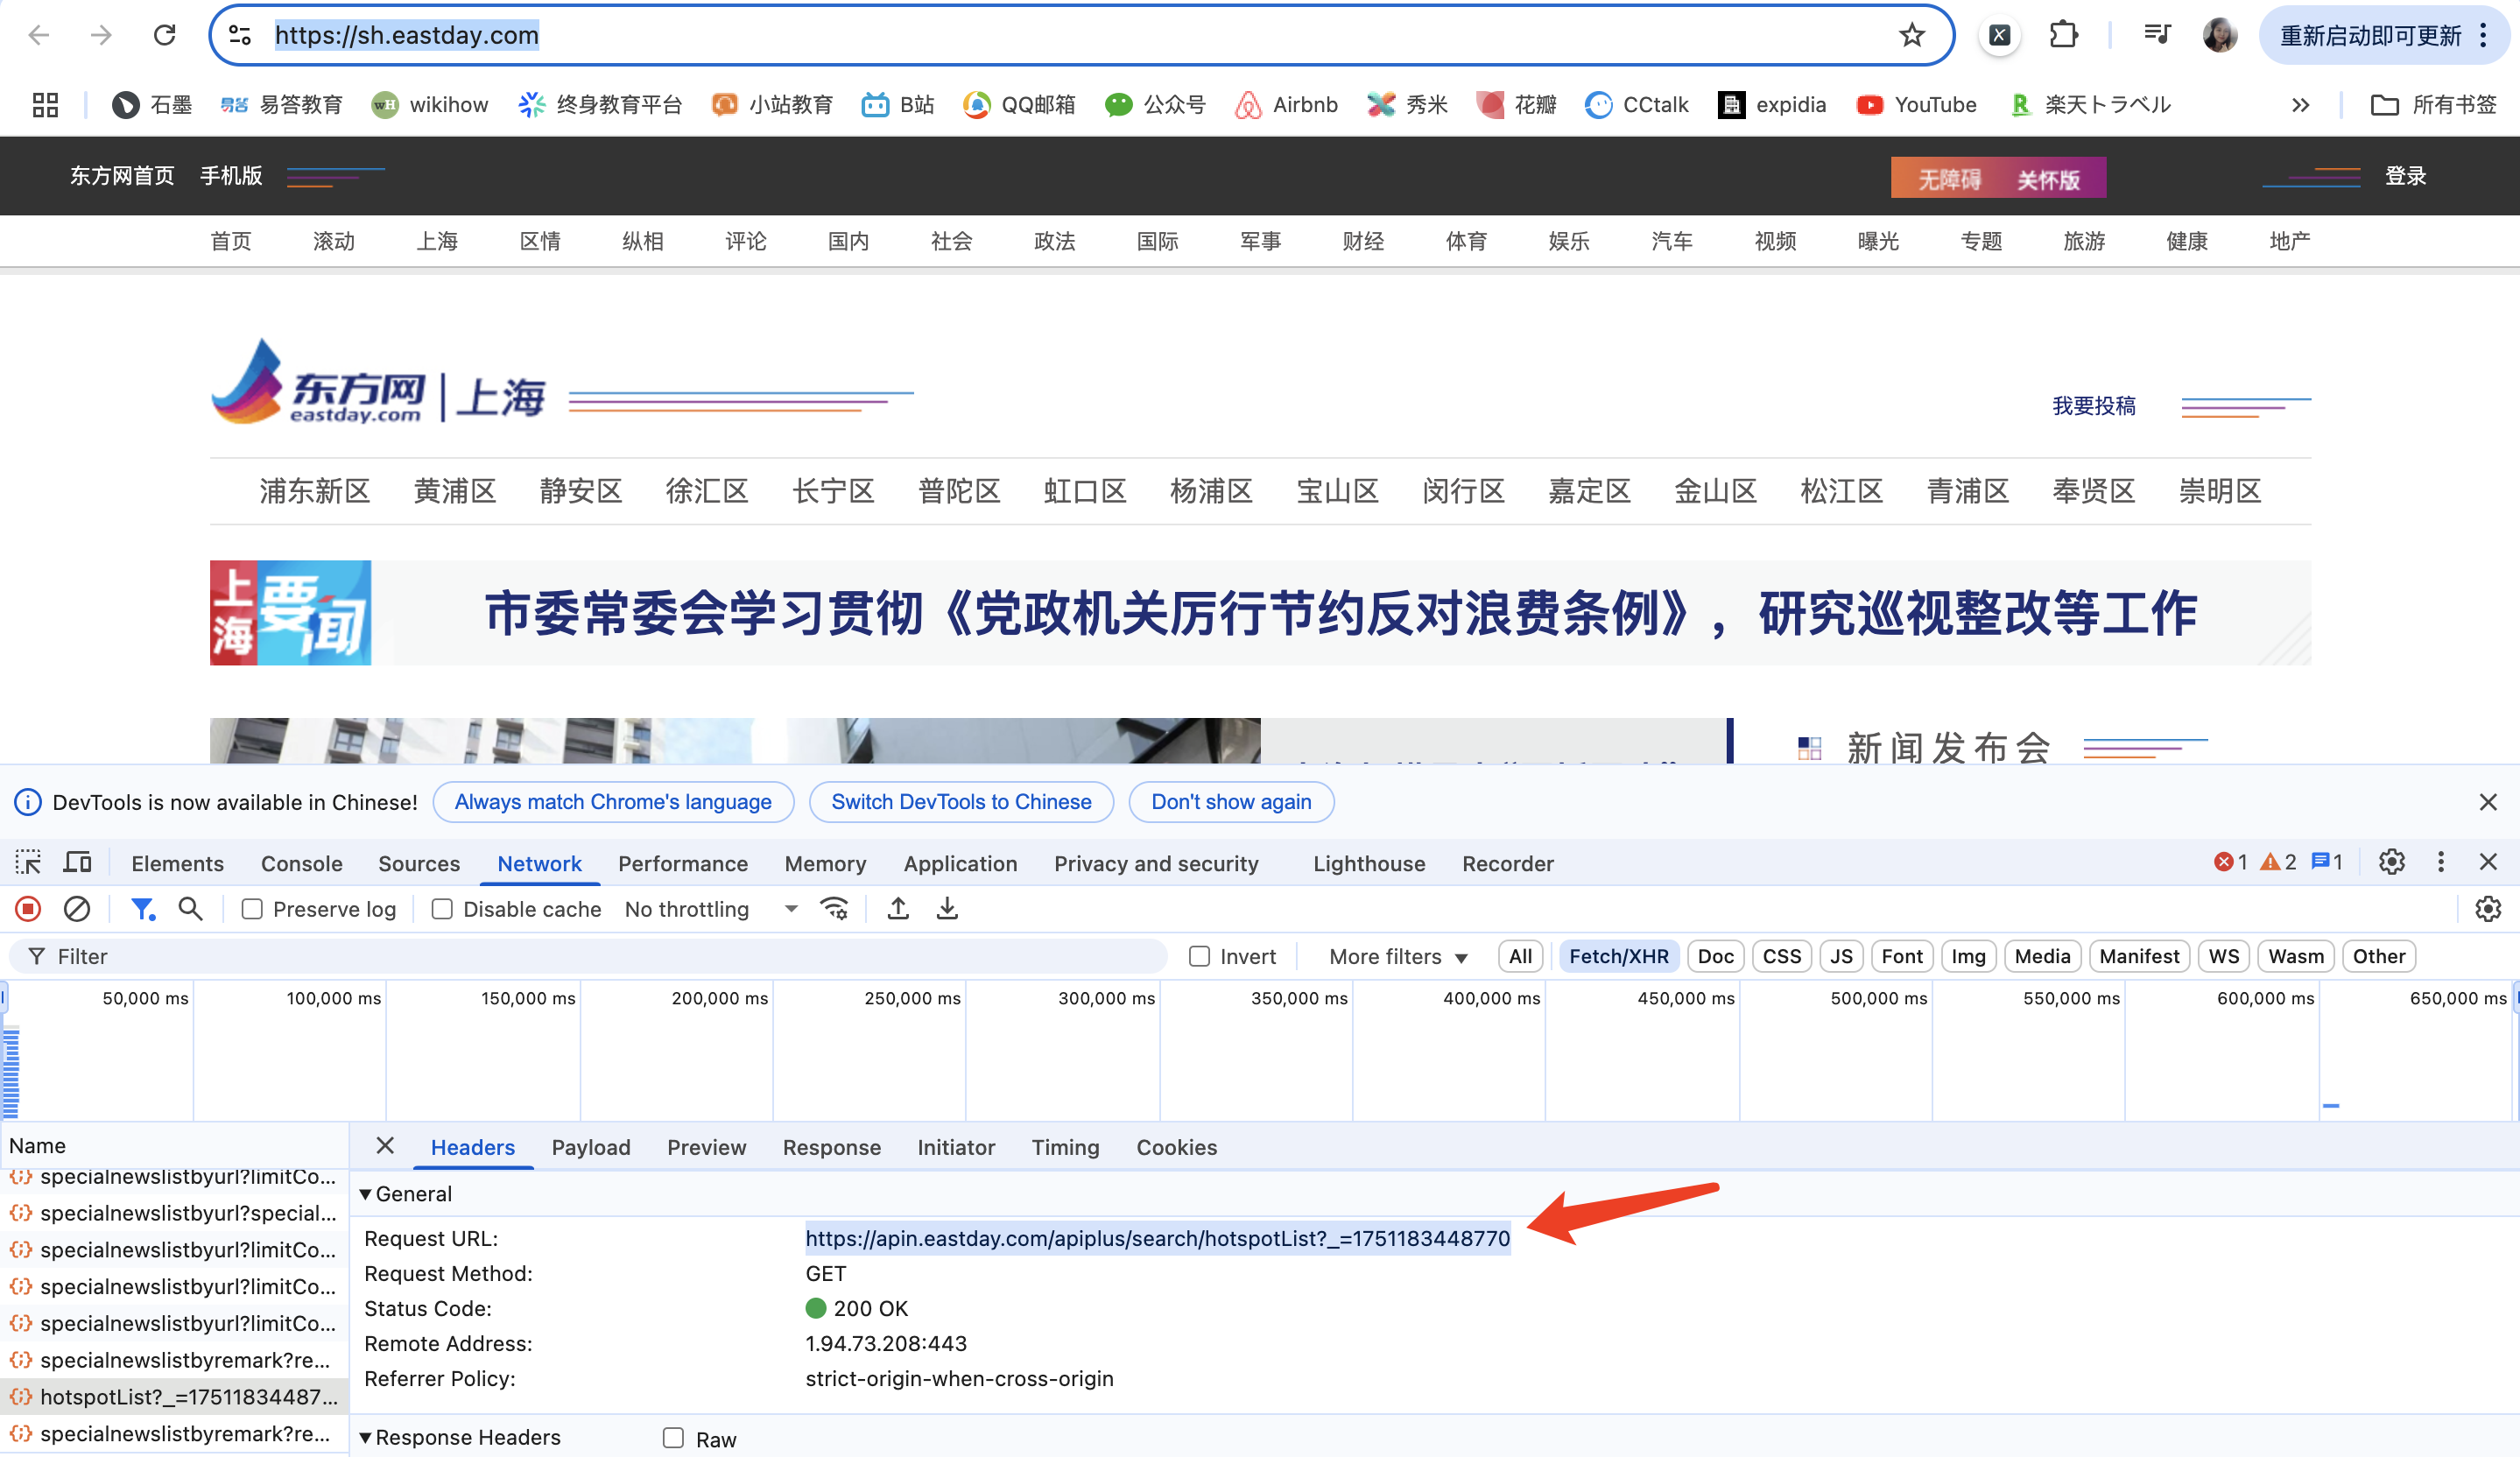
本次爬取的网页采用了东方网,在【Network】-【Fetch】中找到了对应的list列表,点击【Preview】,可以看到有对应的7个数据,这就是我们本次要爬取的数据。
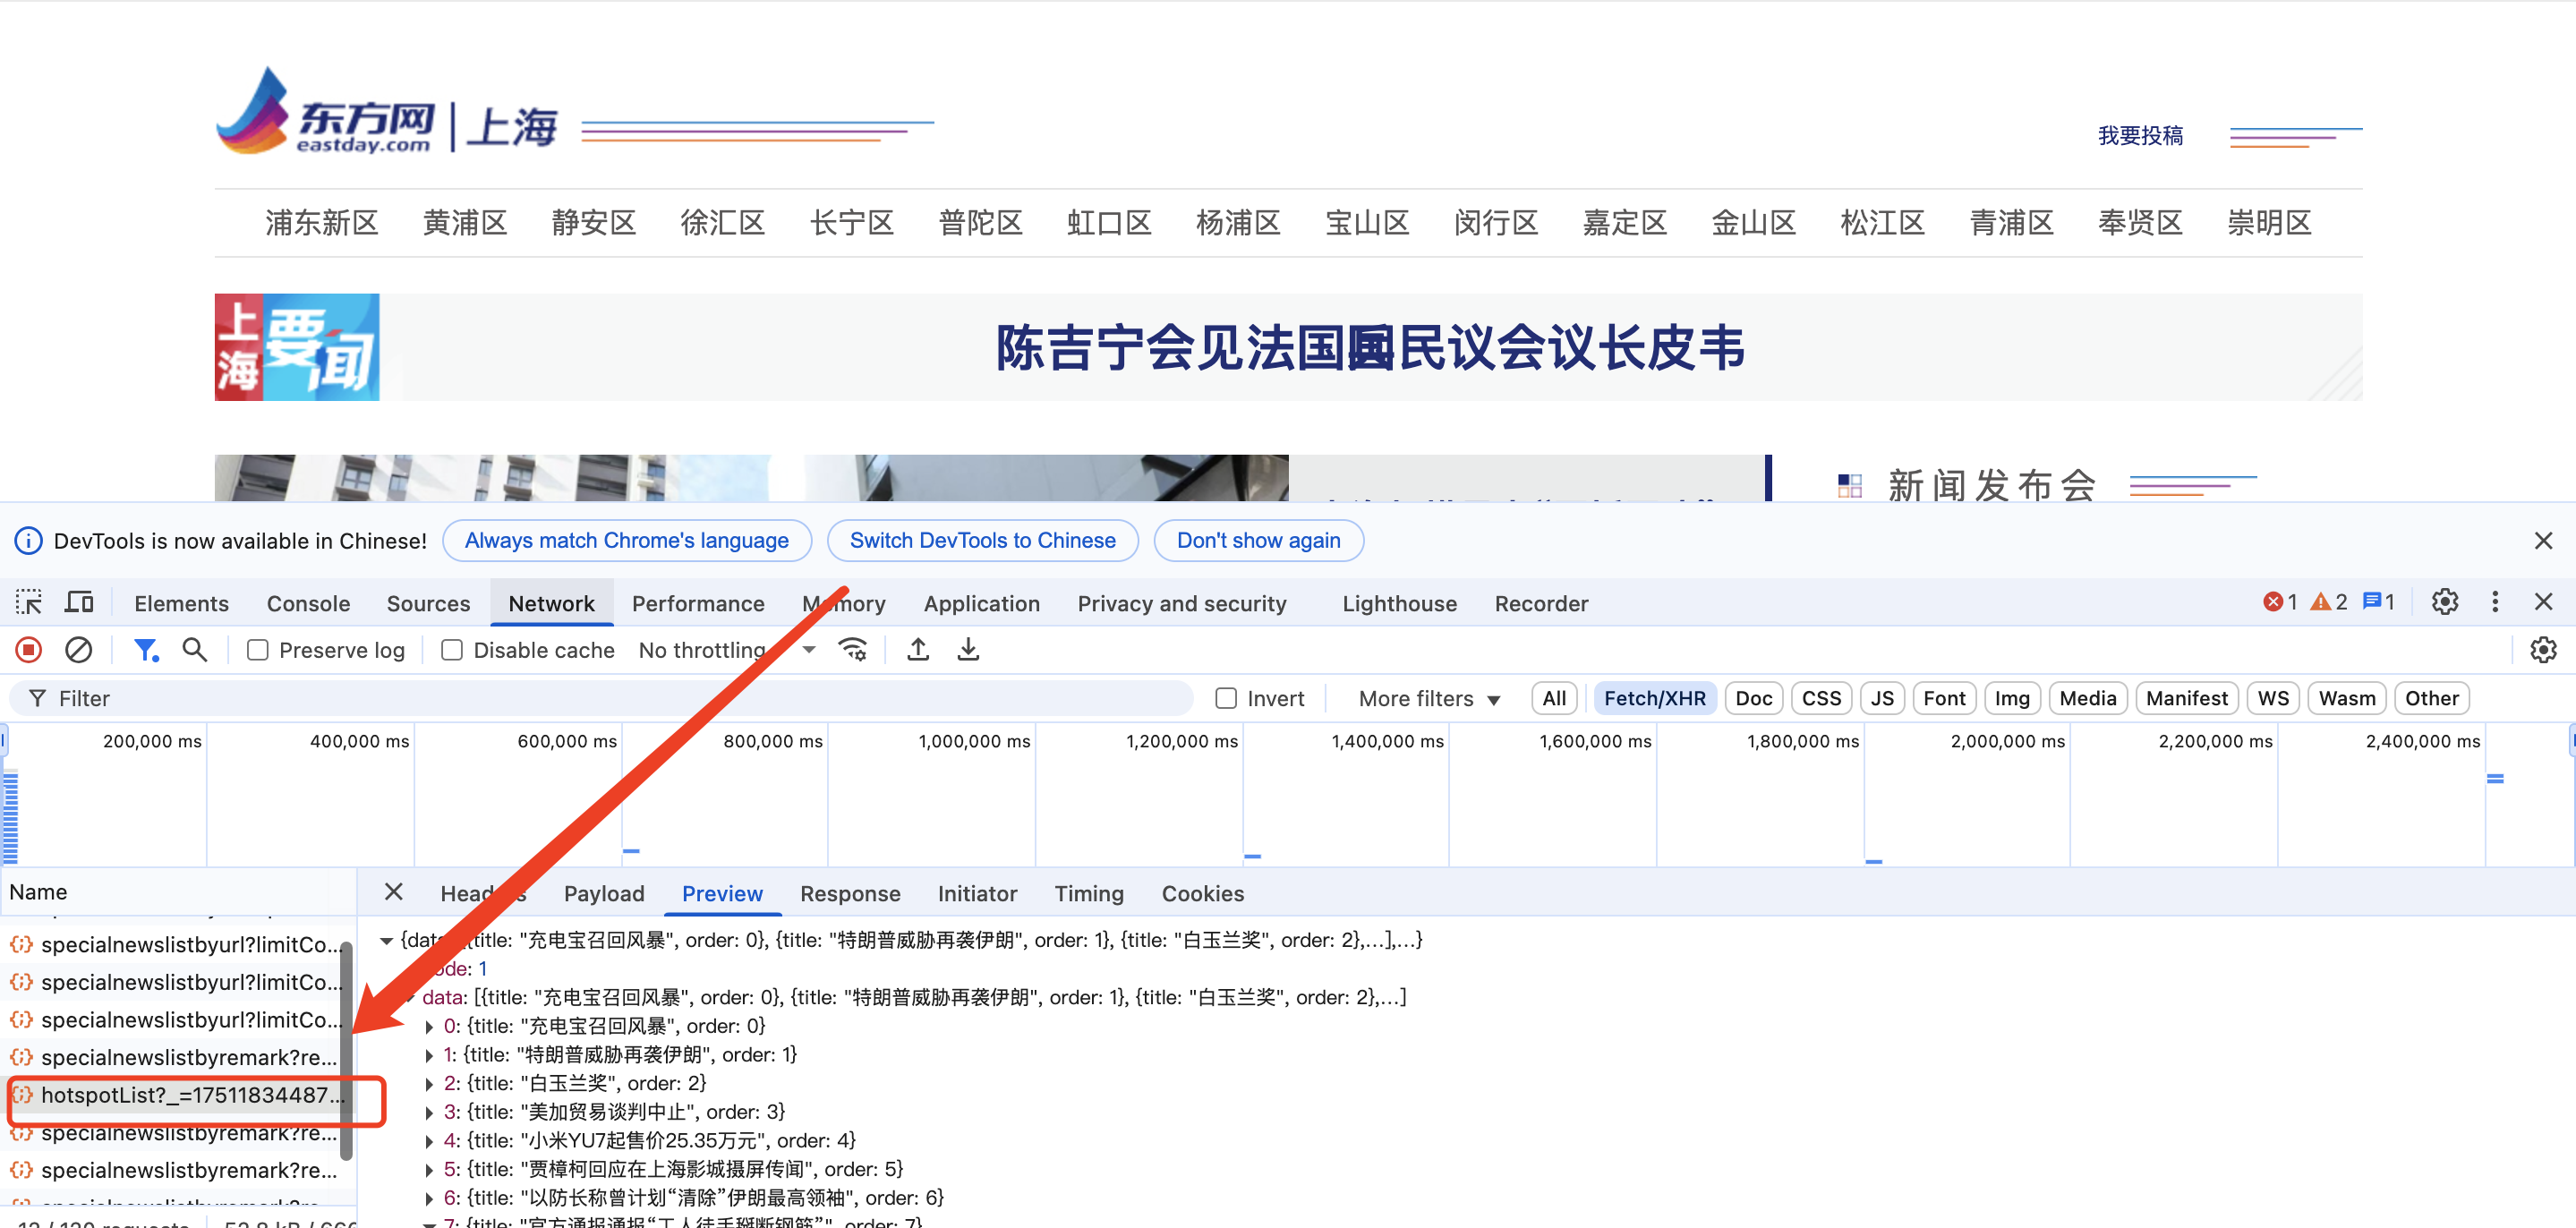
点击【Headers】,找到对应的Requests URL,注意下面的Requests Methods方法是GET,才能用下面的代码进行爬取,post方法的代码不一样,开始不知道为什么爬取失败,找了很多帖子才搞清楚。
get和post区别可以参考下面大佬的帖子:GET和POST方法的区别_get和post请求的区别-CSDN博客
Step3 优化数据
因为爬取的数据前面会带一些无用的数据,所以我们使用json工具进行数据的优化,有两种方法:
- 1、直接使用.json方法一步一步把前面无用的数据去掉。
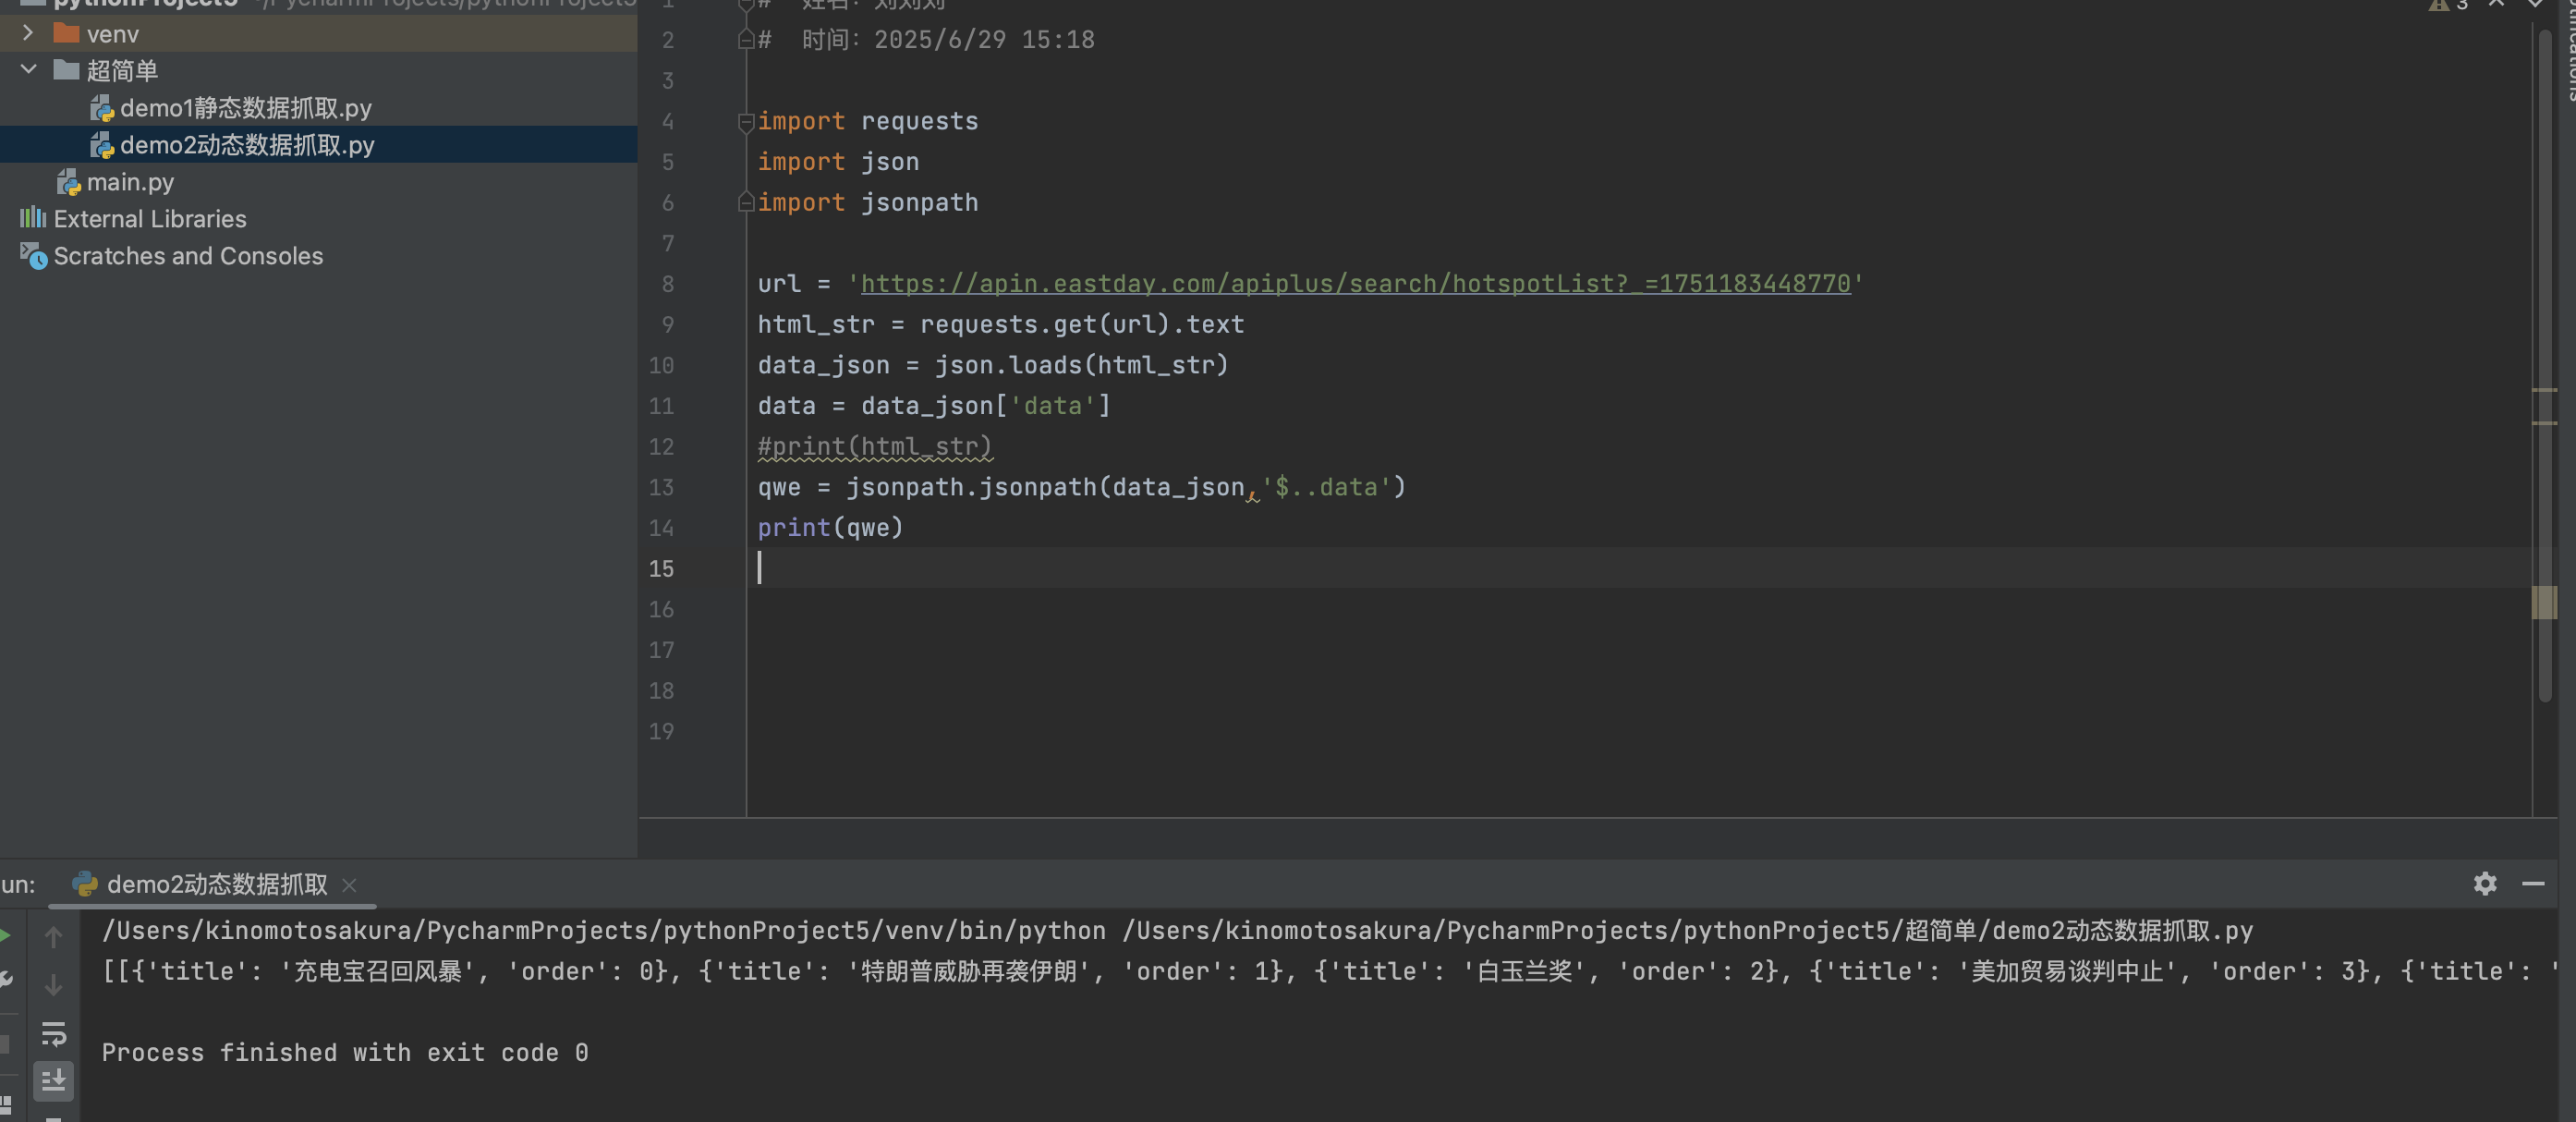
- 2、使用jsonpath工具一次性全部删除。(首先在terminal中用pip install jsonpath工具安装对应的库;然后使用.jsonpath方法进行优化,其中$..data语法的意思是删除data前所有的数据,以此类推。)

最后得到优化后的数据 👇

附上源代码:
import requests import json import jsonpath url = 'https://apin.eastday.com/apiplus/search/hotspotList?_=1751183448770' //找到对应要爬取的url html_str = requests.get(url).text //使用get方法爬get类型网页,使用post方法爬post类型网页 data_json = json.loads(html_str) //使用json方法优化数据 data = data_json['data'] #print(html_str) qwe = jsonpath.jsonpath(data_json,'$..data') //使用jsonpath方法优化数据 print(qwe) //打印数据
* 加密数据判断
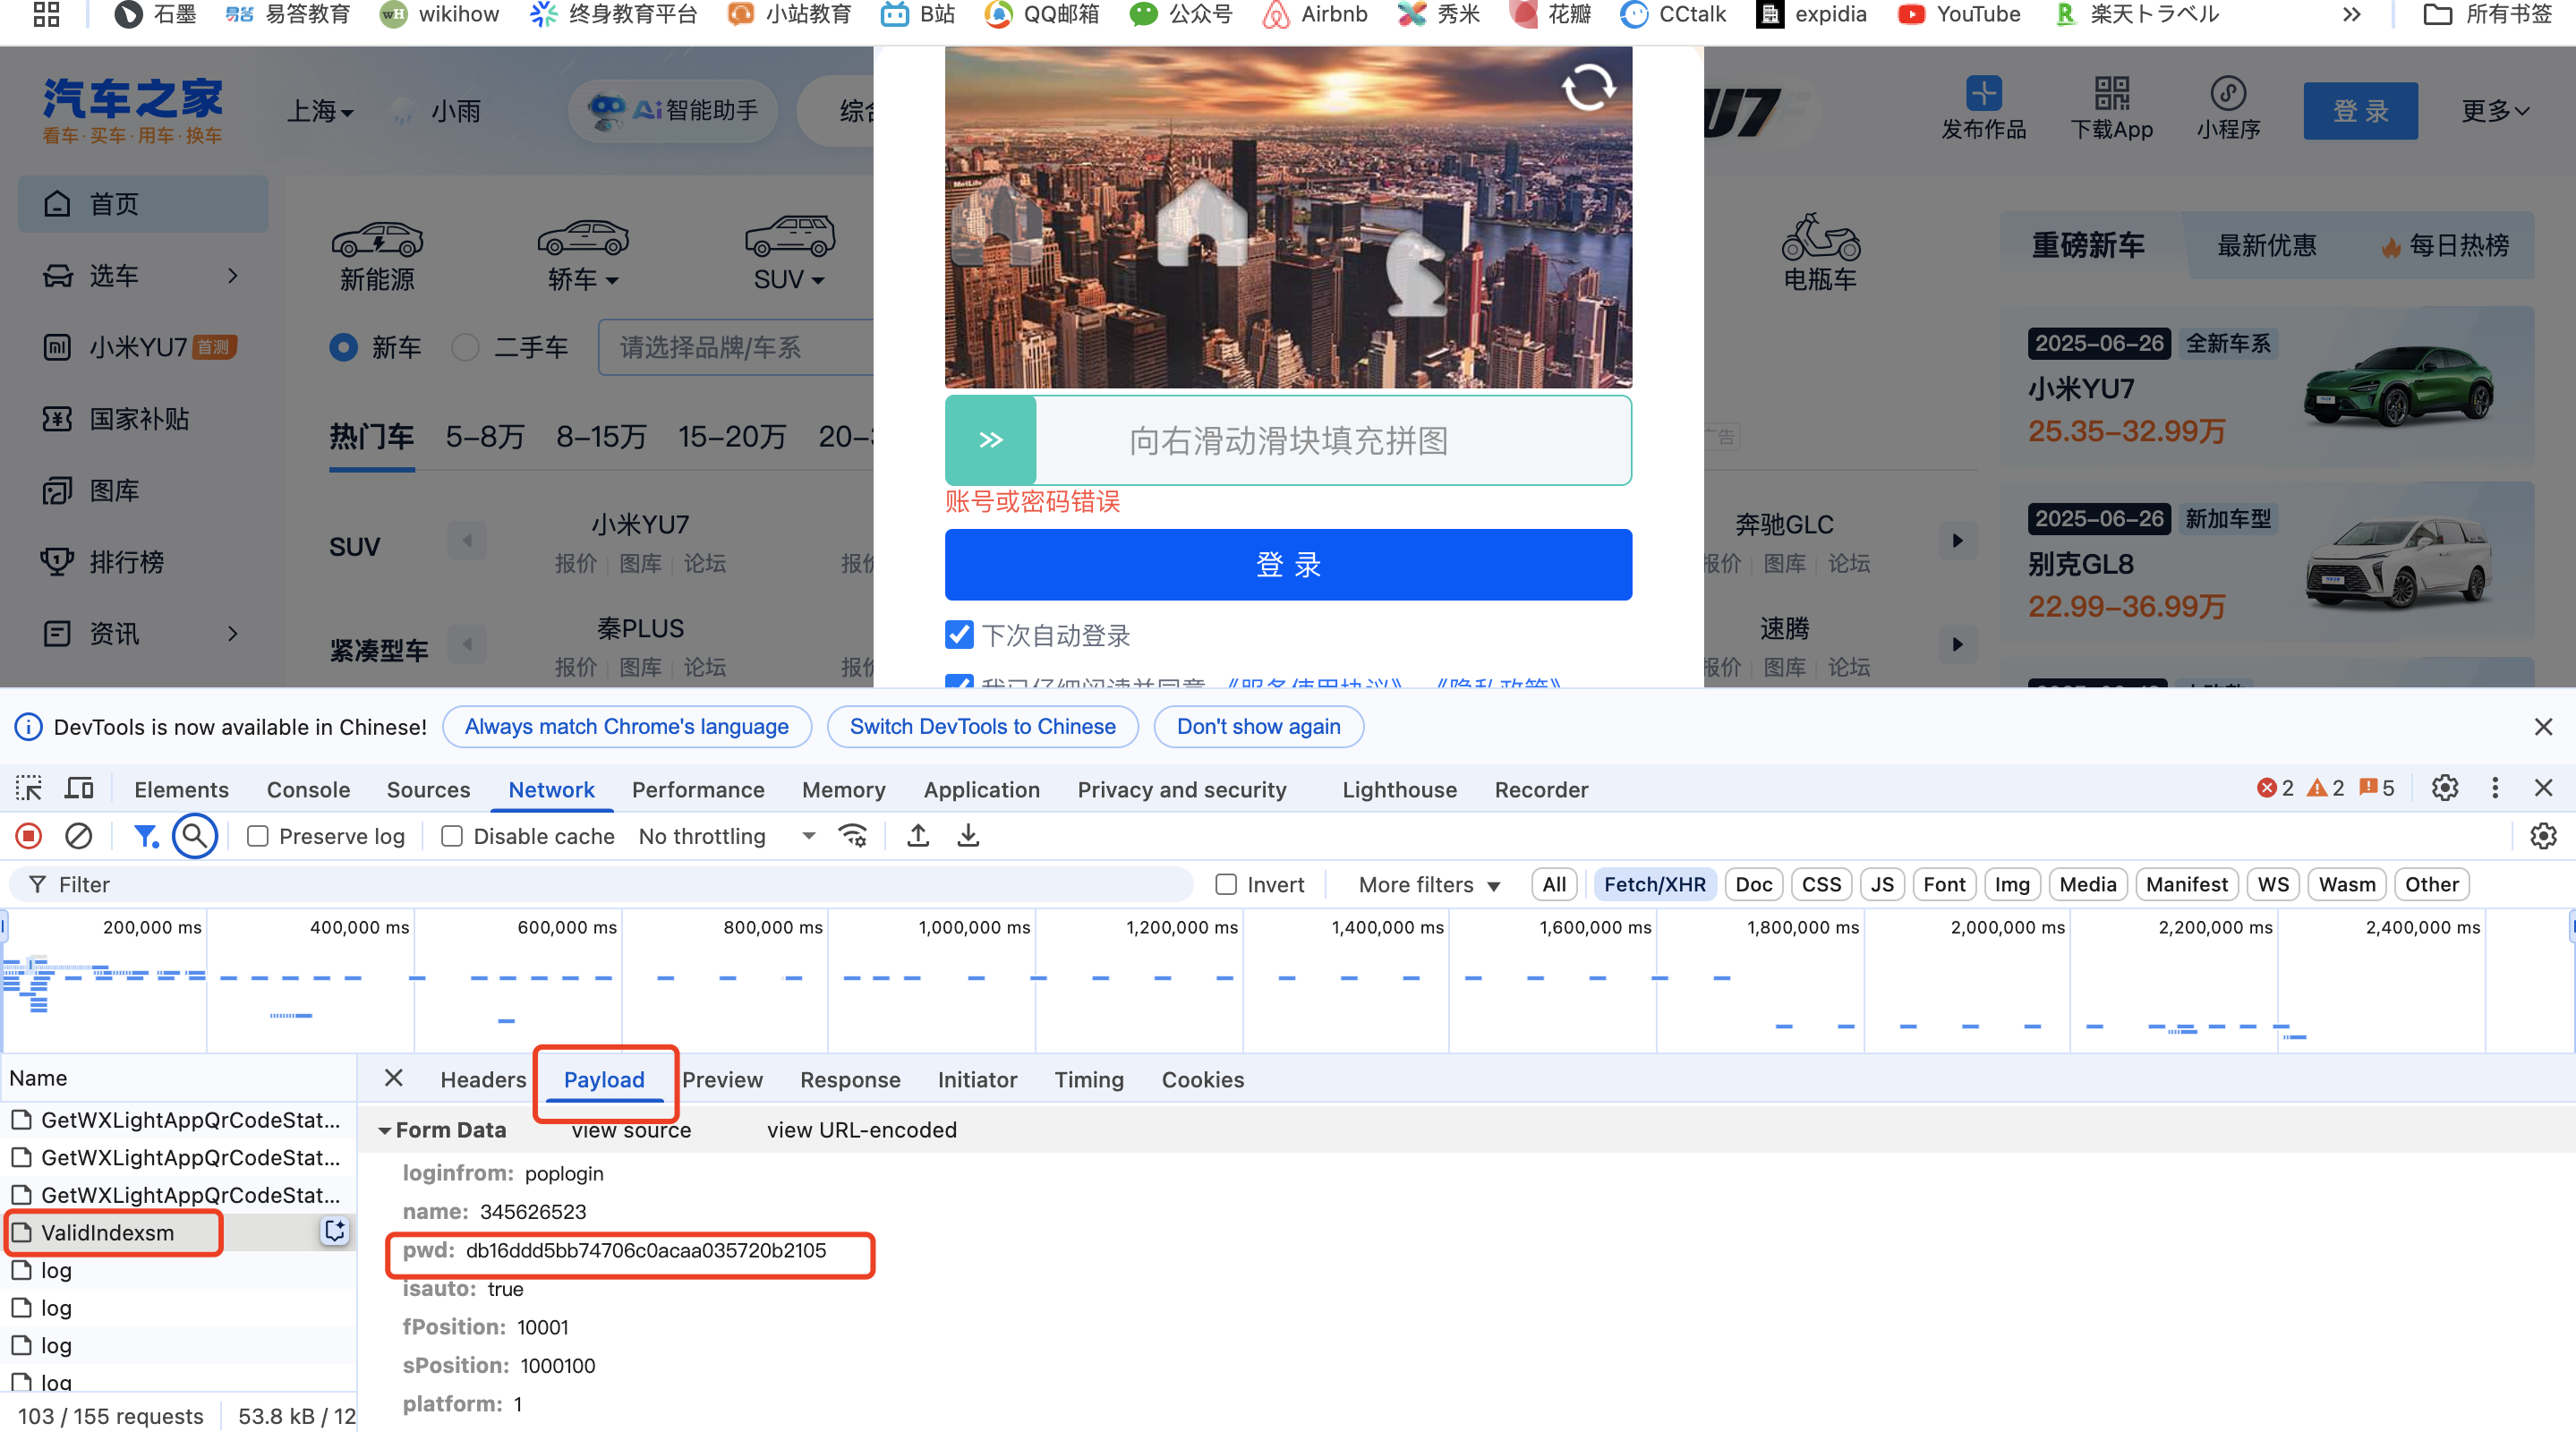
使用网页登陆输入错误密码时,【Network】中会出现【Vaild】的特殊文件,点击右侧【Playload】可以看到数据是被加密过了。
参考课程链接:2、动态数据and加密数据_哔哩哔哩_bilibili
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号