浅析日语OCR的技术原理及其功能特点
原创
浅析日语OCR的技术原理及其功能特点
原创
中科逸视OCR专家
修改于 2025-07-04 08:57:14
修改于 2025-07-04 08:57:14
在全球数字化进程加速的今天,日语作为世界第九大使用语言,其文字处理的自动化需求日益凸显,日语OCR技术应运而生。日语OCR技术是一款基于先进人工智能技术的专业光学字符识别(OCR)解决方案,专门针对日语文本的数字化需求设计开发。能够将纸质文档、图片中的日文内容快速准确地转换为可编辑、可搜索的电子文本,大幅提升日文资料的处理效率。
日语OCR的技术原理
日语OCR技术基于深度学习算法,通过多层神经网络实现对日语文本的自动识别与转换。其核心技术架构主要包括以下几个部分:
1.图像预处理层
采用自适应二值化算法处理不同光照条件下的图像
使用U-Net等网络进行文档图像去噪和增强
基于EAST或CRAFT算法的文本检测定位技术
2.特征提取网络
采用深度卷积神经网络(如ResNet、DenseNet)提取多层次特征
结合注意力机制(如CBAM)增强关键字符特征
针对日语特点设计混合特征提取器(处理汉字、假名混合文本)
3.序列建模层
使用双向LSTM或GRU捕捉字符间上下文关系
Transformer架构在长序列建模中的创新应用
针对日语分词特点的专用序列建模优化
4.解码输出层
基于Connectionist Temporal Classification(CTC)的端到端训练
注意力机制与Transformer解码器的结合应用
结合语言模型(如BERT日语版)的后处理校正
日语OCR技术核心功能
1. 高精度文字识别
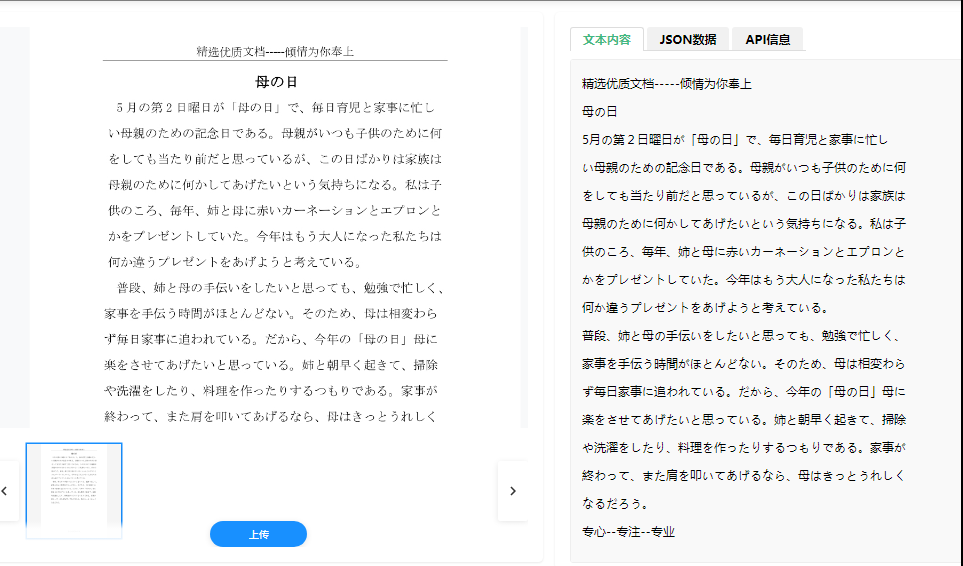
支持汉字(漢字)、平假名(ひらがな)、片假名(カタカナ)混合文本的准确识别
识别准确率高达98%以上,即使是低分辨率或复杂背景的图像也能保持良好表现
特有旧字体识别引擎,可准确识别"勤"(勤)、"勉"(勉)等旧汉字
2. 多样化输入支持
多格式文件处理:JPEG、PNG、PDF、TIFF等常见格式
批量处理能力:支持一次性上传数百份文档自动排队识别
实时摄像头捕捉:移动端可直接拍摄识别日文材料
3.输出与集成
多种导出格式:TXT、DOCX、Excel、PDF等
API接口支持:方便与企业系统集成
应用场景
日语OCR技术在多个领域具有广泛应用价值:
商务办公领域:
日语文档电子化归档(合同、发票等)
名片信息自动提取与管理系统
会议资料实时翻译辅助系统
教育文化领域:
日语教材数字化与在线阅读
古籍文献的电子化保存与研究
日语学习APP中的实时文本识别功能
金融服务领域:
日语金融文档的自动化处理
跨境支付单据的自动识别系统
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号