【转】fielddata内存使用率高问题的排查与处理方法
原创
【转】fielddata内存使用率高问题的排查与处理方法
原创
保持热爱奔赴山海
发布于 2025-06-01 13:41:22
发布于 2025-06-01 13:41:22
如果您在针对_id主键或开启fielddata的text类型字段做排序、聚合查询、脚本查询等操作时,遇到搜索结果返回慢、页面加载延迟等体验问题,可以优先根据本文查看fielddata内存使用情况,如果fielddata内存使用率较高,可以参考本文定位并解决该问题。
背景信息
大量Elasticsearch(ES)集群运维案例显示,fielddata内存使用率越小越好,fielddata不需要占用明显的堆内存。但在Elasticsearch(ES)运维场景中,经常会遇到fielddata内存使用率高,严重时导致整个集群不可用的监控场景。
问题场景
fieldata缓存主要包含field data和global ordinals,占用fielddata的业务场景主要包含:
说明
前两个场景占用fielddata缓存较多,且影响较大,请优先关注。
- 针对
_id主键做排序、agg查询和脚本查询操作。 解决方案:- Elasticsearch官方文档中指出禁止对
_id进行聚合、排序和脚本操作,建议将_id数据复制到开启doc_values的字段进行对应操作。 - Kibana Discover通过
_id查询数据时,下拉提示功能会自动触发聚合。
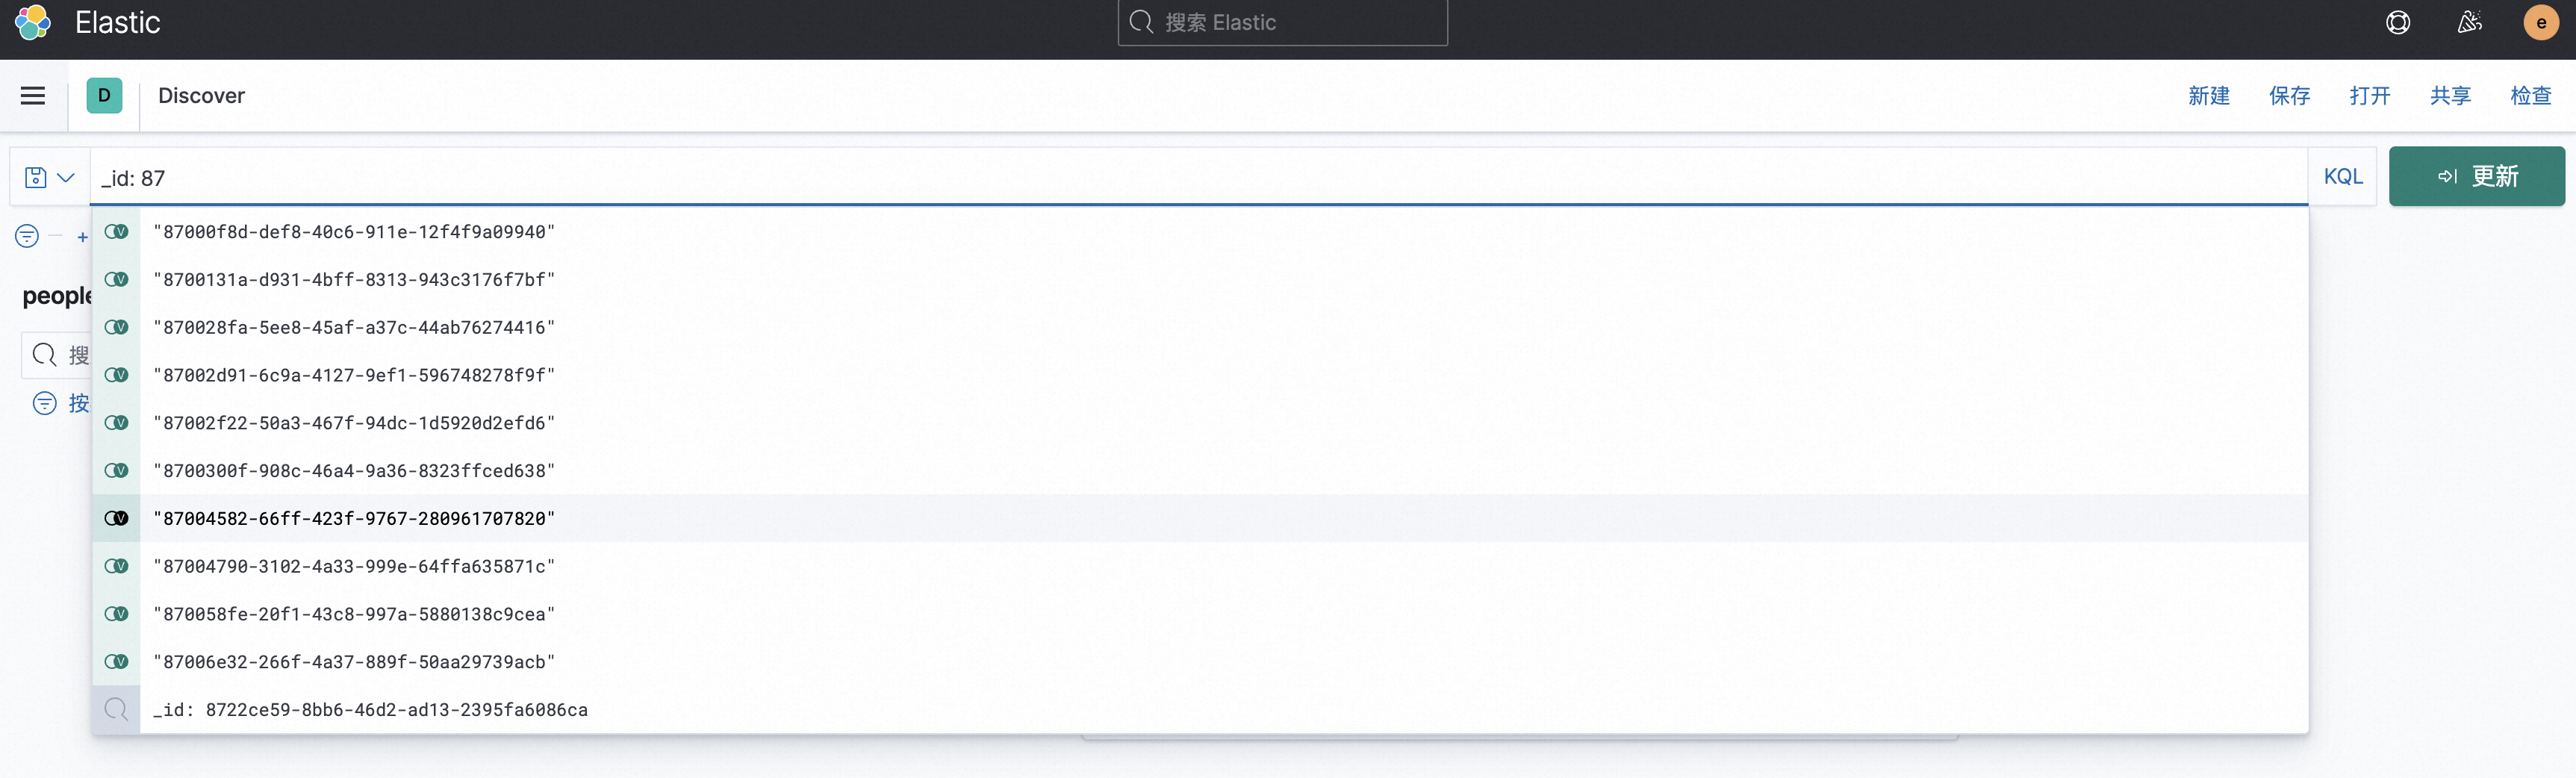 image..png
建议在Kibana > StackManagement > 高级设置中关闭
filterEditor:suggestValues,避免在Kibana中根据主键进行搜索时,执行大量_id字段的聚合分析。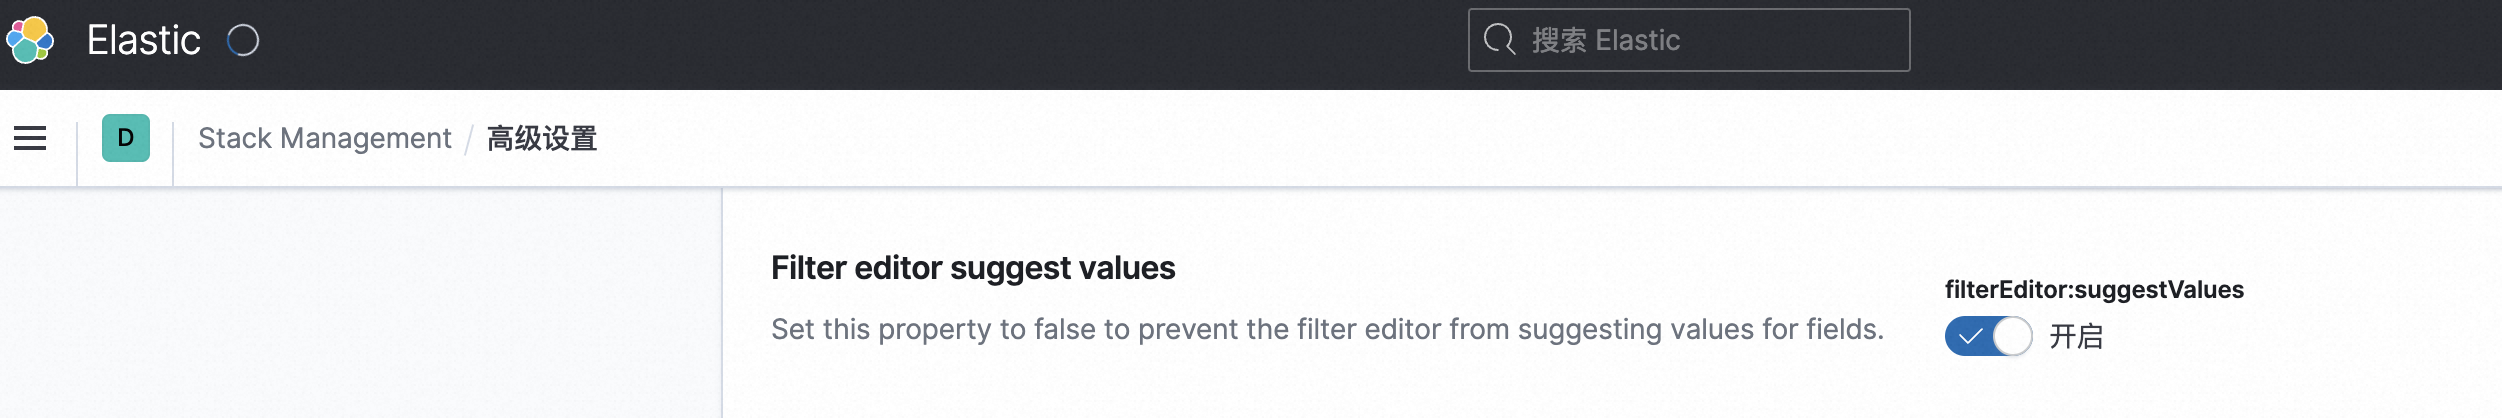 image..png
- Elasticsearch官方文档中指出禁止对
- 对开启fielddata的text类型字段进行聚合、排序和脚本查询操作。 解决方案: text字段默认关闭fielddata,开启后可进行聚合、排序和脚本查询操作。如果加载高基数text字段,fielddata会占用大量的堆内存,并且堆内存占用是永久的,建议将字段类型改成keyword。
- keyword和ip等类型的字段,进行terms aggregations和composite aggregations等查询。
- join字段的parent和child文档aggregations。
问题排查
Grafana监控看板
说明
通过自建的Elasticsearch_exporter 可以监控采集到fielddata内存使用指标。
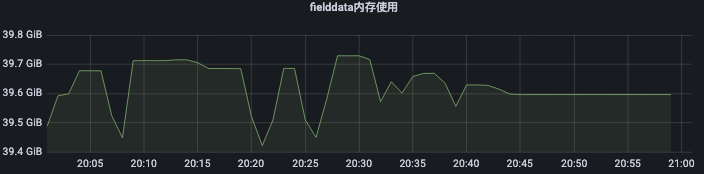
fielddata内存使用指标
fielddata API
- 进入Kibana的Dev tools。
- 在Console页签中,执行以下命令,查看各个节点的fielddata内存占用情况(fielddata.memory_size)。
GET _cat/nodes?v&h=ip,heap.percent,heap.current,heap.max,ram.current,ram.percent,fielddata.memory_size 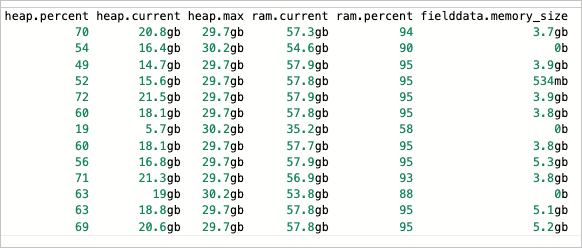
api查看fielddata内存占用
热线程
通过线程分析当前集群正在处理哪类耗时任务,以便聚焦根因定位。
GET _nodes/hot_threads通过以下结果可以看到,热线程正在处理fielddata.ordinals.GlobalOrdinalsBuilder,即在构建全局序数。
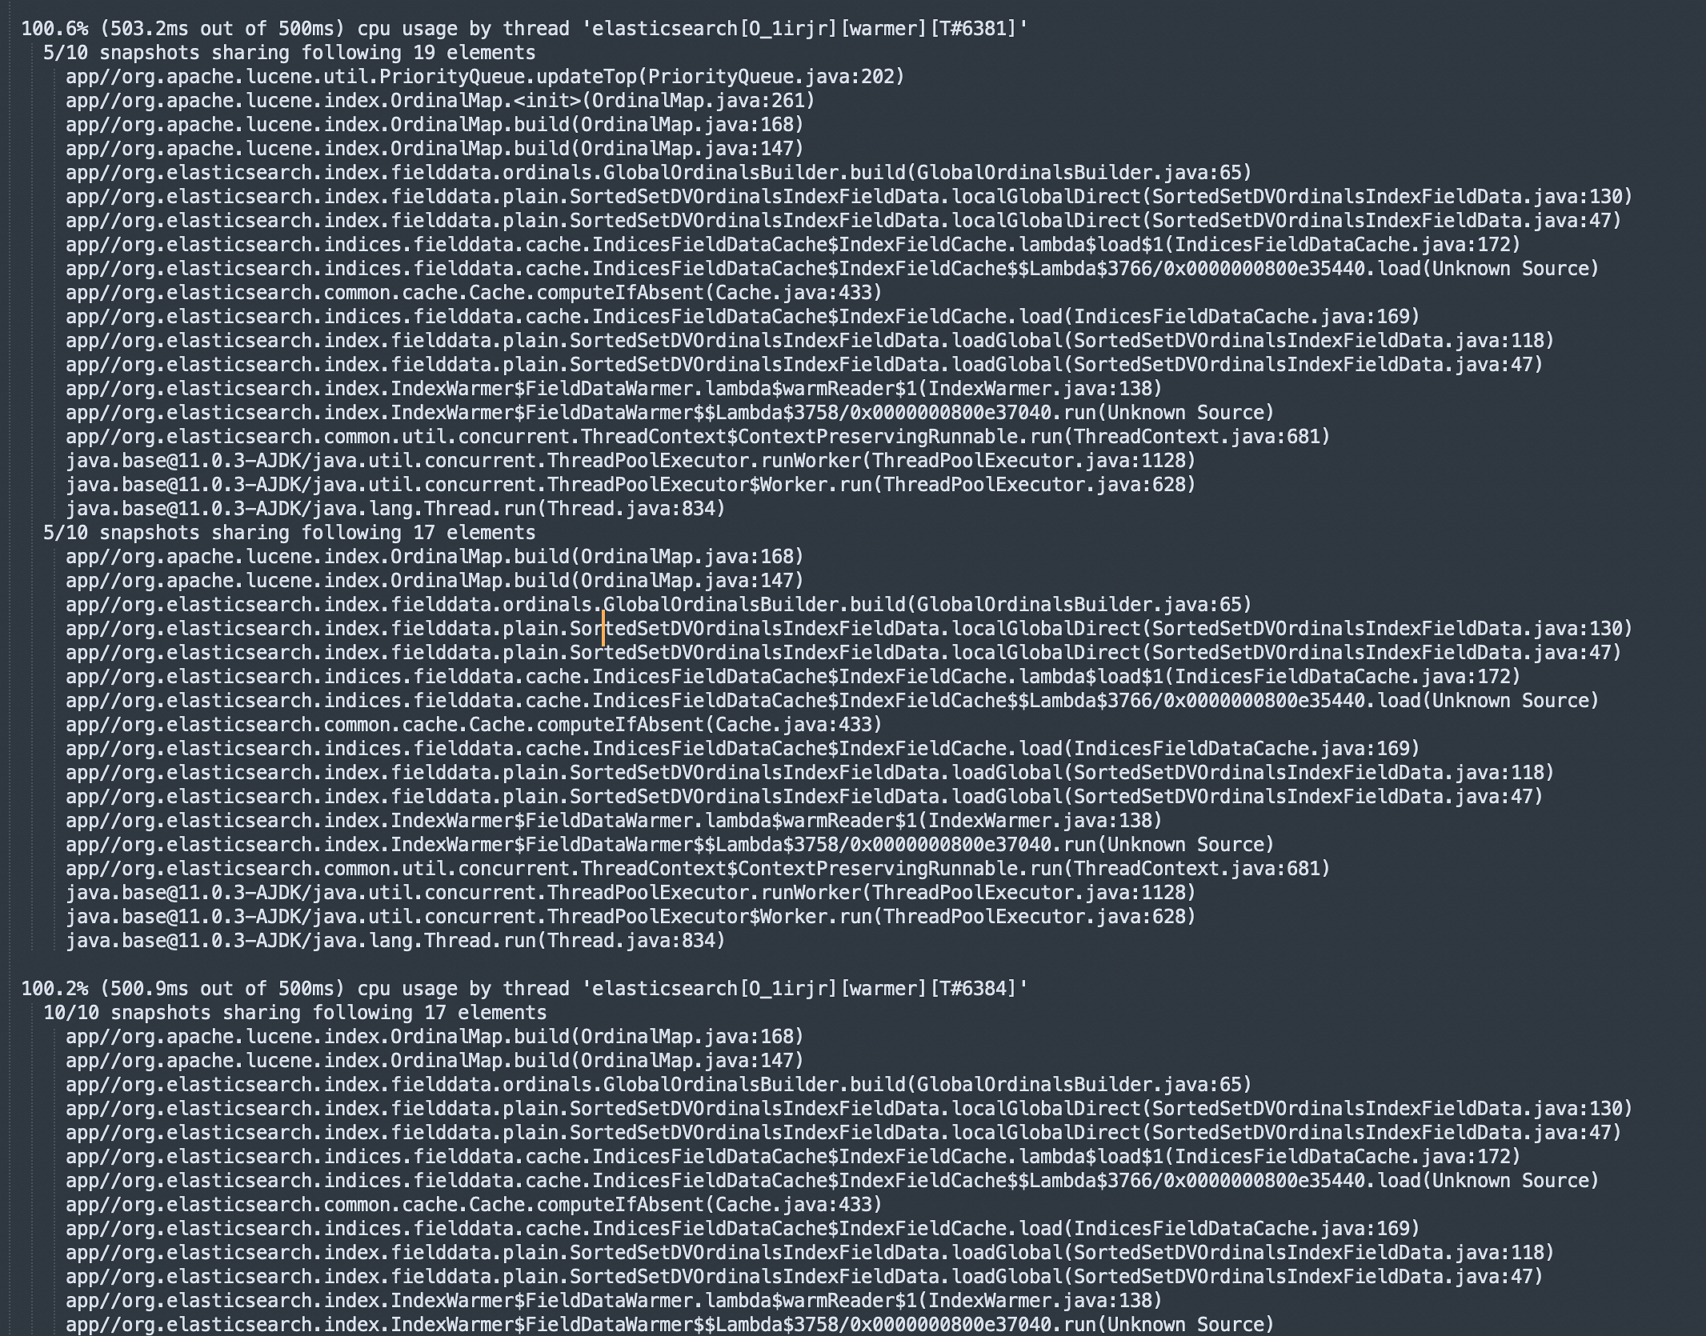
热线程
问题分析
您可以通过fielddata API和日志两种方式,分析导致fielddata内存占用高问题的原因。
fielddata API
执行以下命令,获取占用fielddata内存占用高的字段,分析和业务的哪类查询相关。
GET _cat/fielddata?v&s=size:desc预期结果如下。

fielddata api分析问题
日志聚焦查询
例如以下日志中存在查询时按照_id排序的操作,导致fielddata内存占用高。

日志聚焦查询
解决方案
您可以通过以下方案,临时解决fielddata内存占用高的问题:
- 通过_cache/clear指定fielddata,清理fielddata缓存。如果不指定,将清理所有缓存。
POST _cache/clear?fielddata=true重要:
- 通过API清理缓存是一种临时方案,请结合业务环境评估后操作。该操作会加长查询耗时,消耗额外的计算资源,可能会加重集群服务压力。
- 建议您从业务具体查询角度进行优化,否则即使进行了清理操作,后续查询压力仍可能回升至较高水平。例如,_id的查询场景,建议您新建一个字段,把数据写入新字段,通过新字段做查询。
- 强制重启集群。 说明 因fielddata内存占用高,导致fielddata占用大量的堆内存且集群不可访问时,建议优先选择强制重启集群,恢复集群可访问状态。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号